Ce înseamnă evaluările de pluginuri în Claude Code?
Pe scurt, Claude Code este instrumentul de dezvoltare asistată de inteligență artificială al Anthropic, care le permite programatorilor să interacționeze cu modelele Claude direct din terminal. Pluginurile extind funcționalitatea de bază, permițând integrarea cu alte servicii, automatizări sau fluxuri de lucru personalizate. Până acum, testarea acestor pluginuri era adesea lăsată la latitudinea dezvoltatorilor, fără un cadru standardizat. Noul sistem de evaluare schimbă această paradigmă, oferind o modalitate structurată de a măsura performanța și corectitudinea pluginurilor.
Cele șase tipuri de grader
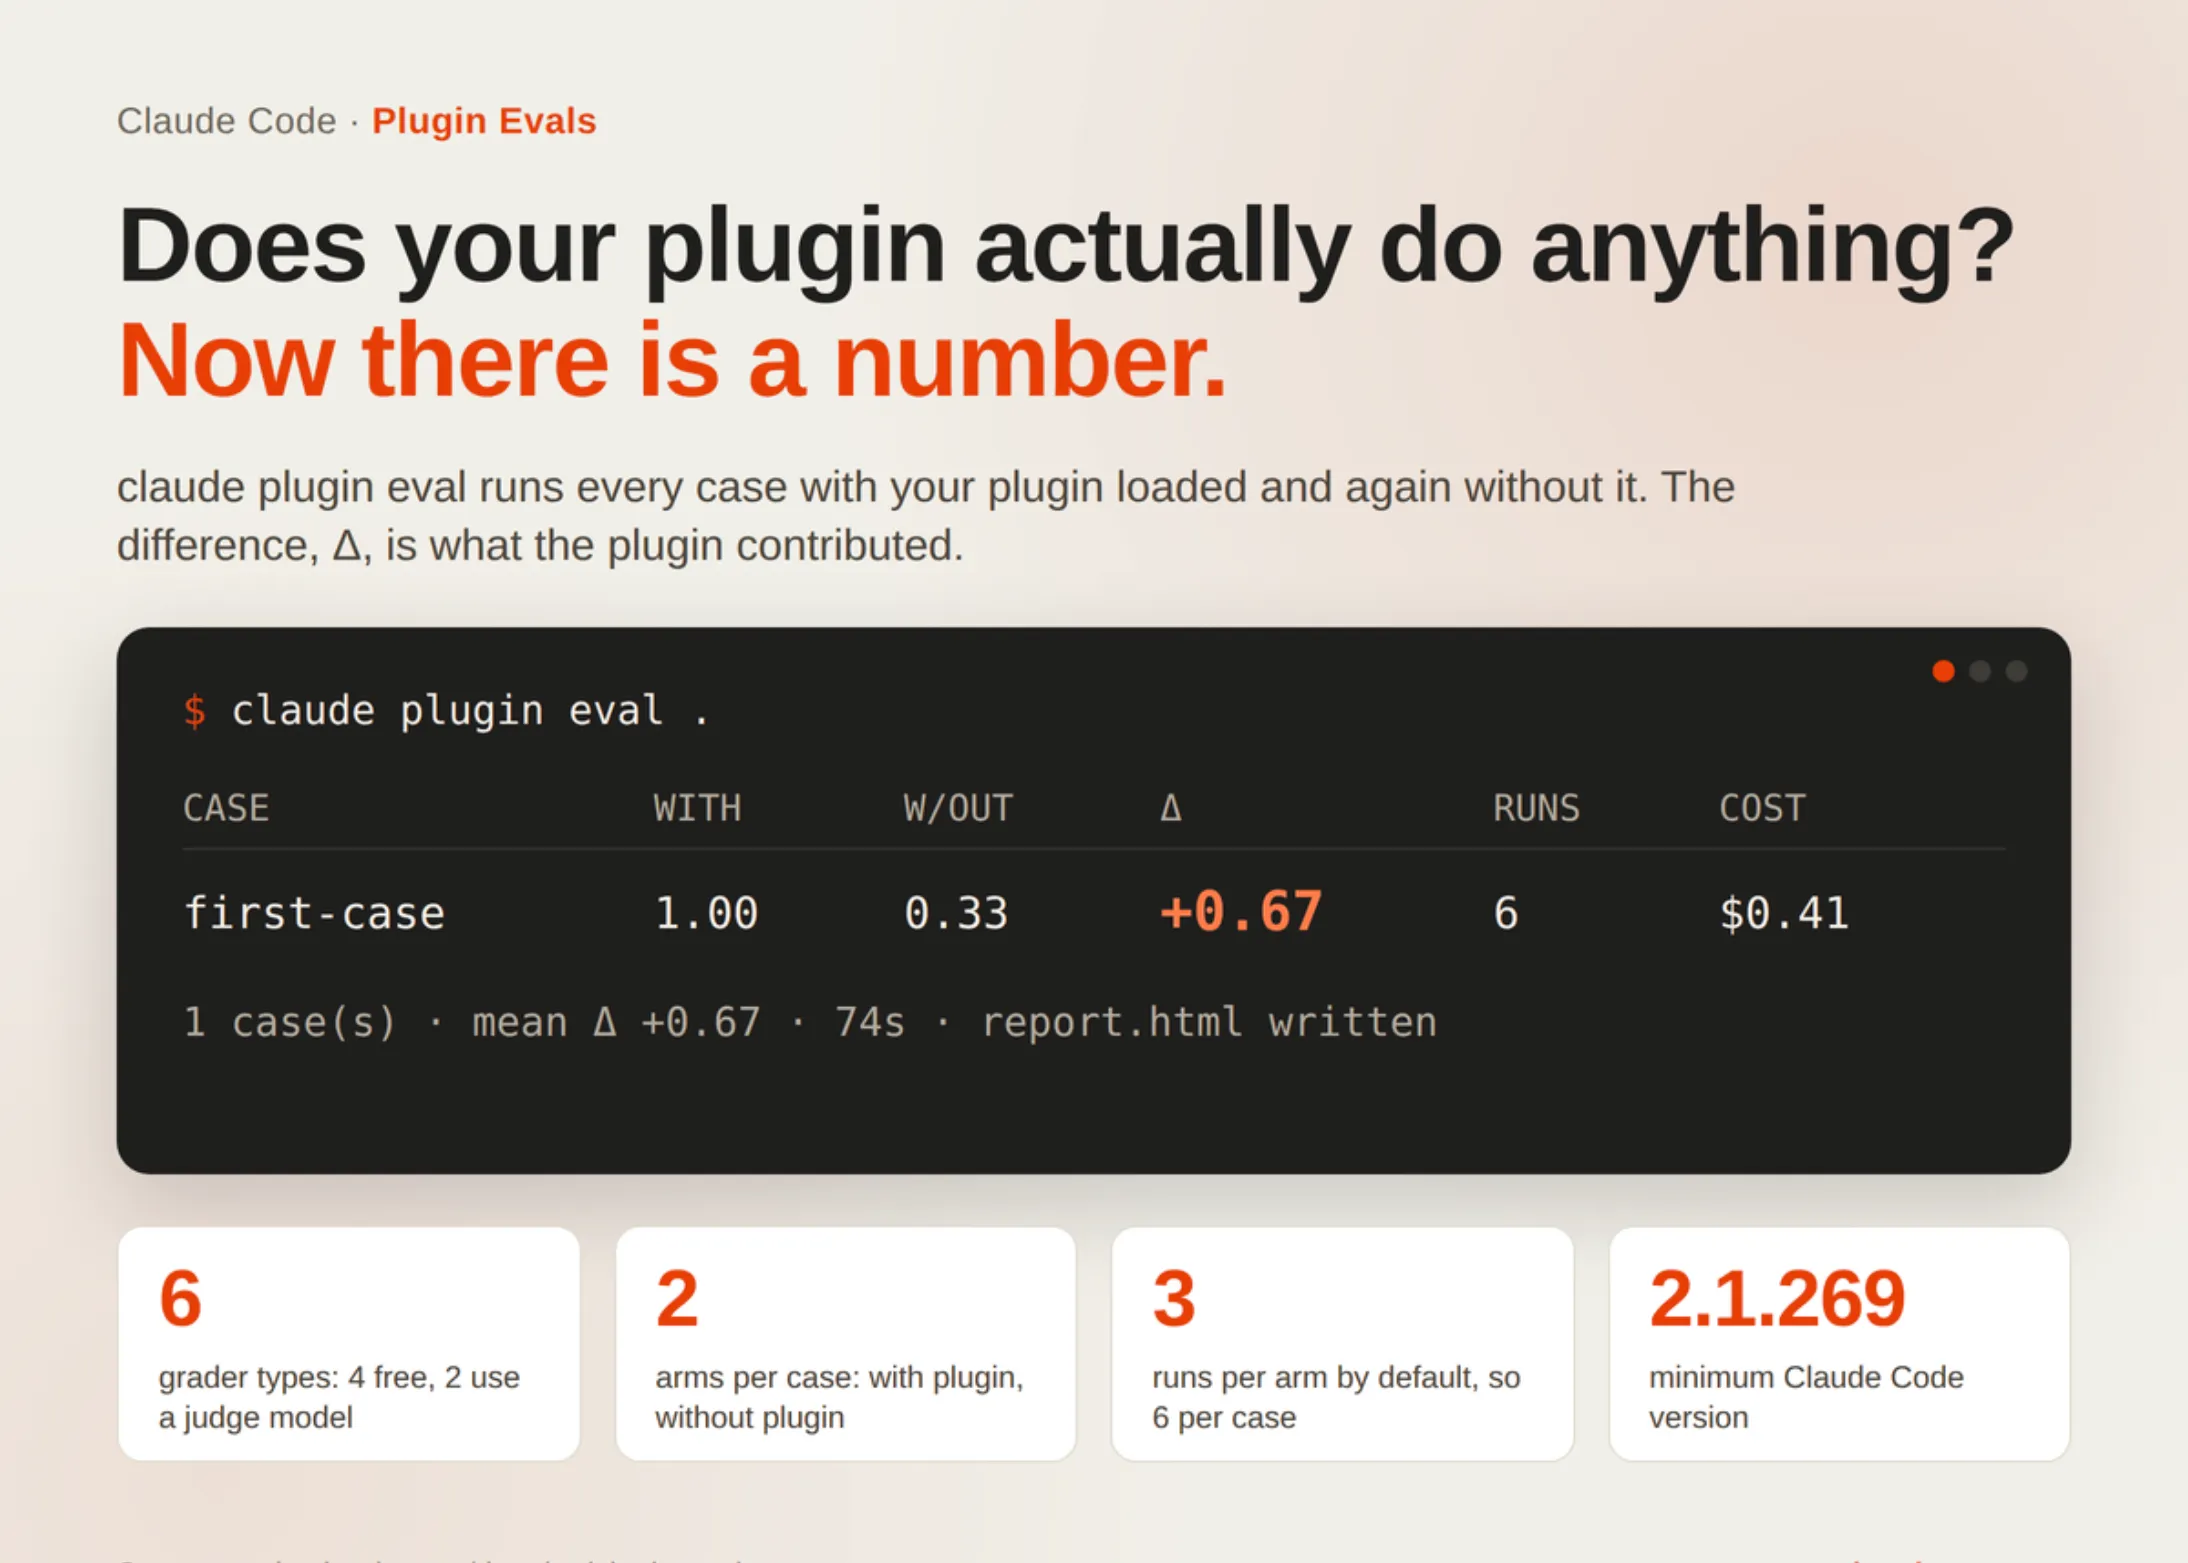
Actualizarea introduce șase tipuri diferite de grader, fiecare proiectat pentru a evalua un aspect specific al comportamentului unui plugin. Deși Anthropic nu a detaliat public fiecare tip în profunzime, putem deduce din practica obișnuită în domeniul evaluării modelelor și agenților:
1. Grader de exactitate textuală – verifică dacă răspunsul generat se potrivește exact cu un răspuns de referință, util pentru sarcini cu ieșiri deterministe.
2. Grader bazat pe modele de limbaj – folosește un model (adesea unul mai puternic) pentru a judeca calitatea răspunsului, similar cu abordările de tip LLM-as-a-judge.
3. Grader de execuție a codului – rulează codul generat de plugin într-un mediu controlat și verifică dacă produce rezultatul așteptat, esențial pentru pluginuri care generează sau modifică cod.
4. Grader de similaritate semantică – măsoară cât de aproape este răspunsul de un răspuns ideal din punct de vedere al sensului, nu al formei.
5. Grader de îndeplinire a sarcinii – verifică dacă pluginul a reușit să îndeplinească o sarcină complexă, pas cu pas, nu doar rezultatul final.
6. Grader de robustețe – testează pluginul cu intrări neașteptate sau adversarial, pentru a vedea dacă se comportă corect în condiții dificile.
Aceste tipuri acoperă o gamă largă de scenarii, de la verificări simple la evaluări complexe, oferind dezvoltatorilor flexibilitatea de a alege metoda potrivită pentru nevoile lor.
Baseline-ul fără plugin – un punct de referință crucial
Un aspect interesant al acestei actualizări este includerea unui baseline care nu folosește niciun plugin. Acest lucru este important pentru că oferă un punct de comparație: dacă un plugin nu aduce o îmbunătățire semnificativă față de comportamentul implicit al lui Claude Code, atunci valoarea sa este discutabilă. Dezvoltatorii pot rula evaluări atât cu pluginul activ, cât și fără el, și pot compara scorurile. Astfel, se elimină subiectivitatea și se iau decizii bazate pe date concrete.
Poarta CI pentru abilități
Probabil cea mai așteptată funcție este integrarea cu sistemele de integrare continuă. În loc să rulezi evaluări manual, de fiecare dată când modifici un plugin, poți configura o „poartă” (gate) în pipeline-ul tău CI. Aceasta înseamnă că, atunci când faci un push sau un pull request, evaluările rulează automat. Dacă scorurile nu ating un prag prestabilit, build-ul eșuează, iar modificările nu sunt acceptate. Acest mecanism aduce disciplină în procesul de dezvoltare și previne regresii.
De ce contează pentru dezvoltatori
Pentru cei care construiesc pluginuri pentru Claude Code, această actualizare este un pas major spre maturitate. În loc să te bazezi pe teste ad-hoc sau pe „merge și vezi”, ai acum un cadru formal de evaluare. Poți demonstra clienților sau echipei tale că pluginul tău funcționează corect, cu dovezi obiective. Mai mult, poți automatiza procesul de asigurare a calității, economisind timp prețios.
De asemenea, pentru comunitatea open-source, aceste evaluări pot deveni un standard de facto. Dacă un plugin are scoruri bune pe un set de evaluări publice, utilizatorii vor avea mai multă încredere în el. Acest lucru poate duce la un ecosistem mai sănătos, în care pluginurile de calitate sunt recompensate, iar cele slabe sunt rapid identificate.
Cum funcționează în practică?
Deși detaliile tehnice exacte nu au fost încă publicate integral, se poate presupune că dezvoltatorii definesc un set de evaluări într-un fișier de configurare, specifică tipul de grader pentru fiecare, și apoi rulează comanda de evaluare. Rezultatele sunt afișate într-un format ușor de citit, iar integrarea CI se face prin intermediul unor variabile de mediu sau al unor fișiere de configurare specifice. Flexibilitatea este cheia: poți avea evaluări simple pentru pluginuri mici și evaluări complexe pentru cele care manipulează date sensibile sau execută cod.
Limitări și considerații
Desigur, niciun sistem de evaluare nu este perfect. Grader-urile bazate pe modele de limbaj pot fi influențate de bias-urile modelului, iar cele de execuție a codului necesită un mediu sigur și izolat. De asemenea, alegerea pragurilor pentru CI poate fi dificilă – prea stricte și vei bloca dezvoltarea, prea permisive și vei lăsa să treacă probleme. Anthropic pare conștient de aceste provocări, oferind mai multe tipuri de grader pentru a acoperi cât mai multe scenarii.
Ce urmează?
Această actualizare vine într-un moment în care competiția în domeniul agenților AI este acerbă. OpenAI, Google și alții își dezvoltă propriile instrumente, iar Anthropic încearcă să se diferențieze prin atenția acordată calității și testării. Este probabil ca în lunile următoare să vedem mai multe documentații, exemple și poate chiar un marketplace de pluginuri cu scoruri publice de evaluare. Până atunci, dezvoltatorii pot începe să experimenteze cu aceste evaluări și să-și îmbunătățească pluginurile.
Concluzie
Adăugarea evaluărilor de pluginuri în Claude Code este o mișcare inteligentă din partea Anthropic. Nu doar că oferă instrumente utile dezvoltatorilor, dar stabilește și un standard pentru calitate într-un domeniu încă tânăr. Cu șase tipuri de grader, un baseline clar și integrare CI, dezvoltatorii au acum tot ce le trebuie pentru a construi pluginuri robuste și de încredere. Dacă lucrezi cu Claude Code, este momentul să explorezi aceste funcții și să le integrezi în fluxul tău de lucru.
De ce este important:
Această actualizare marchează o maturizare a ecosistemului Claude Code, oferind dezvoltatorilor un cadru formal pentru testarea pluginurilor. Automatizarea evaluărilor în CI reduce erorile umane și asigură că doar pluginurile care îndeplinesc standarde clare ajung în producție. Pentru comunitatea AI, aceasta este o dovadă că instrumentele de dezvoltare bazate pe agenți devin din ce în ce mai profesioniste, iar calitatea devine o prioritate. Este un pas important spre adoptarea pe scară largă a agenților AI în fluxurile de lucru reale.