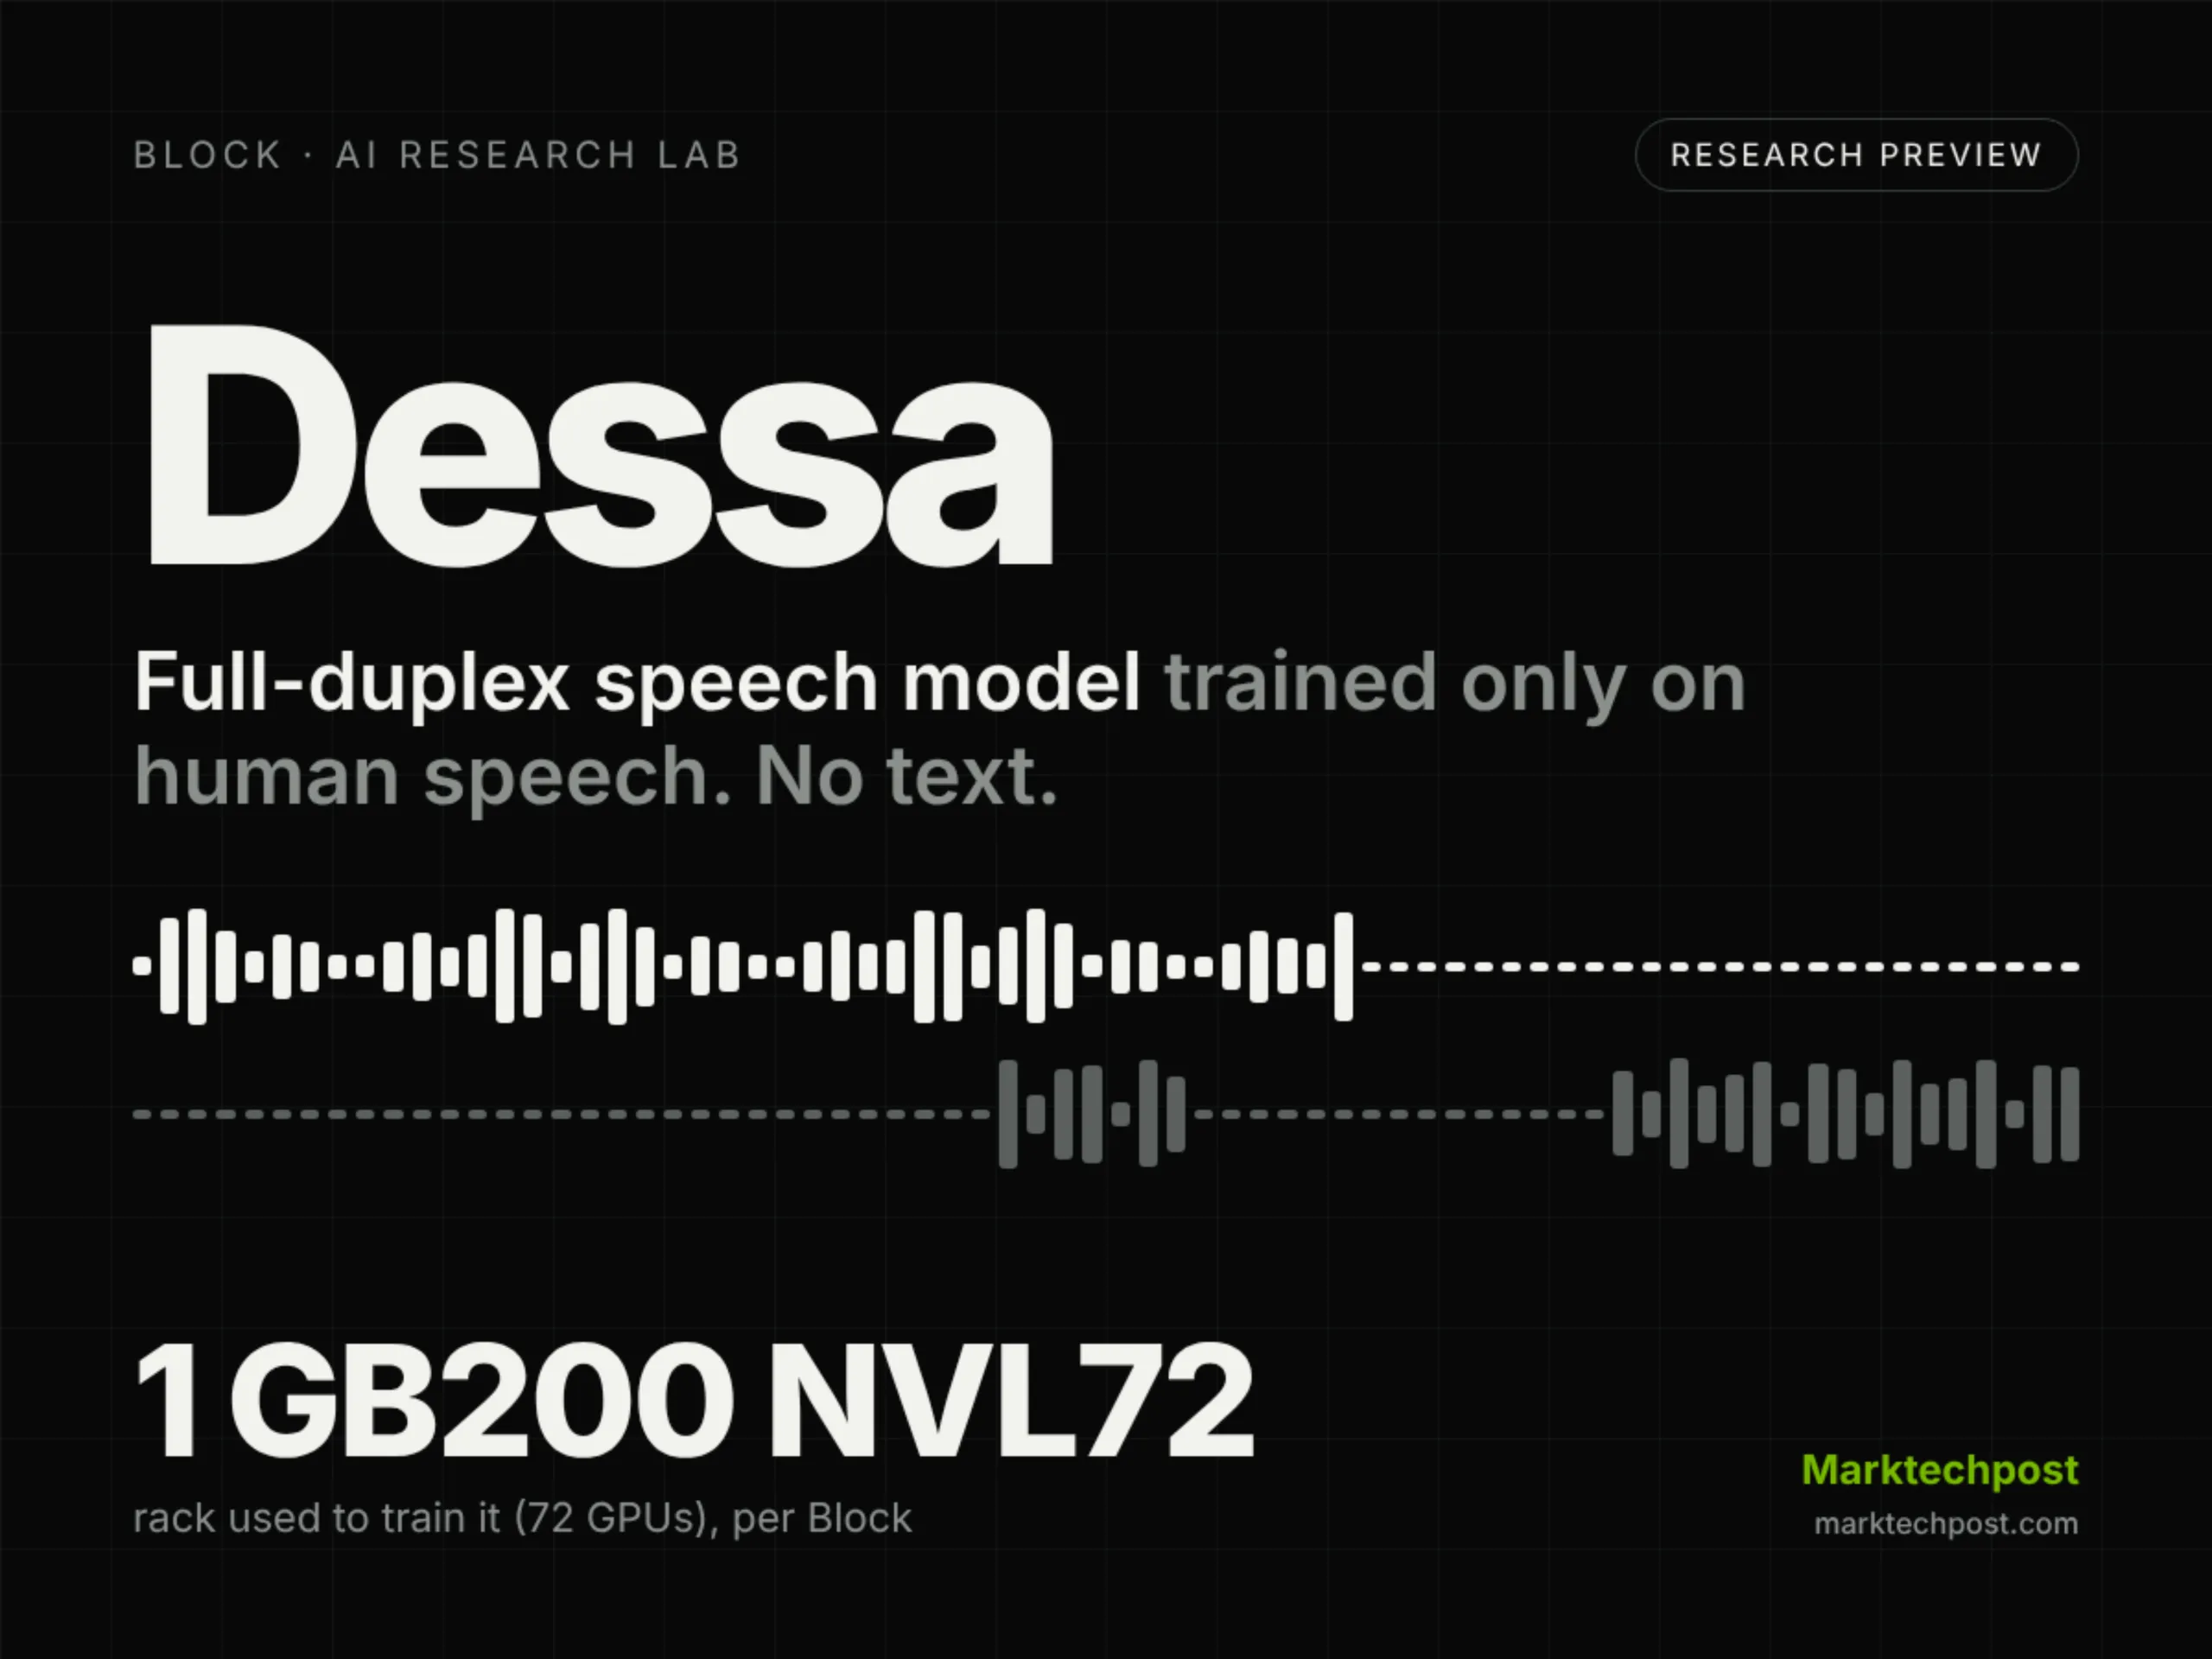
Aceasta nu este o simplă optimizare incrementală. Este o schimbare de paradigă care adresază una dintre cele mai persistente și frustrante limitări ale asistenților vocali actuali: latența și natura rigida a schimbului de replici "push-to-talk". În prezent, chiar și cele mai avansate agenți vocali, inclusiv Modulul Vocal Avansat al lui GPT-4o sau Gemini Live, funcționează pe un principiu turn-based camuflat sub o interfață fluidă. Utilizatorul vorbește, sistemul ascultă, procesează, generează un răspuns textuel, îl transformă în audio și apoi îl redă. Orice încercare de a întrerupe, de a schimba subiectul brusc sau de a face un backchannel (acele "m-hm", "da", "înțeleg" care lubrifiază conversația umană) sparge acest ciclu.
Dessa promite să elimine acest gât de știrbei. Prin antrenament direct pe formele de undă audio, modelul învață nu doar semnificația cuvintelor, ci prosodia, ritmul, pauzele de respirație, timbrul emoțional și, crucial, coregrafia subtilă a întreruperilor și a vorbirii simultane. Aceasta este esența comunicării full-duplex: capacitatea de a asculta și vorbi în același timp, de a reacționa la un semnal vocal al interlocutorului în milisecunde, de a ceda parola sau de o preia natural, fără comutatori software expliciți.
Arhitectura: Speech-to-Speech pur, fără tokenizare text
Detaliile tehnice publicate de echipa de cercetare a Block indică o abordare radical diferită de tokenizare. Modelele convenționale convertesc audio în tokeni discreți (adesea prin codeci neuronali precum EnCodec sau SoundStream) și apoi tratează problema ca pe una de modelare a limbajului, similar cu textul. Dessa pare să adopte o reprezentare continuă sau o tokenizare specializată care păstrează informația acustică fină — micro-intonatia, șoaptul, râsul, hesitația — care se pierde în pipeline-urile text-centrice.
Antrenamentul "doar pe speech" (speech-only training) implică o cantitate masivă de date audio neetichetate sau slab etichetate: podcast-uri, interviuri, conversații telefonice, înregistrări de ședințe, poate chiar date din rețeaua propriu-zisă a Block (Cash App, Square) anonimizate. Modelul trebuie să învețe singur structura conversației: cine vorbește când, cum se semnalează schimbarea de subiect, cum se exprimă acordul sau dezacordul non-verbal. Este o formă de învățare auto-supervizată la scară largă, similară cu cum modelele LLM învață gramatică și rațiocinio din text brut, dar aplicată domeniului temporal și acustic.
De ce full-duplex contează acum mai mult ca oricând
Industria se află la un punct de infliecție. Agienții AI (AI Agents) devin ubișchuiți: fac rezervări, negociază facturi, scriu cod, analizează date. Dar interfața vocală rămâne punctul slab. Un agent care nu poate fi întrerupt când utilizatorul observă o greșeală, care nu poate auzi un "oprire!" în timp real, care nu poate ajusta tonul pe baza stării emoționale detectate din vocea utilizatorului în timp ce generează propriul răspuns, este un agent limitat la task-uri simple, scriptate.
Full-duplex real deschide porțile către:
Contextul competițional: OpenAI, Google, Kyutai, Hume
Lansarea Dessa nu are loc în vid. Mai 2024, OpenAI a demonstrat Modulul Vocal Avansat pentru GPT-4o, impresionând prin latență redusă și capacitate de întrerupere, dar rămânând, la nivel arhitectural, un sistem cascadă optimizat. Google a urmat cu Gemini Live. Kyutai, laboratorul francez finanțat de Xavier Niel, Rodolphe Saadé și Eric Schmidt, a lansat Moshi, un model open-weight full-duplex de 7B parametri, antrenat de asemenea speech-to-speech, marcând o primă majoră în open source. Hume AI a pus accent pe inteligența emoțională (EVI - Empathic Voice Interface).
Dessa se diferențiază prin proveniența sa: Block nu este un laborator de cercetare pur, ci o companie de produse financiare masive (Square, Cash App, Tidal, TBD). Aceasta sugerează o traiectorie rapidă spre producție. Imaginați-vă un Cash App Agent care vă ajută să contestați o tranzacție frauduloasă, să negociați o taxă sau să planificați un buget, conversând natural, întreruptându-vă când aveți o idee nouă, înțelegând stresul din vocea dumneavoastră. Sau un sistem POS pentru micile afaceri care primește comenzi vocale de la clienți în timp ce casierul gestionează plata, fără a opri fluxul.
Provocările neînaintate: Siguranță, Hallucinații Audio, Bias
Antrenamentul end-to-end pe audio aduce riscuri unice. Hallucinațiile nu mai sunt doar propoziții gramatical corecte dar false; pot fi sunete care par cuvinte, fragmente de voce clonată accidental, artefacte acustice interpretate ca semnificație. Lipșa unui stadiu explicit de text face mai greu auditul, controlul conținutului, filtrarea PII (informații personale identificabile) sau aplicarea guardrail-urilor de siguranță. Cum oprești modelul să genereze discurs de ură dacă nu ai un classifier de text pe ieșire? Cum garanți conformitatea GDPR/CCPA dacă vocea utilizatorului este procesată continuu, fără o tranșcripție stocată temporar?
Block trebuie să demonstreze că a rezolvat aceste probleme nu doar la nivel de demo, ci la scară de producție enterprise. Faptul că au ales să lanseze modelul (probabil ca open-weight sau API) sugerează încredere în robustețe, dar comunitatea de securitate AI va testa limitele intensiv.
Impactul pe ecosistemul open source și dezvoltatori
Dacă Block urmează modelul Kyutai (Moshi) și publicează greutățile (weights) și codul de inferență, Dessa devine un catalizator masiv pentru inovația open source în Voice AI. Dezvoltatorii pot fine-tuna modelul pentru dialecte specifice, termeni medicali, limbi sub-reprezentate (inclusiv română), scenarii de call-center, jocuri video cu NPC-uri conversaționale realiste. Eliminarea dependenței de ASR/TTS extern reduce costurile, latența și punctele de eșec.
De asemenea, apare o nouă categorie de tooling: instrumente de evaluare a calității conversaționale (nu doar WER - Word Error Rate), benchmarks de full-duplex (turn-taking accuracy, interruption handling, backchannel appropriateness), framework-uri de deployment pe edge (mobile, embedded) pentru inferență locală, privată, offline.
Concluzie: Începutul erii "Speech-Native" AI
Dessa nu este doar un alt model. Este o declarație de intenții: viitorul AI conversațional nu este textului care vorbește, ci vorbirii care gândește. Block, prin poziția sa unică la intersecția fintech, consumer tech și infrastructură deschisă, are șanse reale să transforme această demonstrație tehnologică în utilitate zilnică pentru milioane de utilizatori și afaceri.
Pe măsură ce modelele devin "speech-native", granița dintre interfață și inteligență dispare. Vocea devine nu un canal de intrare/ieșire, ci mediul propriu al gândirii mașinii. Aceasta este schimbarea care va defini următorul deceniu de interacțiune om-calculator.
De ce este important:
Dessa reprezintă prima implementare la scară largă a unui model speech-to-speech full-duplex antrenat end-to-end doar pe audio, eliminând pipeline-ul clasic ASR-LLM-TTS. Aceasta reduce drastic latența, permite întreruperi naturale, backchannel-uri și o conversație autentică duplex, esențiale pentru agenții AI viitori din fintech, sănătate, robotică și asistență personală. Lanzarea de către Block (Square/Cash App) semnalizează o maturizare rapidă spre producție, cu impact major pe ecosistemul open source și standardele noi de evaluare a AI-ului vocal.