
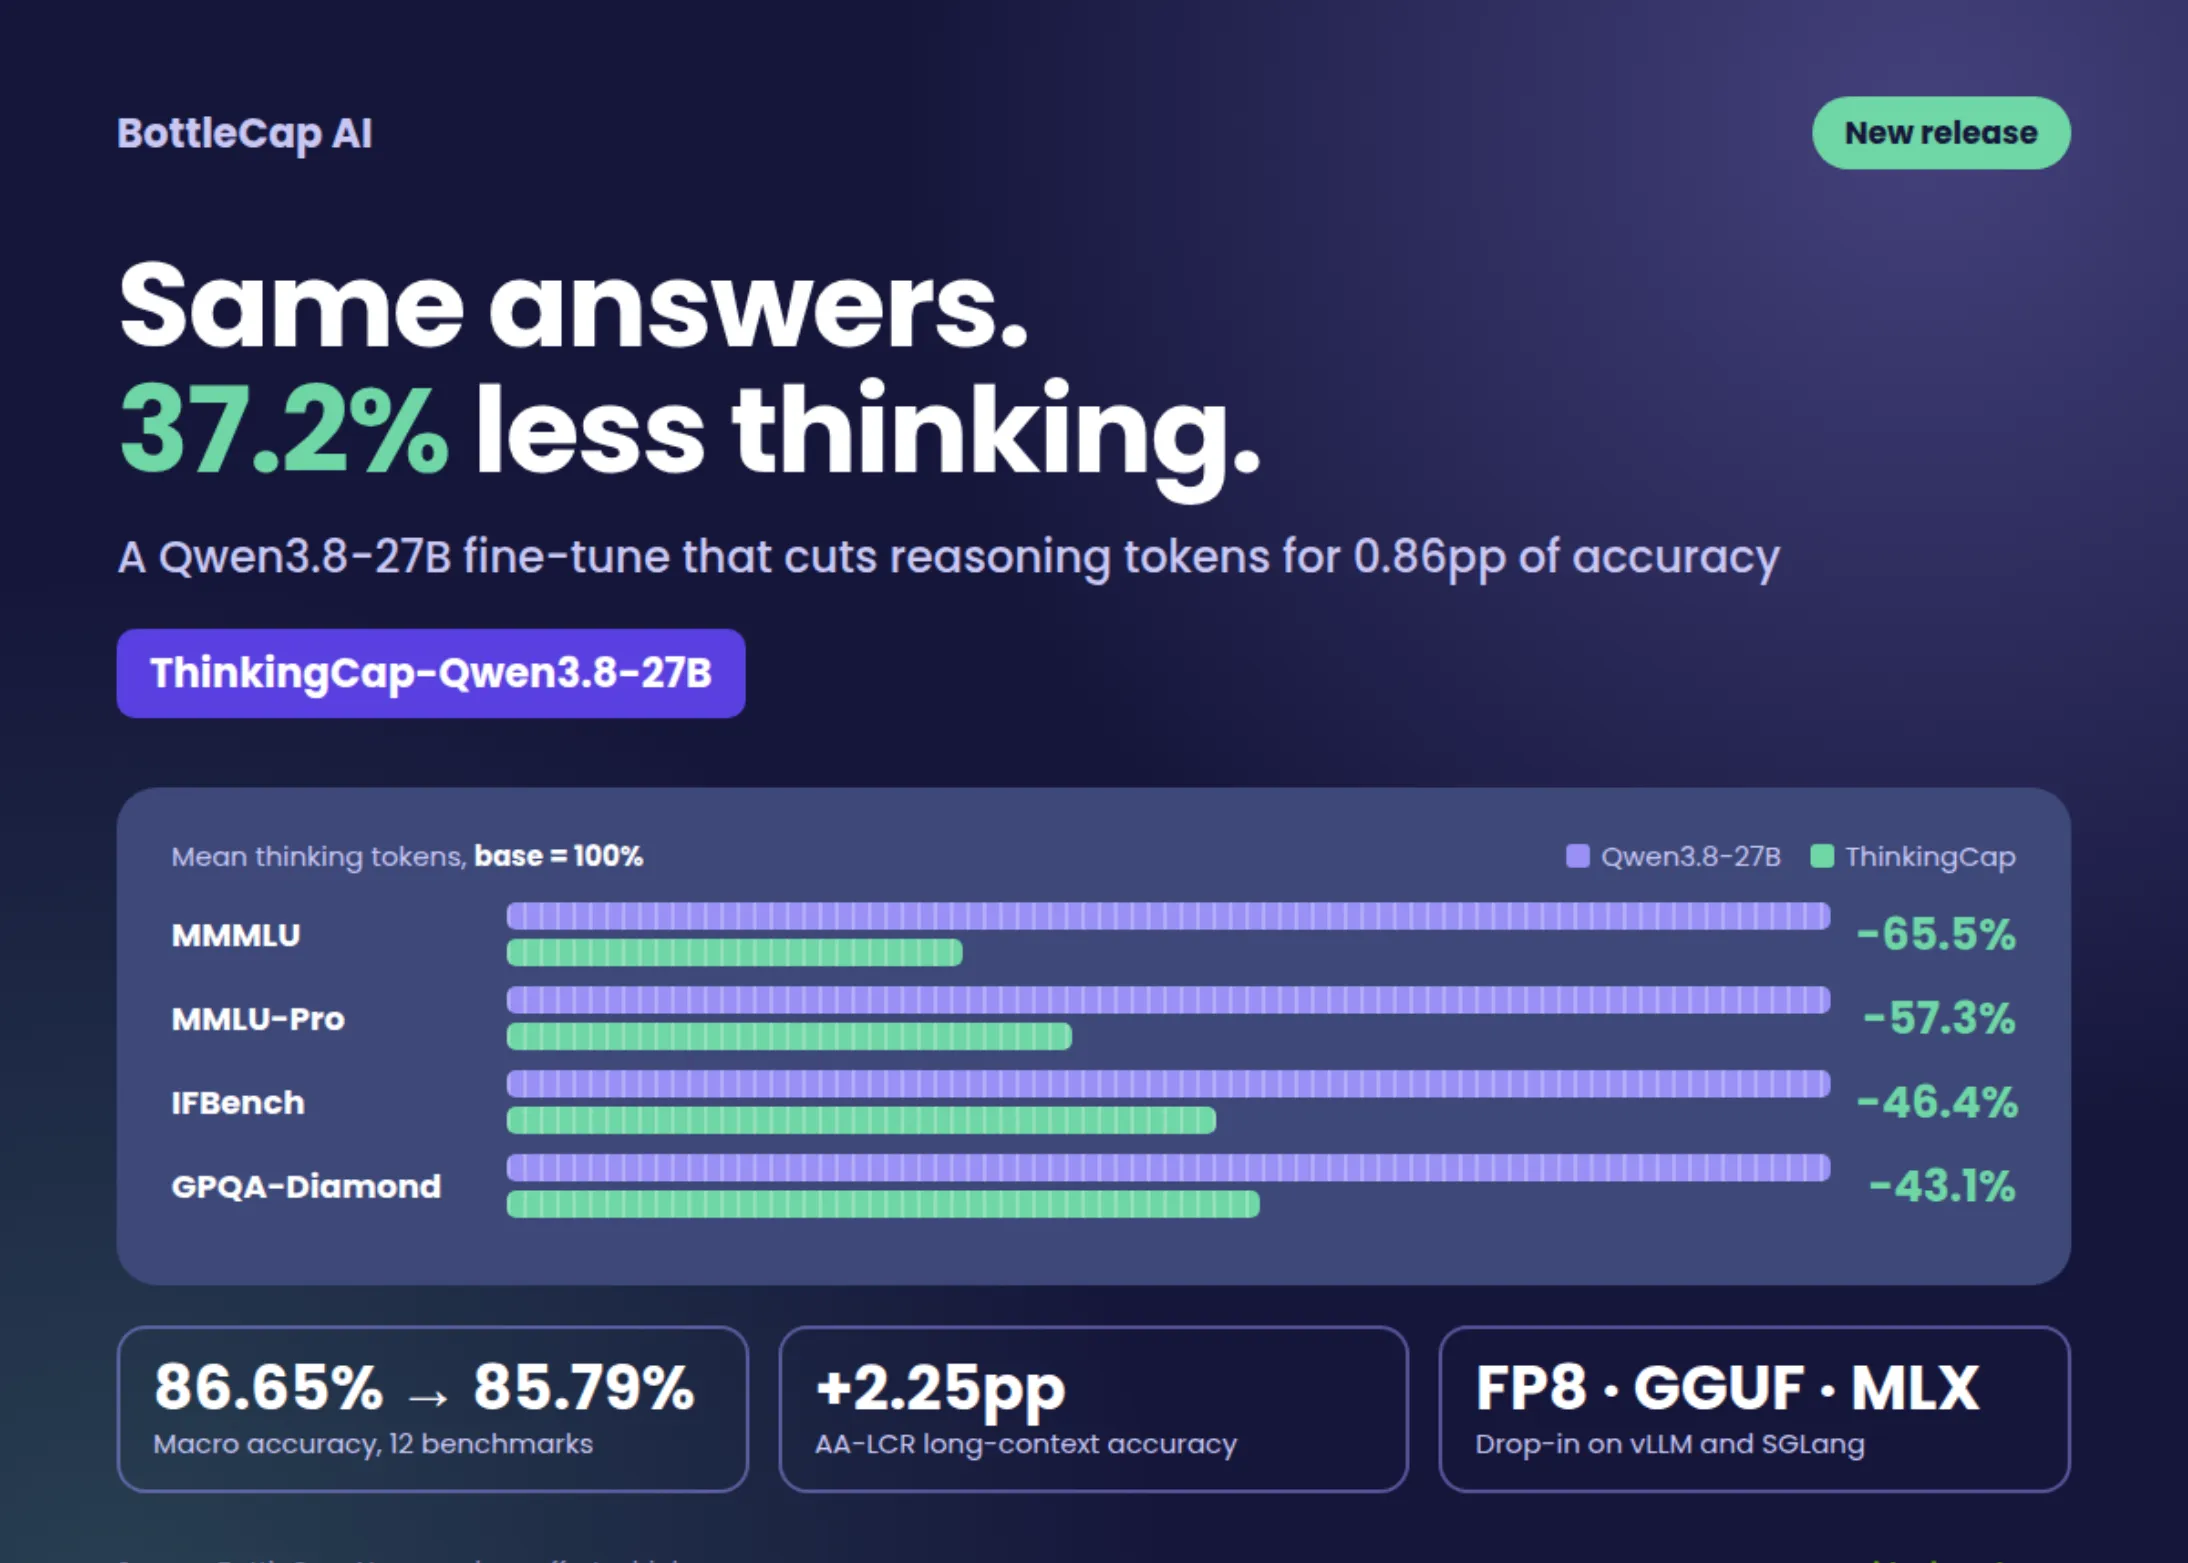
Cifra care sare imediat în ochi este simplă: 37,2% mai puține tokenuri de gândire. Adică modelul ajunge la răspunsul final consumând cu peste o treime mai puține resurse de raționament. Iar costul acestei economii este de doar 0,86 puncte procentuale de precizie. Dacă stai să te gândești bine, e un schimb aproape ridicol de favorabil. În lumea modelelor de tip reasoning, unde fiecare punct de precizie se plătește scump, iar lanțurile de gândire pot ajunge să consume mii de tokenuri pentru o singură întrebare, o reducere de 37% la volumul de gândire înseamnă facturi mai mici, latență mai bună și, foarte important, mai puțină presiune pe infrastructură.
Să punem lucrurile în perspectivă. Modelele de raționament moderne, cele care „gândesc" înainte să răspundă, au un obicei enervant: se gândesc prea mult. Scriu și rescriu, se întorc la premize, verifică de două-trei ori același lucru, iar la final ajung la o concluzie care putea fi atinsă mult mai repede. E ca și cum ai avea un angajat genial, dar care îți consumă jumătate de zi pentru o sarcină de o oră. ThinkingCap-Qwen3.8-27B pare să fi fost construit exact pe această observație: mai puțină rumegare, aceeași calitate a răspunsului.
Numele modelului spune destul de mult. „Qwen3.8-27B" sugerează o bază derivată din familia Qwen, cu 27 de miliarde de parametri — un segment de piață extrem de interesant, pentru că e suficient de mare ca să fie capabil, dar suficient de mic ca să poată rula pe hardware accesibil. Iar „ThinkingCap" este clar o referire la capacitatea de raționament, la „șapca de gândire" pe care modelul o poartă atunci când trebuie să rezolve probleme complexe. BottleCap AI nu încearcă să concureze cu modelele de 400B+ parametri pe benchmarkuri academice. Încearcă să rezolve o problemă pe care toți cei care implementează agenți AI o simt zilnic: costul gândirii.
De ce contează asta atât de mult? Pentru că în aplicațiile reale, mai ales în agenții autonomi care rulează în bucle lungi, fiecare token de gândire se plătește. Un agent care rezolvă o sarcină în 50 de pași, fiecare pas cu propriul lanț de raționament, poate consuma zeci de mii de tokenuri doar ca să „gândească". Dacă reduci acest volum cu 37%, reduci costul operațional cu o proporție similară. Iar dacă precizia scade cu mai puțin de un punct procentual, decizia devine aproape evidentă pentru oricine se uită la buget.
Există însă și o parte mai subtilă, pe care presa de tehnologie o ratează des. Mai puține tokenuri de gândire nu înseamnă doar bani economisiți. Înseamnă și răspunsuri mai rapide, ceea ce schimbă fundamental experiența utilizatorului. Un chatbot care răspunde în 3 secunde în loc de 8 secunde pare de două ori mai deștept, chiar dacă scorul lui pe un benchmark este identic. Înseamnă, de asemenea, mai puțină energie consumată, un aspect care devine din ce în ce mai greu de ignorat într-o industrie criticată constant pentru amprenta ei de carbon. Și înseamnă mai puțină presiune pe GPU-uri, ceea ce, într-o piață unde cererea depășește constant oferta, este un avantaj competitiv real.
Desigur, trebuie să fim onești. 0,86 puncte procentuale nu sunt zero. Pentru aplicații critice, unde fiecare procent de precizie contează — diagnostic medical asistat, analiză juridică, cod în producție — această pierdere poate fi inacceptabilă. Dar pentru marea majoritate a cazurilor de utilizare, de la asistenți de customer support până la agenți de automatizare, de la rezumare de documente până la generare de conținut, această diferență este invizibilă pentru utilizatorul final. Iar când diferența este invizibilă, dar factura este vizibil mai mică, alegerea devine simplă.
Un alt aspect interesant este poziționarea BottleCap AI. Nu este OpenAI, nu este Anthropic, nu este Google. Este un jucător mic care a ales să concureze pe un teren pe care giganții îl neglijează: optimizarea eficienței. Este o strategie clasică de disruptie — nu încerci să fii mai bun la ce sunt ei buni, ci încerci să fii mai eficient la ceva ce ei consideră secundar. Și, de multe ori, exact aceste nișe se dovedesc a fi cele mai profitabile pe termen lung.
Întrebarea care rămâne este dacă această abordare este sustenabilă. Reducerea tokenurilor de gândire cu 37% este impresionantă, dar este o optimizare punctuală sau face parte dintr-o direcție mai amplă? Dacă BottleCap AI poate continua să rafineze acest echilibru între eficiență și precizie, atunci avem de-a face cu ceva mai mult decât un simplu release. Avem de-a face cu o filozofie de design care ar putea influența modul în care întreaga industrie gândește despre raționamentul artificial.
Pentru dezvoltatori, vestea este clară: există acum o opțiune în plus pe masă, una care promite să reducă costurile fără să sacrifice prea mult din calitate. Pentru restul lumii, vestea este și mai simplă: AI-ul devine, încet-încet, mai ieftin de folosit. Iar când tehnologia devine mai ieftină, ea devine mai accesibilă, iar când devine mai accesibilă, se schimbă modul în care trăim și muncim. ThinkingCap-Qwen3.8-27B nu este un moment de cotitură spectaculos. Este un pas mic, pragmatic, dar exact genul de pas care, însumat cu alții, duce unde trebuie.
De ce este important:
Pentru că eficiența raționamentului este următoarea frontieră reală în AI, nu scorurile pe benchmarkuri. ThinkingCap-Qwen3.8-27B demonstrează că se poate reduce consumul de tokenuri de gândire cu 37,2% pierzând doar 0,86 puncte procentuale de precizie — un compromis care schimbă ecuația economică pentru oricine rulează agenți AI la scară. Într-o industrie obsedată de „cât de deștept" este un model, BottleCap AI ne reamintește că întrebarea cu adevărat importantă este „cât costă să fie deștept". Iar răspunsul lor ar putea influența modul în care giganții își proiectează următoarele generații de modele.