Contextul operațional este unul extrem de complex. NVIDIA măsoară performanța livrărilor de la ieșirea plachetelor semiconductoare până la primul token procesat. Această fereastră temporală este împărțită în două segmente critice: timpul până la rack (perioada de tranzit de la producția plachetelor până la asamblarea unui sistem complet în centrul de date) și timpul până la token (care acoperă alimentarea cu energie, răcirea, rețeaua și pregătirea software-ului din prima zi).
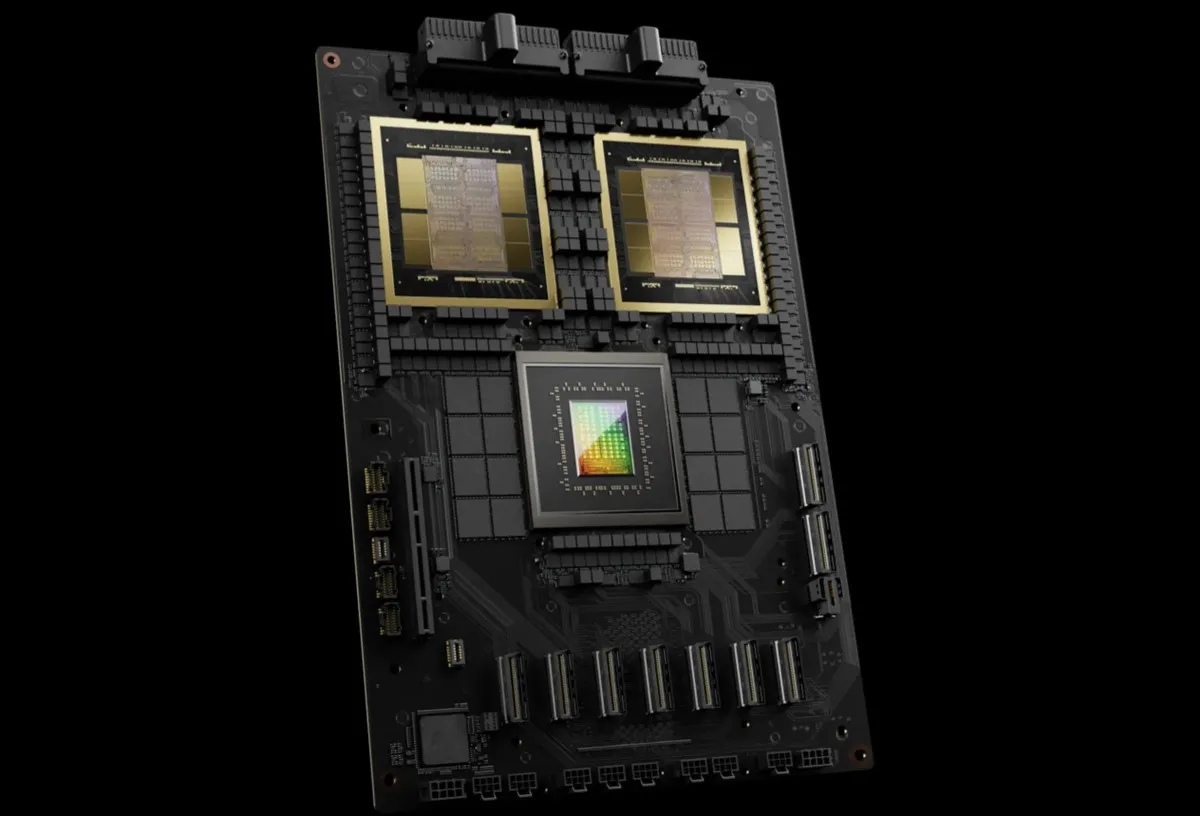
Scalarea hardware-ului a amplificat semnificativ constrângerile de aprovizionare. Un singur rack NVIDIA Grace Blackwell NVL72 conține 18 tăvi de calcul, fiecare tavă necesitând două procesoare Grace, patru GPU-uri Blackwell și 32 de pachete de memorie HBM3e. Toate aceste componente provin de la mii de furnizori, OEM-uri și parteneri de design contractuali. Mai mult, lanțul de aprovizionare construit pentru viitoarea arhitectură Vera Rubin a NVIDIA este de două ori mai mare decât cel care susține actuala generație Grace Blackwell.
Asamblarea nu poate începe până când toate piesele nu sosesc din trei canale distincte: inventar direct, stoc în consignație și furnizori externi. Livrările timpurii trebuie adesea să aștepte componente întârziate, ceea ce extinde ceea ce NVIDIA numește "Timpul de Posesie" (durata de la momentul în care o facilitate primește materialele până când subansamblurile finite părăsesc fabrica). Alocările din fabrici sunt recalculate săptămânal pe orizonturi mobile de două trimestre, pentru a rezolva problemele legate de disponibilitatea pieselor, limitele de producție și programele de livrare către clienți.
Pentru a coordona aceste dependențe complexe, echipa de operațiuni NVIDIA a construit un centru de comandă numit "Digital Supply Chain Intelligence" folosind Palantir Foundry. Ontologia Foundry modelează facilitățile, angajamentele furnizorilor, stocurile de componente și obiectivele de producție ca obiecte și legături interconectate. NVIDIA cuOpt, o bibliotecă open-source pentru optimizarea deciziilor accelerată pe GPU, citește direct acest strat operațional.
Formulând distribuția ca un program liniar mixt întreg, proiectat pentru a minimiza Timpul de Posesie, solverul evaluează constrângerile de piese la fiecare nivel al listei de materiale. Dincolo de generarea programelor săptămânale de livrare, cuOpt identifică limitele active ale fabricilor, cum ar fi capacitatea regională de asamblare comparativ cu disponibilitatea brută a memoriei.
Cu toate acestea, optimizarea matematică singură nu a reușit să captureze variabilele operaționale nestructurate observate de planificatorii umani, inclusiv transcrierile apelurilor cu furnizorii, prognozele meteo regionale, schimburile de e-mail cu partenerii și evenimentele geopolitice. NVIDIA a abordat această problemă prin post-antrenarea modelului Nemotron 3.5 Lightning, un model open-weight de tip mixture-of-experts cu 30 de miliarde de parametri totali și aproximativ trei miliarde de parametri activi per trecere înainte.
Pipeline-ul de inginerie procesează înregistrările istorice prin NeMo Anonymizer pentru a redacta câmpurile operaționale sensibile, NeMo Data Designer pentru a echilibra exemplele de antrenament cu scenarii sintetice de întrerupere a capacității și NeMo AutoModel pentru a aplica parametri de adaptare de rang scăzut (LoRA), păstrând în același timp greutățile modelului de bază înghețate. Palantir Autopilot gestionează proveniența datelor, urmărirea modelelor și livrarea recomandărilor.
Evaluat pe înregistrări istorice de alocare, modelul post-antrenat Nemotron 3.5 Lightning a atins o precizie de decizie de 86,7%, comparativ cu 55,5% pentru modelul mai mare Nemotron 3 Ultra și 17,5% pentru modelul de bază Lightning neajustat. Modelul post-antrenat a obținut o precizie echilibrată de 58,6% și un scor macro-F1 de 57,5%, depășind performanța Nemotron 3 Ultra, care a înregistrat 42% precizie echilibrată și 39,5% scor macro-F1. Reglajul fin s-a finalizat pe două GPU-uri NVIDIA B200 în câteva minute.
Reglajul fin pe domeniu a îmbunătățit deciziile de alocare, deși prognozarea riscurilor de producție pe termen mai lung a rămas dificilă. Deciziile operaționale, revizuirile planificatorilor, excepțiile și rezultatele observate din fabrici sunt continuu scrise înapoi în Ontologia Palantir. NVIDIA a confirmat că acest set de date va forma perechi de preferințe pentru rutinele de învățare prin consolidare – scorând recomandările pe baza preciziei alocării, conformității cu politicile și fundamentării dovezilor – cu modelele de producție rămânând strict izolate de reantrenarea live și nemonitorizată.
De ce este important:
Această abordare reprezintă un punct de cotitură în managementul lanțurilor de aprovizionare la scară largă. NVIDIA demonstrează că integrarea optimizării matematice clasice cu modele de limbaj avansate poate rezolva probleme practice extrem de complexe, care depășesc capacitățile oricărei metode individuale. Succesul acestei implementări ar putea stabili un nou standard industrial pentru modul în care companiile de tehnologie își gestionează producția în contextul cererii explozive de hardware AI. Mai mult, utilizarea modelelor open-source și a bibliotecilor accesibile precum cuOpt sugerează că aceste tehnici ar putea fi adoptate și de alte companii, democratizând astfel accesul la optimizarea avansată a lanțului de aprovizionare. Pe măsură ce arhitecturile viitoare precum Vera Rubin devin realitate, capacitatea de a gestiona lanțuri de aprovizionare de două ori mai mari va fi crucială pentru menținerea ritmului de inovație în industria AI.