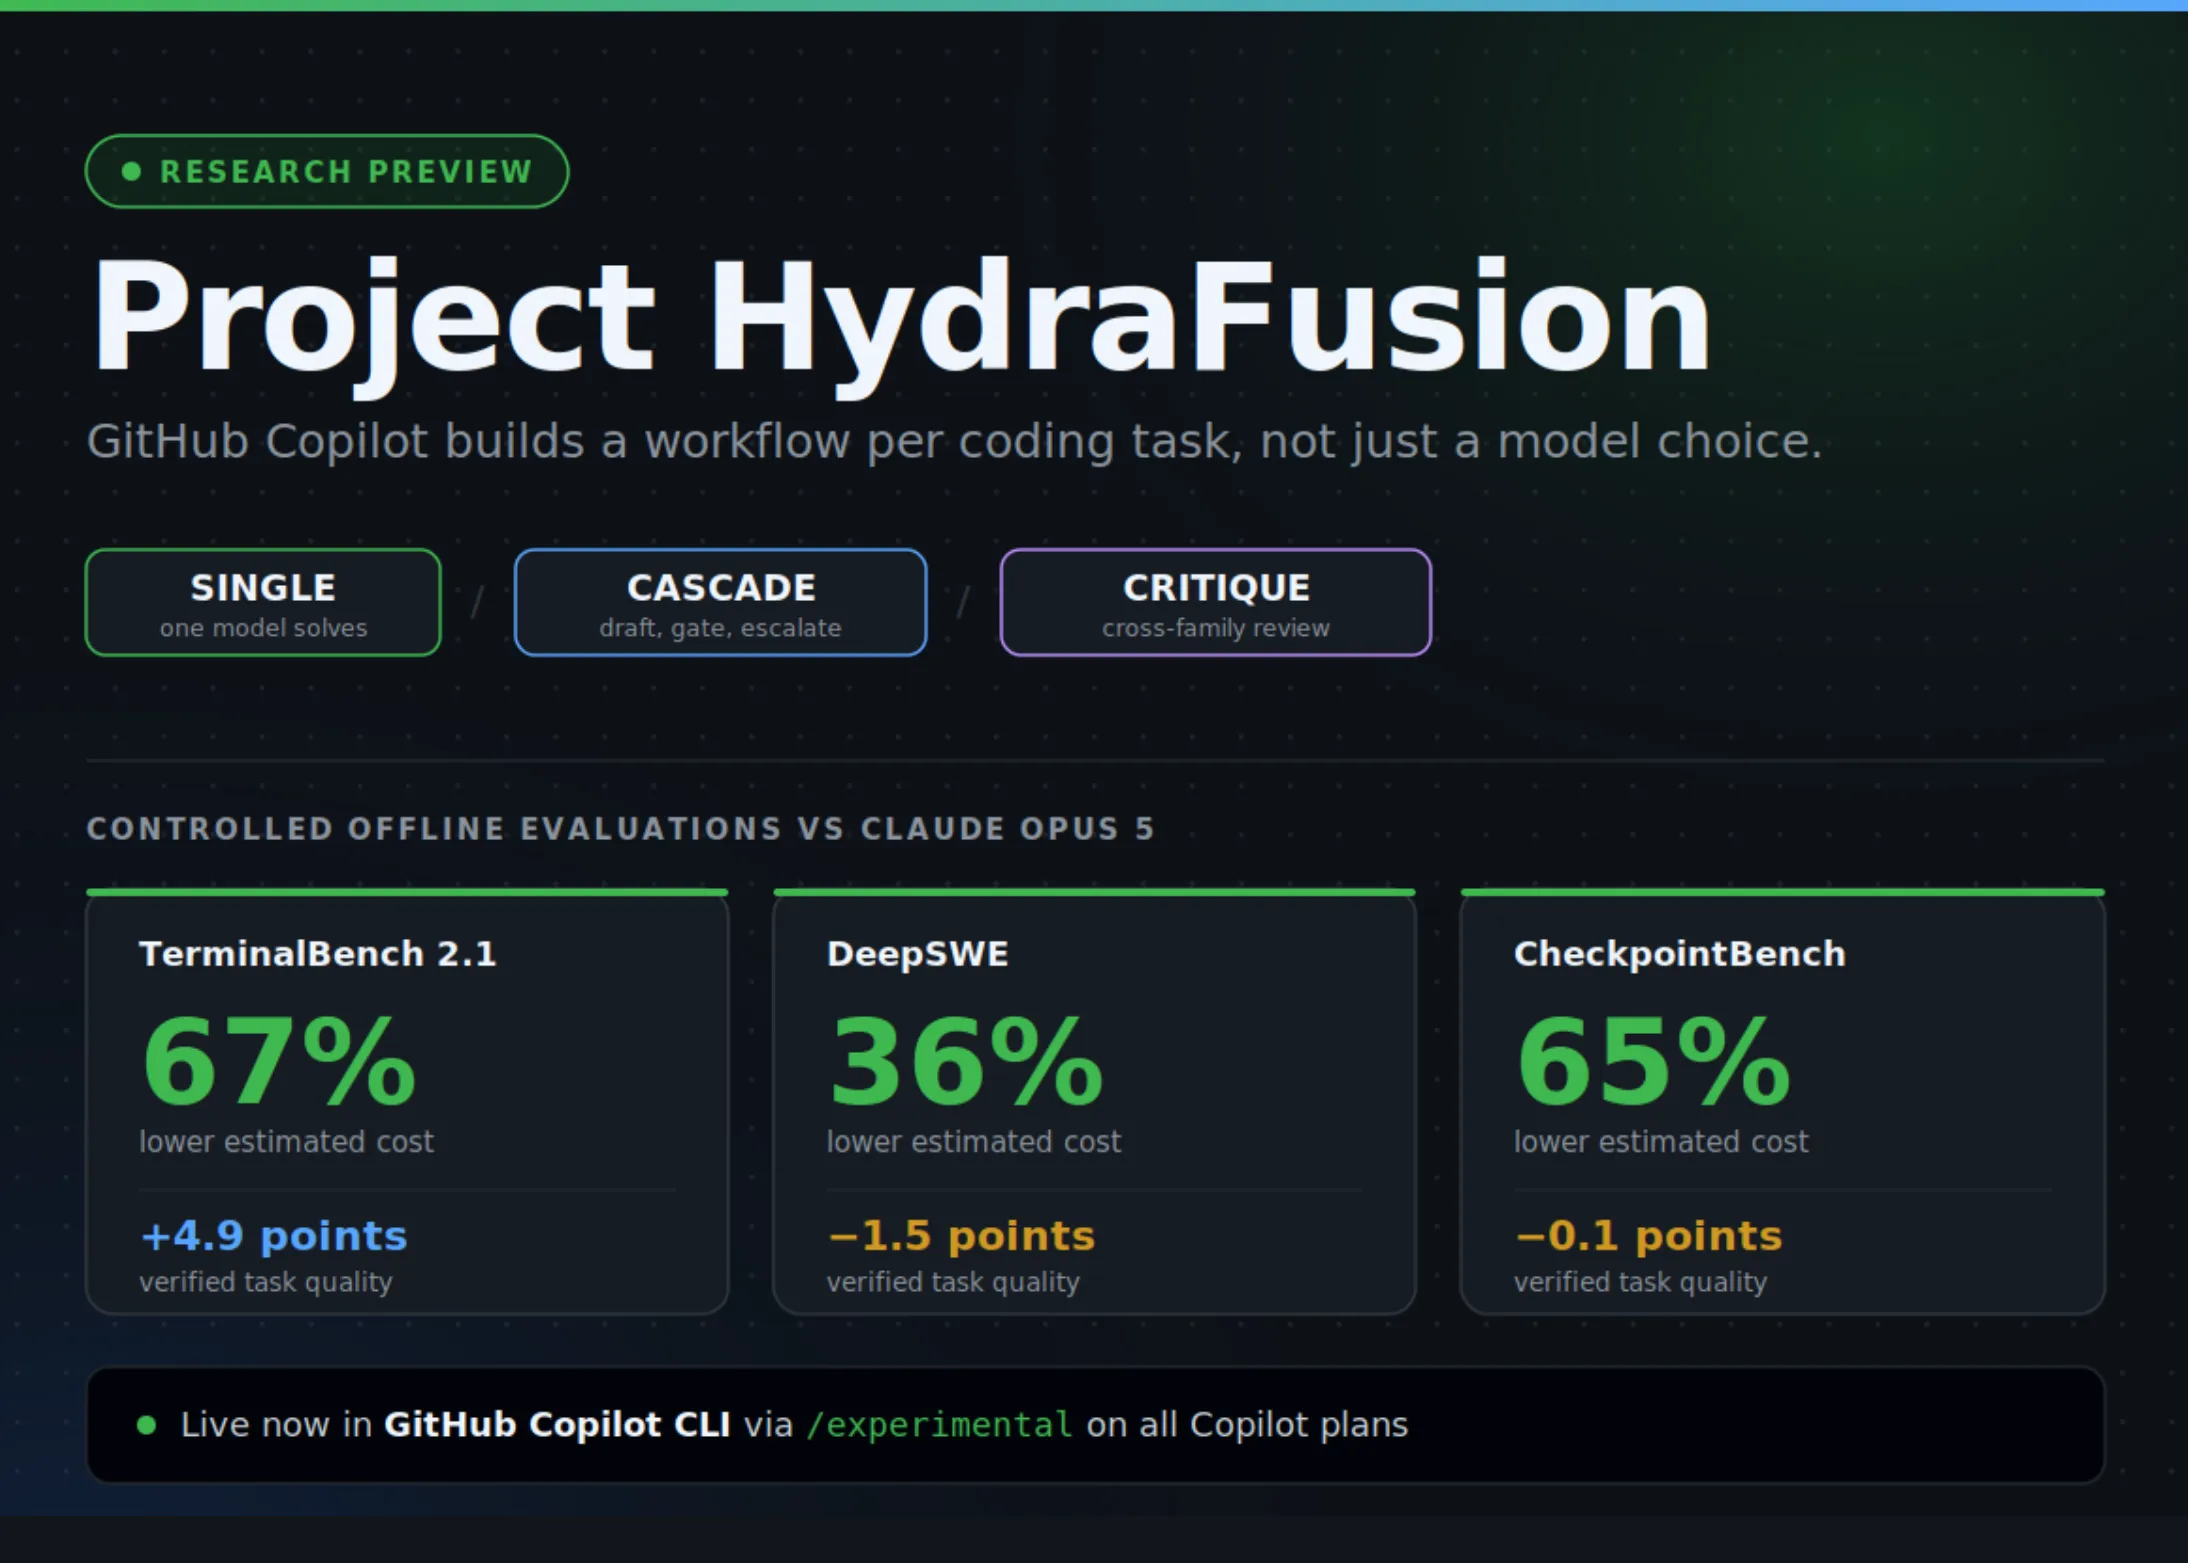
De la "Un model care îi stăpânește pe toți" la "Echipa potrivită pentru job"
Până acum, majoritatea asistenților de codare baziați pe LLM (inclusiv versiunile anterioare ale Copilot) funcționaau pe un principiu simplu: un model mare, puternic (și adesea scump) era interogat pentru totul — de la scrierea unui regex complicat și refactorizarea unui modul legacy, până la explicarea unei erori de sintaxă sau generarea unui fișier Dockerfile.
Abordarea are dezavantaje evidente. Un model optimizat pentru raționament complex (gen GPT-4o sau Claude 3.5 Opus) este ineficient și lent pentru sarcini triviale. Invers, un model rapid și mic (gen Haiku sau modelele mici open-source) eșuează la arhitectură sau depanare complexă. HydraFusion rezolvă acest dilemă printr-un router semantic la runtime.
Când un dezvoltator scrie în terminal `gh copilot suggest "optimize this SQL query for Postgres partitioning"`, HydraFusion nu trimită simplu prompt-ul către un model. El:
1. Analizează intenția și contextul: Identifică că este vorba de optimizare SQL, Postgres, partitioning — o sarcină de specialitate a bazei de date.
2. Selectează echipa: Poate alege un model specializat în SQL (posibil un model mic finetunat pe dialecte SQL) pentru generarea query-ului, un model de raționament pentru a explica de ce funcționează, și un validator de securitate pentru a verifica riscurile de SQL injection.
3. Orheastrează fluxul: Modelele comunică între ele printr-un protocol intern structurat (nu text liber), schimbând artefacte intermediare (AST-uri, planuri de execuție, diff-uri).
4. Returnează rezultatul compus: Utilizatorul vede un răspuns coerent, dar generat de o "echipă virtuală" de modele.
Arhitectura tehnică: Routerul, Planificatorul și Magistrala de Mesaje
Detaliile tehnice dezvăluite de echipa GitHub Next indică o arhitectură modulară formată din trei componente principale:
1. Semantic Router (Routerul Semantic)
Este inima sistemului. Nu este un classifier clasic (IF/ELSE), ci un model mic, ultra-rapid (probabil un BERT distilat sau un LLM mic de 1-3B parametri) antrenat să mappeze intenția utilizatorului și contextul repository-ului (limbaj, framework-uri, fișiere deschise) pe un "Task Blueprint" — o specificație structurată a pașilor necesari.
2. Workflow Planner (Planificatorul de Fluxuri)
Primește Blueprint-ul și construiește un DAG (Directed Acyclic Graph) de execuție. Decide: "Pentru această sarcină, avem nevoie de: `CodeGenerator` -> `StaticAnalyzer` -> `TestGenerator` -> `Summarizer`". Fiecare nod al grafului este mapat pe un Model Adapter specific.
3. Model Registry & Adapters (Registrul și Adapterii de Modele)
Aici se află secretul puterii: GitHub nu este legat de un singur furnizor. Registrul poate conține:
Modele specializate micro (ex: un model de 500MB antrenat doar* pe migrații Django sau configurații Kubernetes).
Adapterii normalizează I/O-ul: transformă textul în JSON structurat, validează schemele, gestionează context-filling (RAG pe codebase) și aplică guardrails (securitate, cost, latență).
Experiența dezvoltatorului: Invisible Magic
Ce este remarcabil este că tot acest lucru se întâmplă invizibil. Latenta percepută este minimizată prin:
Pentru utilizatorul final, Copilot CLI devine mai rapid pe sarcini simple (pentru că folosește modele mici) și mai inteligent pe cele complexe (pentru că apelează modele mari doar unde e nevoie).
Implicații strategice: Suveranitatea datelor și Economia tokenilor
Lansarea HydraFusion semnifică trei lucruri majore pentru industria software:
1. Moartea "Context Window Anxiety"
În loc să încarci 100k tokeni într-un singur prompt sperând că modelul va găsi acul în fanul de fân, HydraFusion folosește modele mici pentru retrieval și summarizare locală, trimițând către modelul mare doar contextul strict necesar pentru raționament. Costul per interacțiune scade dramatic.
2. Strategia "Bring Your Own Model" (BYOM) la nivel enterprise
Organizațiile cu politici stricte de date (bănci, sănătate, guvern) pot înlocui adapterii cloud cu modele locale (rulate pe GPU-uri on-prem sau chiar CPU-uri prin quantizare) pentru nodurile sensibile (ex: acces la cod sursă propriu), lăsând nodurile generice (ex: explicare concepte) în cloud. GitHub a anunțat un SDK pentru Custom Model Adapters disponibil în Q1 2025.
3. Nașterea "Micro-Specialization" în AI Coding
Vom vedea o explozie a modelelor mici, antrenate pe niche foarte specifice: "Terraform AWS Security Groups", "React Accessibility Fixes", "COBOL to Java Migration Patterns". HydraFusion oferă piața pentru aceste modele — un mecanism de distribuție și compoziție nativ.
Provocări și riscuri: Complexitatea ascunsă
Nu totul este roz. Introducerea unui sistem distribuit la nivel de CLI aduce noi clase de erori:
Cascading Failures: O halucinare a modelului mic de retrieval* poate deruta planificatorul către un flux greșit.
Consistența stilului: Combinarea output-urilor a 3-4 modele diferite poate duce la cod care nu are o "voce" unificată. Soluția: un nod final de Style Harmonizer* (un model mic de rewriting) care normalizează convențiile de numire, formatare și comentarii.
Concluzie: Terminalul devine un sistem de operare AI
Project HydraFusion nu este doar o funcție nouă a Copilot CLI. Este recunoașterea faptului că terminalul este mediul natural pentru agenții AI, nu interfața de chat. În chat, contextul este liniar. În terminal, contextul este structural (fișiere, procese, pipes, variabile de mediu, istoric shell).
HydraFusion transformă Copilot CLI dintr-un "chatbot care rulează comenzi" într-un sistem de operare miniaturizat pentru sarcinile de inginerie, unde kernel-ul este routerul semantic, procesele sunt modelele specializate, iar pipe-urile sunt magistrala de mesaje structurate.
Dacă GitHub reușește să facă acest sistem extensibil (permițând comunității să scrie proprii adaptoare și planificatori de fluxuri), Copilot CLI devine platforma — nu doar produsul. Și asta, colegi mei, este jocul final (endgame) al AI-assisted software engineering.
De ce este important:
Project HydraFusion marchează trecerea de la modelele monolite la sisteme AI compuse (Compound AI Systems) în producție, la scară largă. Demonstrează că viitorul nu aparține modelului cel mai mare, ci arhitecturii care știu să combine cel mai mic model potrivit pentru fiecare sub-sarcină. Pentru dezvoltatori, înseamnă costuri mai mici, latențe mai bune și specializare reală. Pentru industrie, semnifică standardizarea interfețelor model-model (model-to-model protocols) și nașterea unui ecosistem de "micro-modele" specializate. Este cel mai semnificativ avans arhitectural în tooling-ul de AI coding de la lansarea ChatGPT.