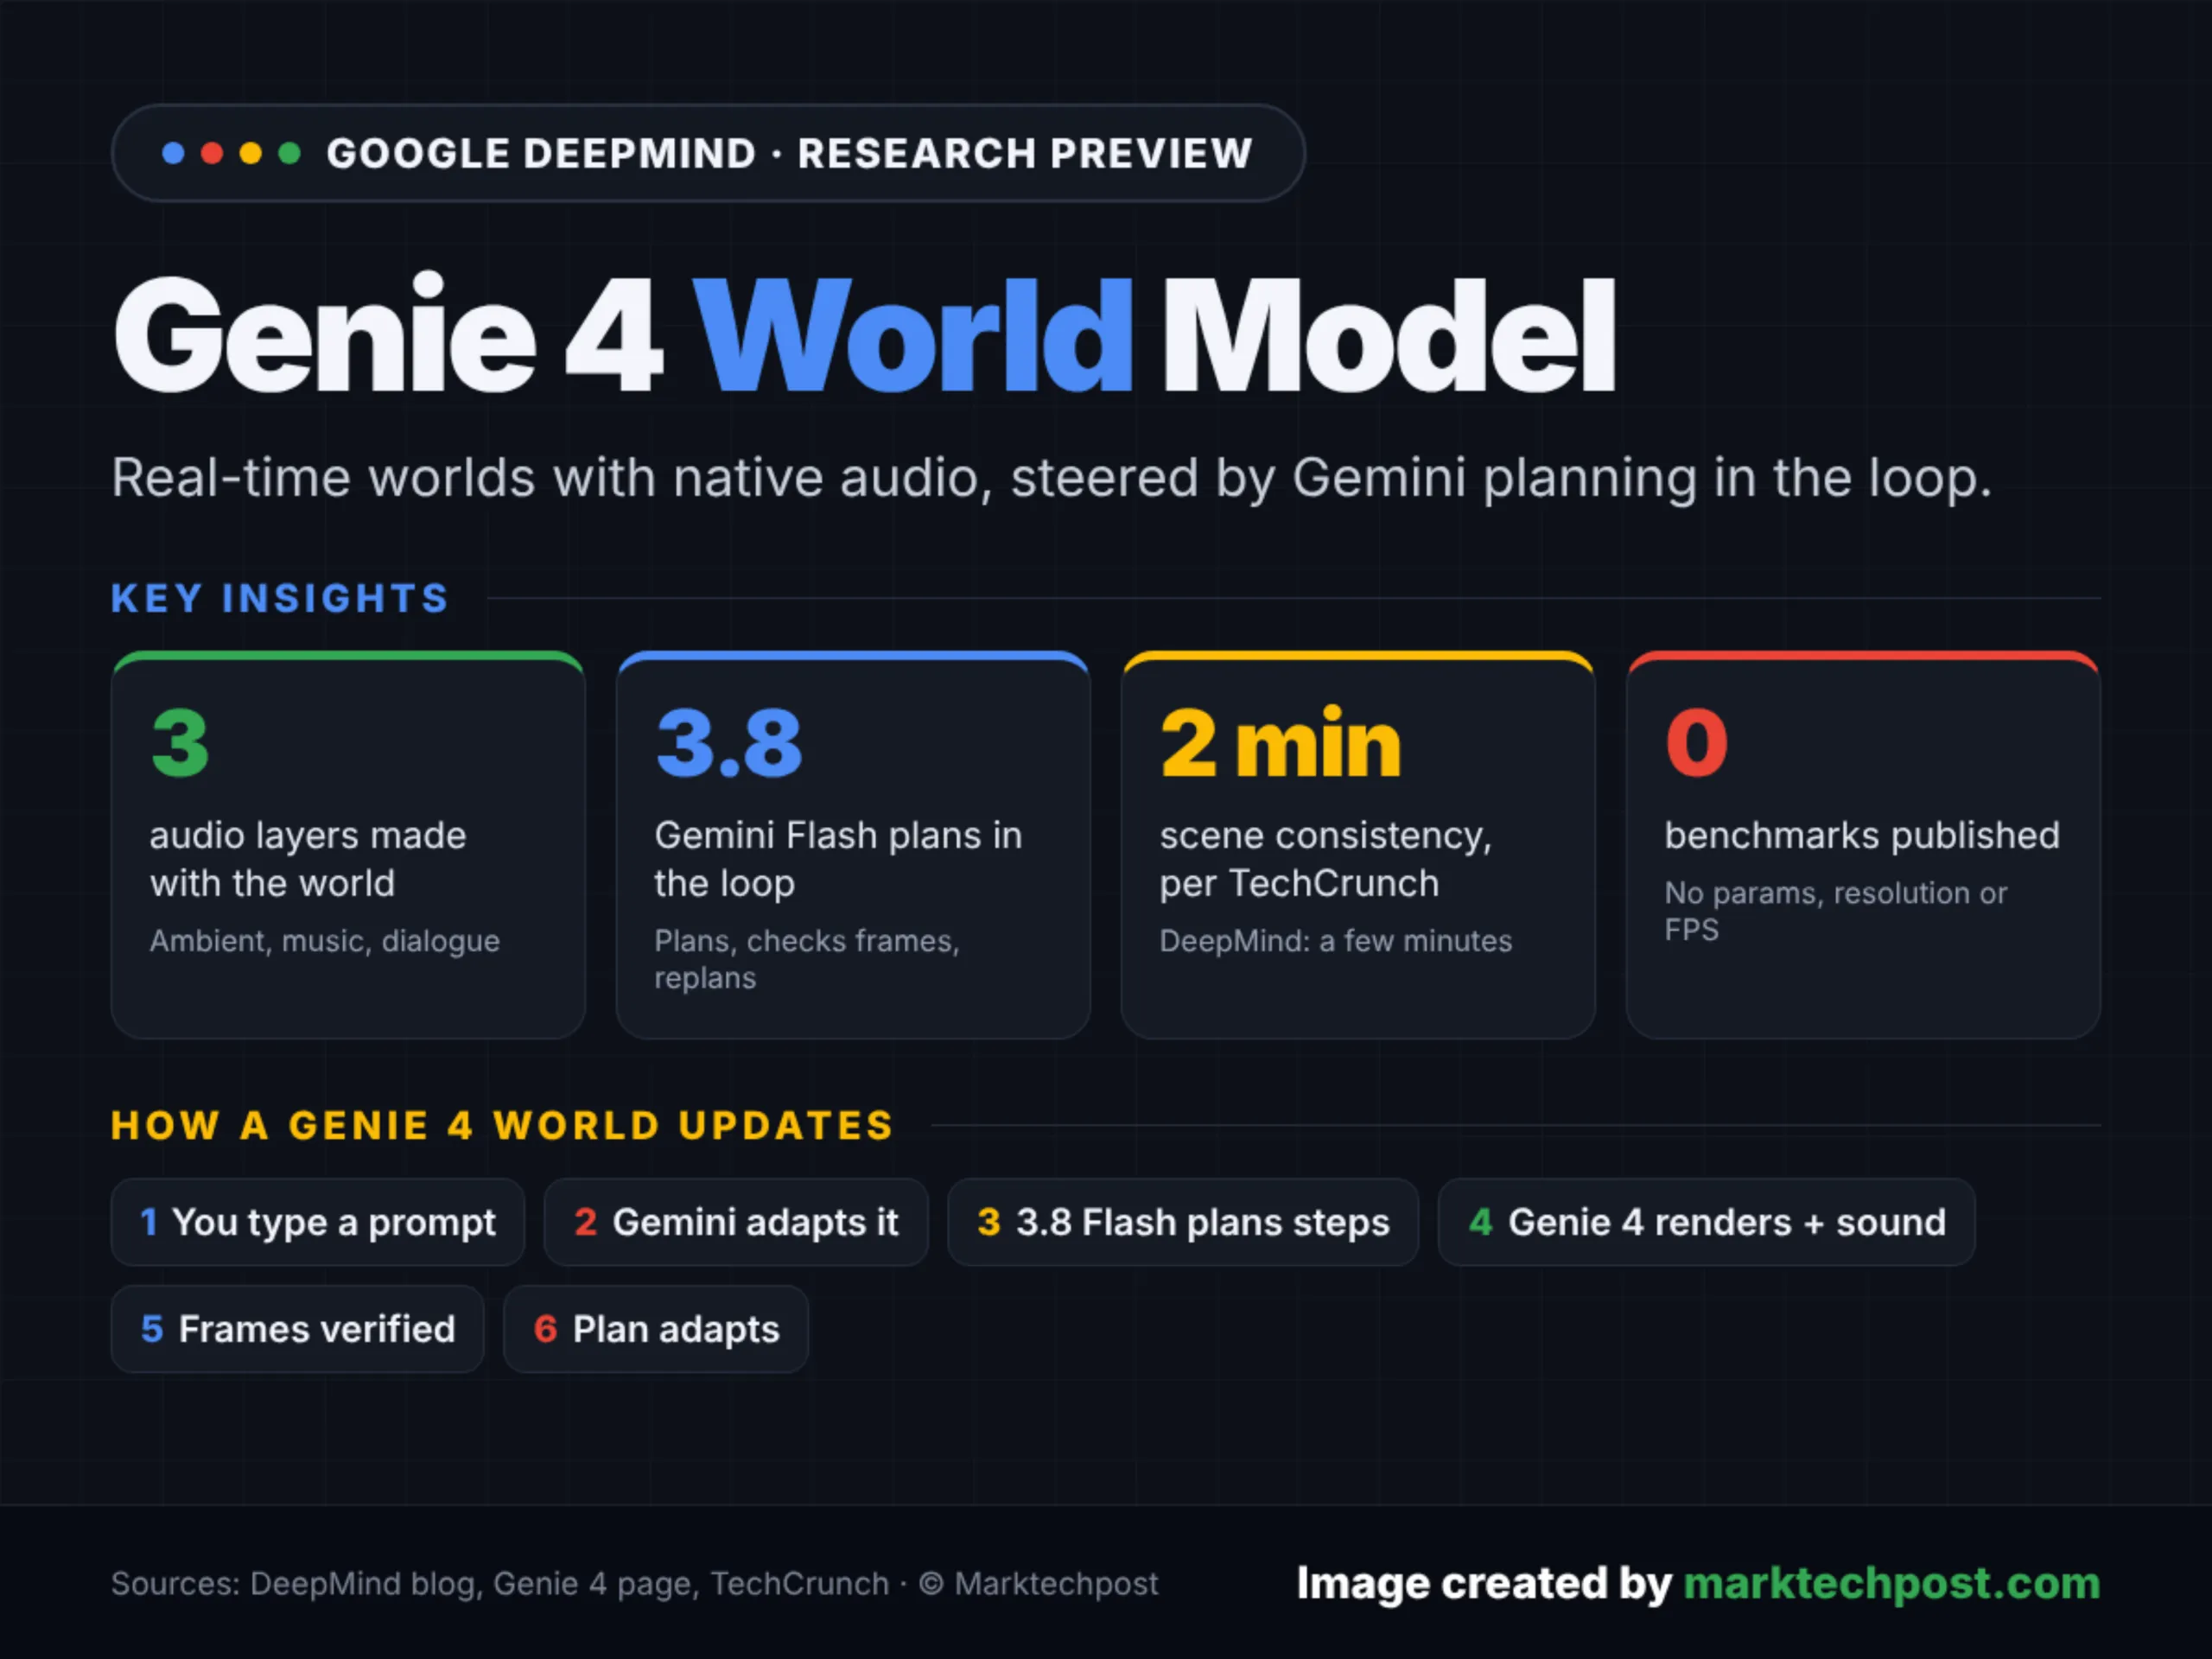
Anunțul, venit discret dar cu forța unui cutremur tehnologic, nu este doar o actualizare incrementală. Reprezintă o convergență critică între inteligența artificială generativă, robotică și interfațe neuronale. Până acum, majoritatea modelelor mondiale (world models) – de la Genie 1 și 2 ai DeepMind, la Sora al OpenAI sau Dreamer al lui Danijar Hafner – au fost predominant vizuale. Ele "visează" cadre video. Genie 4, însă, visează paisaje sonore sincronizate perfect cu fizica simulată.
Arhitectura: Mai mult decât un model video cu sunet adăugat
Ce face Genie 4 fundamental diferit nu este adăugarea unui modul Text-to-Speech (TTS) sau AudioLM deasupra unui backbone video. Conform surselor apropiate de laboratorul din Londra, arhitectura este nativ multimodală de la nivelul token-ului de bază. Modelul nu generează mai întâi video și apoi adaugă sunetul; el generează o reprezentare latentă unificată care se decodează simultan în pixeli și forme de undă audio.
Aceasta înseamnă că cauzalitatea este păstrată la un nivel microscopic. Dacă un personaj virtual călcaște pe frunze uscate, sunetul crepitării nu este un efect sonor pre-randat declanșat de o animație, ci rezultatul simulării fizice a interacțiunii dintre picioare, suprafață și aer, tradusă în vibrații acustice în timp real. Aceasta este esența unui World Model adevărat: o înțelegere a legilor fizice care guvernează atât lumina, cât și sunetul.
Implicații pentru Robotică: Sim-to-Real Audio
Comunitatea robotică a așteptat ani de zile un astfel de instrument. Antrenarea robotilor în simulare (Sim-to-Real) a fost întotdeauna plină de pericole din cauza "gap-ului" de realitate. Vizual, am ajuns să facem texturi fotorealiste. Dar audio? Roboticii au ignorat adesea modalitatea audio sau au folosit senzori simpliști.
Genie 4 schimbă jocul. Un braț robotic care învață să spargă ouă sau să asambleze piese fragile poate acum primi feedback acustic realist în simulare: "cloc"-ul coajei, zgomotul frecării metalului, tonomul diferit al unui obiect gol versus unul plin. Acest feedback audio este crucial pentru manipularea dexteră. Modelele de control bazate pe reinforcement learning (RL) pot acum antrena politici care "audă" eșecul înainte să-l vadă sau să-l simtă forța în senzorii tactili, accelerând dramatic convergența antrenamentului.
Gaming și NPC-uri: Moartea Script-urilor
Pentru industria gaming, Genie 4 este promisiunea "NPC-urilor vii" pe care o așteptăm de o decenie. Imaginează-ți un personaj non-jucător care nu doar că are replici scrise de scenariști, dar care generează propria voce, intonația, pașii, respirația și interacțiunea cu mediu în funcție de acțiunile jucătorului, totul în timp real, fără latency perceptibilă.
Nu mai vorbim de arbori de dialog, ci de comportament emergent. Dacă jucătorul aruncă un obiect greu pe un podea de lemn vechi, NPC-ul nu activează o animație "surprise" predefinită. Modelul mondial simulează impactul, generează sunetul specific al lemnului spart, calculează vibrația care se propagă prin pardoseală și face ca NPC-ul să reacționeze fizic (sare de frică) și vocal (strigă sau șoptește o jurământ) într-o singură secvență coerentă. Aceasta este generația procedurală a narativii nu a conținutului static.
Provocarea Computațională: Timp Real Real
Termenul "Real-Time" din titlu nu este marketing gratuit. Antrenarea unui astfel de model necesită o putere de calcul colosală, dar inferența – rularea modelului – este provocarea adevărată. DeepMind a reușit, probabil prin o combinație de distilare a cunoștințelor (knowledge distillation), arhitecturi de tip Mixture-of-Experts (MoE) și optimizări la nivel de hardware (TPU v5p/v6), să compreseze acest model masiv într-o formă care rulează la 20-30 FPS cu audio de înaltă fidelitate (probabil 24kHz sau 48kHz) pe acceleratoare de tip datacenter.
Pentru implementarea pe dispozitive edge (telefoane, headset-uri AR/VR), calea este încă lungă. Dar existența demonstrativă a acestui lucru schimbă paradigmele de design pentru viitoarele generații de dispozitive wearable. Ochelarii AR care "aud" mediul și generează ghidare audio contextuală sau efecte sonore augmentate perfect sincronizate cu realitatea vizuală nu mai sunt science-fiction.
Riscuri și Etică: Deepfake-ul Multimodal Perfect
Ca orice tehnologie puternică, Genie 4 aduce cu el umbra răului. Capacitatea de a genera video și audio coerenți, fizic corecți și temporale sincronizate în timp real este arma supremă a dezinformației. Nu mai este vorba de lip-syncing slab sau de artefacte audio-video dezacordate. Un atacator poate genera o conferință de presă falsă a unui lider mondial, cu acustica camerei corectă, zgomotul de fond al ventilatoarelor, tusea naturală și micro-expresii faciale corelate cu intonația vocii.
DeepMind a menționat guardrails (bariere de siguranță) – watermarking invizibil (SynthID), restricții de acces API, red-teaming extensiv. Dar istoria ne învață că modelele open-source sau cele "scurse" (leaked) apar inevitabil. Comunitatea de securitate cibernetică trebuie să dezvolte detectoare care analizează coerența fizică cross-modală – verificând dacă spectrograma audio corespunde exact simulării fizice a scenei video – o cursă de tălpăni cu generatorii.
Poziționarea Strategică: DeepMind vs. OpenAI vs. Meta
Lansarea Genie 4 este și un mesaj strategic clar. OpenAI a pariat pe Sora (video) și pe modelele GPT (text/reasoning), dar a fost mai lent în integrarea audio nativ avansat (Voice Mode este impresionant, dar separat de modelul video). Meta a pariat pe modelele open-source (Llama, AudioCraft, VideoJEPA), dar lipsește integrarea strânsă într-un singur model mondial unificat.
DeepMind, cu ereditața AlphaGo, AlphaFold și acum Genie, pariază pe înțelegerea lumii (world understanding). Genie 4 nu este un model de generare de conținut pentru creatori; este un motor de simulare a realității pentru agenți. Aceasta este calea către Inteligența Artificială Generală (AGI) așa cum o vede Demis Hassabis: agenți care învață modele interne ale lumii prin observare și interacțiune, capabili să planifice și să raționeze în spațiu și timp, folosind toate senzorii.
Concluzie: Începutul Errei "Simulării Perfecte"
Genie 4 nu este produsul final; este punctul de plecare al unei noi ere. O eră în care distincția dintre "simulat" și "real" devine tehnic irelevantă pentru majoritatea aplicațiilor practice. Vom trebui să ne obișnuim cu ideea că mediile virtuale au propria lor fizică sonoră, că agenții AI pot "auzi" gândurile lor (chain-of-thought externalizat audio) și că interfața computer-om devine pură conversație multimodală.
Pentru dezvoltatori, cercetători și antreprenori, mesajul este clar: pipeline-urile separate pentru video, audio, fizică și logică sunt moarte. Viitorul apartine modelelor unificate, native multimodale, care înțeleg lumea ca un tot coerent. Genie 4 este prima demonstrație la scară largă că acest viitor este aici, acum, și sună de neîncredibil de bine.
De ce este important:
Genie 4 marchează trecerea de la modele generative passive (care creează media) la modele mondiale active (care simulează realitatea fizică completă, inclusiv acustica). Aceasta accelerează dramatic robotică (sim-to-real), gaming (NPC-uri emergente) și interfețe AR/VR, dar ridică și riscurile deepfake-urilor la un nivel existential, forțând o redefinire a securității cibernetice și a eticii AI.