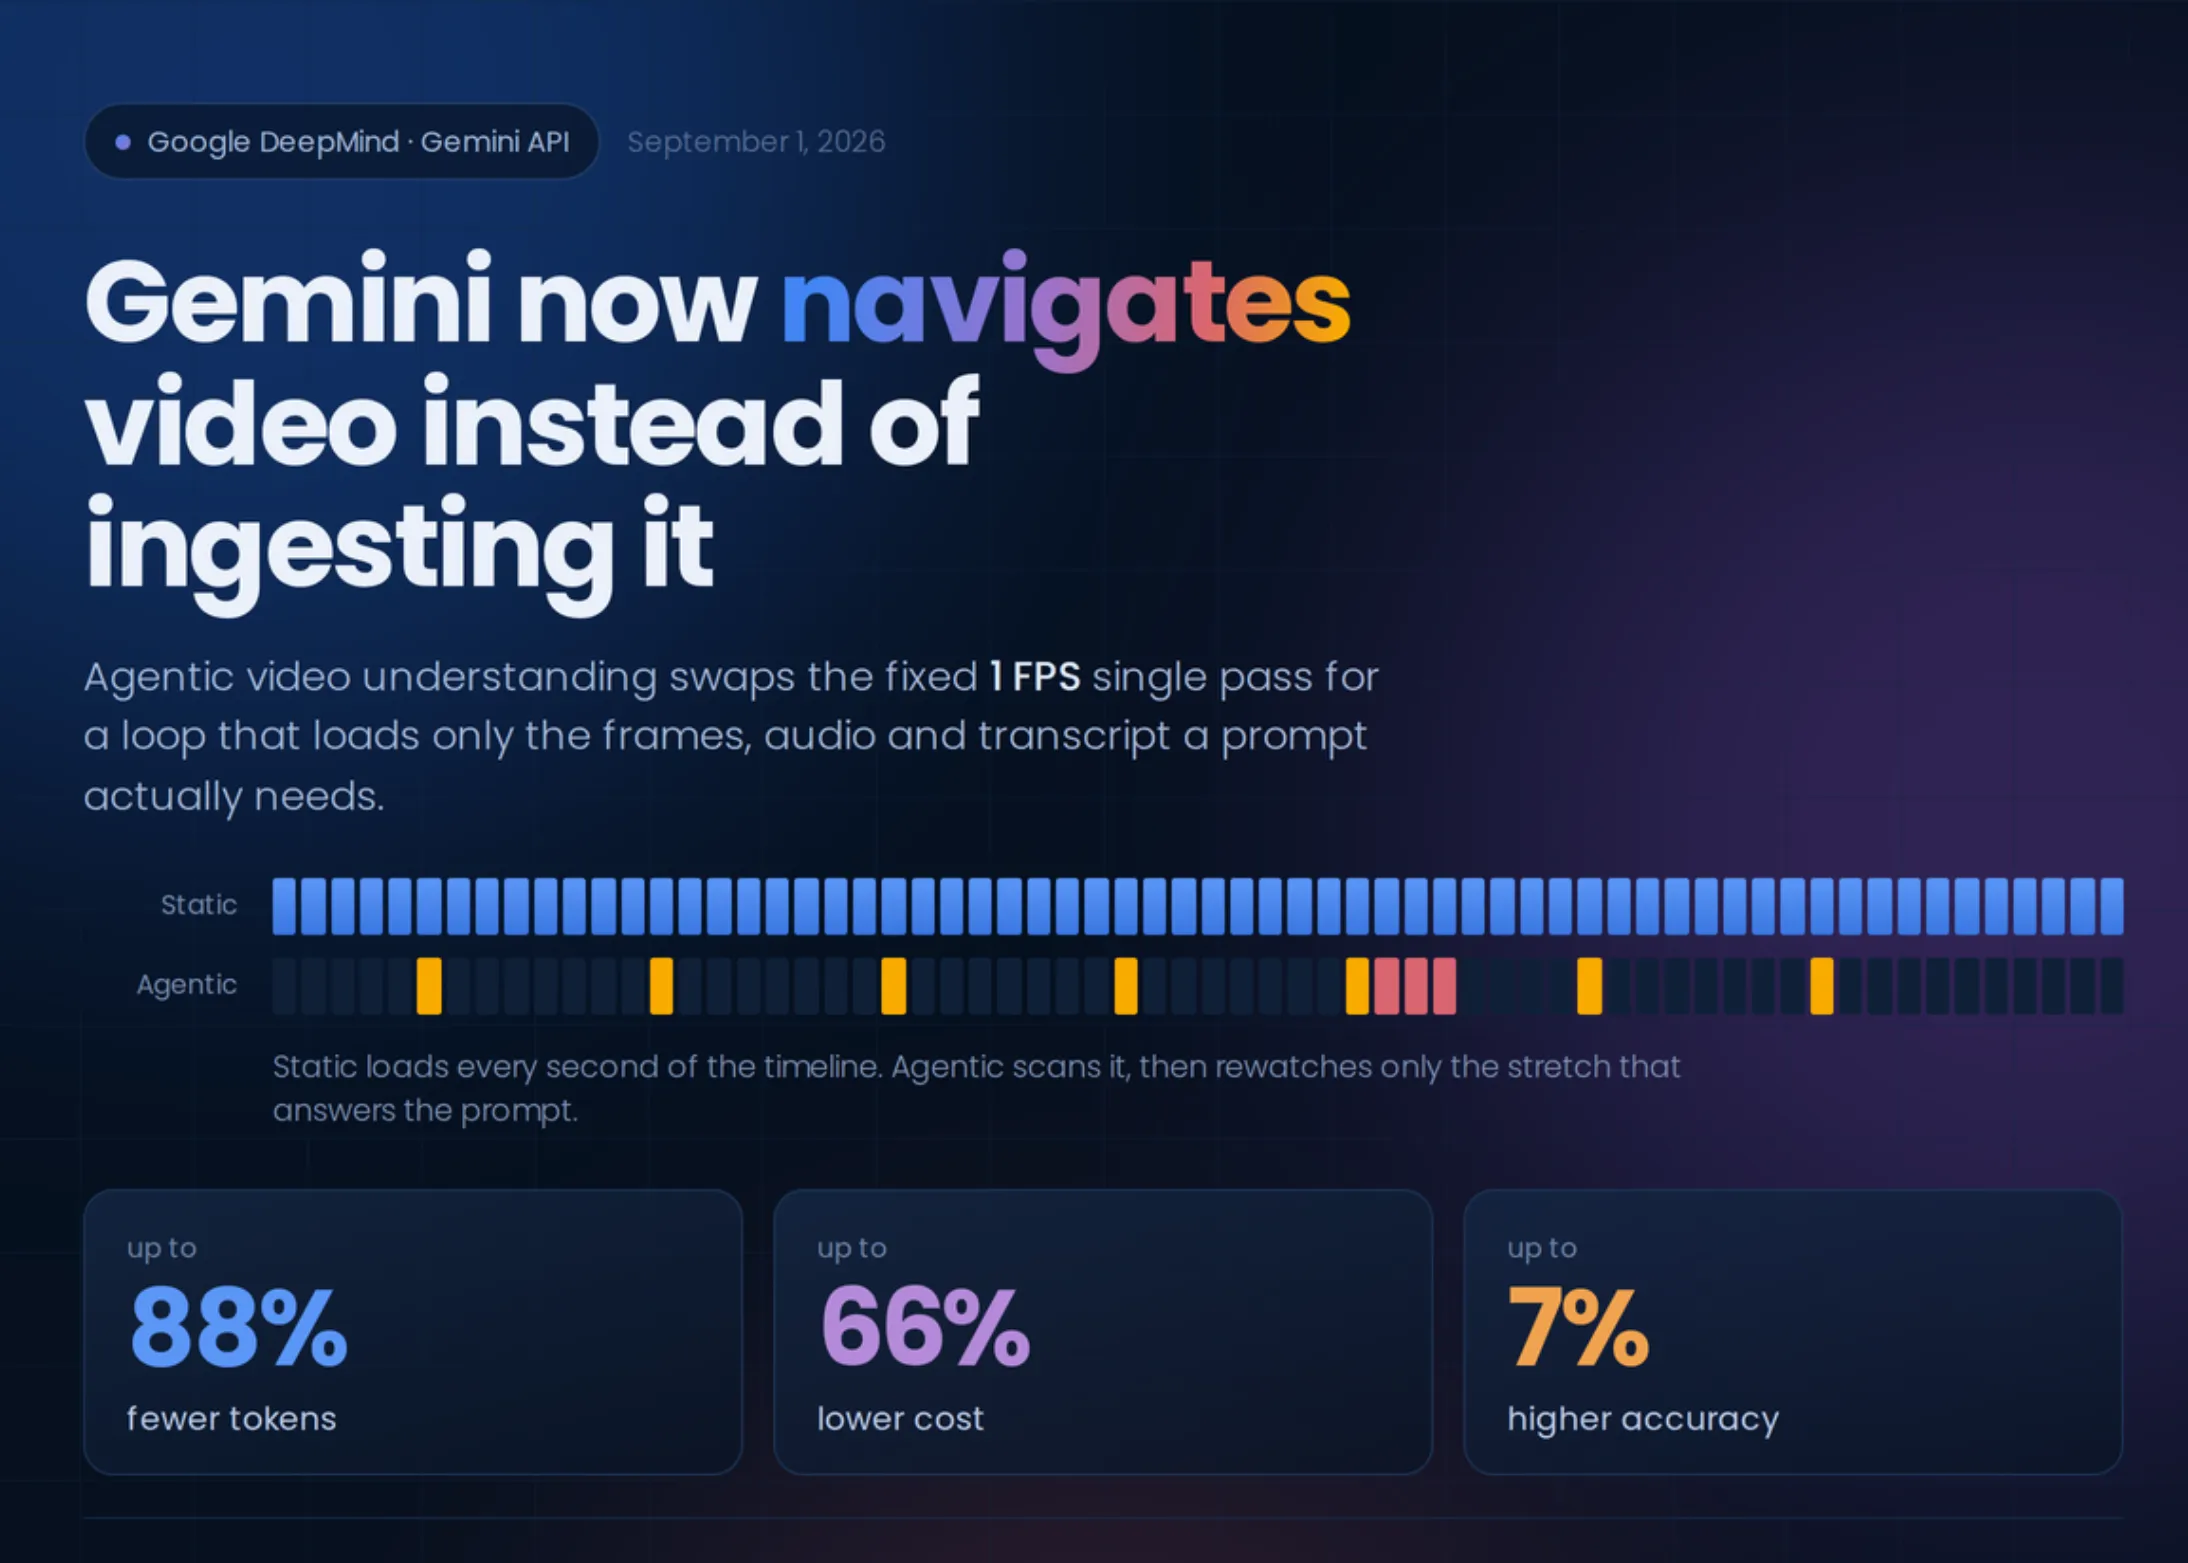
Anunțul, făcut pe blogul oficial Google AI și prezentat în cadrul evenimentului Google I/O Extended dedicat dezvoltatorilor, marchează o trecere semnificativă de la paradigmele tradiționale de procesare video — care tratau fișierele video ca pe succesiuni statice de cadre — către o abordare dinamică, agentică, în care modelul decide activ ce să examineze, când să sară peste secțiuni irelevante și cum să aloce resursele de calcul pentru o eficiență maximă.
"Nu am doar optimizat pipeline-ul existent", a declarat Oriol Vinyals, Vicepreședinte de Cercetare la Google DeepMind, într-un briefing prealabil cu presa. "Am repensat fundamental cum un model interacționează cu datele temporale. Modelul agentic nu "privește" video-ul — îl explorează, razonează asupra lui și acționează asupra lui, la fel cum un om nu citește o enciclopedie de la cap la cap, ci caută capitolele relevante, sare peste notele de subsol și sintetizează informația."
Arhitectura tehnică: dincolo de sample-urile uniforme
Tradițional, modelele video-marime (Video-LLMs) precum Video-LLaVA, LLaMA-VID sau versiunile anterioare ale Gemini procesau video-ul prin sample-uniform — extragând un număr fix de cadre (de obicei 8-32) distribuite egal pe durata clipului. Această abordare are două defecte majore: prima, pierderea evenimentelor critice care cad între cadrele sample-uite; a doua, consumul inutil de tokeni pe cadre redundantă sau irelevante (fundale statice, pauze lungi, tranziții).
Noua arhitectură agentică introdusă de Google replacează acest pipeline rigid cu un sistem de "atenție activă" orchestrat de un controller ușor (un policy network antrenat prin reinforcement learning) care primește decizii la nivel de cadru: să analizeze la rezoluție completă, să sampleze la rezoluție redusă, să sară complet sau să oprească procesarea devreme dacă a găsit răspunsul. Controller-ul este condiționat de query-ul utilizatorului — de exemplu, "la ce minut apare logo-ul companiei?" va declanșa o strategie de scanare rapidă, în timp ce "rezumă argumentul principal al prezentării" va induce o acoperire mai uniformă a segmentelor de vorbire.
Rezultatele benchmark-urilor interne sunt eloquente: pe setul de date ActivityNet-QA, Gemini 1.5 Flash cu înțelegere agentică atinge 87.3% acuratețe cu o medie de 1.200 tokeni/video, comparativ cu 2.800 tokeni pentru modelul non-agentic precedent (o reducție de 57%). Pe Video-MME (un benchmark nou, mai greu, cu video-uri de o oră+), reducerea tokenilor atinge 88% menținând performanța. Costul inferenței per minut video scade astfel de la ~$0.018 la ~$0.002 pentru Flash-8B, plasând analiza video în zona costurilor de procesare text.
Implicații practice: de la moderare de conținut la educație personalizată
Impactul economic nu poate fi superevaluat. O platformă de e-learning care analizează 10.000 de ore de lecții video lunară ar vedea costurile de inferență scăzând de la ~$10.800 la ~$1.200 — o economie care poate fi reinvestită în finetuning-uri de domeniu, generare de quiz-uri automate sau traduceri multilingve. Startup-urile de moderare de conținut, anterior forțate să folosească modele mai mici, mai puțin precise sau să limiteze analiza la cadre-cheie, pot acum rula Gemini Flash pe fluxuri live la scară industrială.
Dar reducerea costurilor este doar jumătate din poveste. Natura agentică a modelului deschide capacități calitative noi. În demonstrații live, modelul a fost întrebat: "Găsește momentul exact în care speaker-ul schimbă opinia despre reglementarea AI" într-un debat de 90 de minute. Modelul a navigat direct la minutul 47:23, a citat fraza exactă ("Într-adevăr, trebuie să recunosc că am greșit...") și a explicat contextul retoric — o sarcină care ar fi necesitat ori o analiză completă a transcrierii (costisitoare), ori o căutare manuală (lentoasă).
Un alt exemplu: dat un film de surveidență de 8 ore, comanda "Alertează-mă doar dacă o persoană intră în zona restricționată și stă mai mult de 30 de secunde" este executată cu o singură trecere a modelului, fără pipeline-uri separate de detecție, tracking și rulează bazate pe reguli. Modelul "înțelege" intenția, nu doar pattern-urile vizuale.
Competitors și contextul cursei la eficiență
Google nu este singurul care urmărește această direcție. OpenAI a sugerat capacități similare pentru GPT-4o ("video understanding with reasoning"), Anthropic a demonstrat "computer use" care include navigare video, iar modelele open-source precum Video-LLaMA 3 sau InternVideo2 experimentează cu sample-adaptiv. Diferența, susțin analiștii, constă în integrarea nativă la nivel de model (nu ca wrapper extern), în scalabilitatea infrastructurii TPU v5e a Google care permite batching-ul eficient al traiectoriilor agentice heterogene, și — critic — în pricing-ul agresiv al Flash-8B ($0.035/1M tokeni input, $0.105/1M output).
"Google joacă un joc diferit", comentează Dr. Chelsea Finn, profesor la Stanford și cercetătoră în robotică/embodied AI. "Ei nu vindește doar un model mai inteligent — vindește o infrastructură unde inteligența este cheap enough să fie ubichivă. Reducerea de 88% a tokenilor video nu este o optimizare incrementală; este un threshold economic care face viabile aplicațiile care anterior erau doar prototipuri."
Riscuri, limite și calea înaintă
Totuși, entuziasmul trebuie temperat de realități tehnice. Abordarea agentică introduce latență variabilă (deoarece numărul de pași de raționament nu este fix), ceea ce poate fi problematic pentru aplicații real-time stricte. De asemenea, policy network-ul poate "învăța să sară" peste detalii subtile dar critice — un risc cunoscut sub numele de "reward hacking" în literatura RL. Google admit că pe benchmark-uri de detecție evenimente rare (ex: "apariție de armă în film de 2 ore"), recall-ul scade de la 94% la 89% când agentul este optimizat pentru tokeni minimi.
Pentru a mitiga acest lucru, Google lansează simultan un parametru "thoroughness" (0.0-1.0) care permite dezvoltatorilor să tranzacționeze cost împotriva acurateței pe caz. De asemenea, oferă un "audit trail" al deciziilor agentice (cadrele analizate, cele sărite, raționamentul) pentru debugging și compliance.
Pe termen mediu, Google anunță extensiunea paradigmei agentice la alte modalități: navigare agentică în documente lungi (PDF-uri de 1000+ pagini), explorare agentică a bazelor de cod, chiar control agentic al robotilor prin înțelegere video a demonstrațiilor umane. "Video-ul este doar primul domeniu unde costul tokenilor face ca eficiența să fie existentială", concluzionează Vinyals. "Același principiu — inteligență care decide ce să proceseze — va defini următoarea generație de modele fundaționale."
De ce este important:
Această lansare nu este doar o actualizare incrementală a API-ului Gemini — reprezintă o schimbare de paradigă în economia AI-ului multimodal. Reducerea de 88% a tokenilor video face analiza video la scară largă economic viabilă pentru prima dată, deblocând cazuri de utilizare din educație, securitate, media, e-commerce și robotică care anterior erau blocate de costuri. Abordarea agentică (modelul decide activ ce să examineze) este mai apropiată de cognitivitatea umană decât sample-ul uniform și stabilește un nou standard pentru eficiența modelelor fundaționale. Pentru dezvoltatori români și europeni, acest lucru înseamnă acces la putere de procesare video la costuri de procesare text, eliminând o barieră majoră de intrare în inovarea AI multimodală.