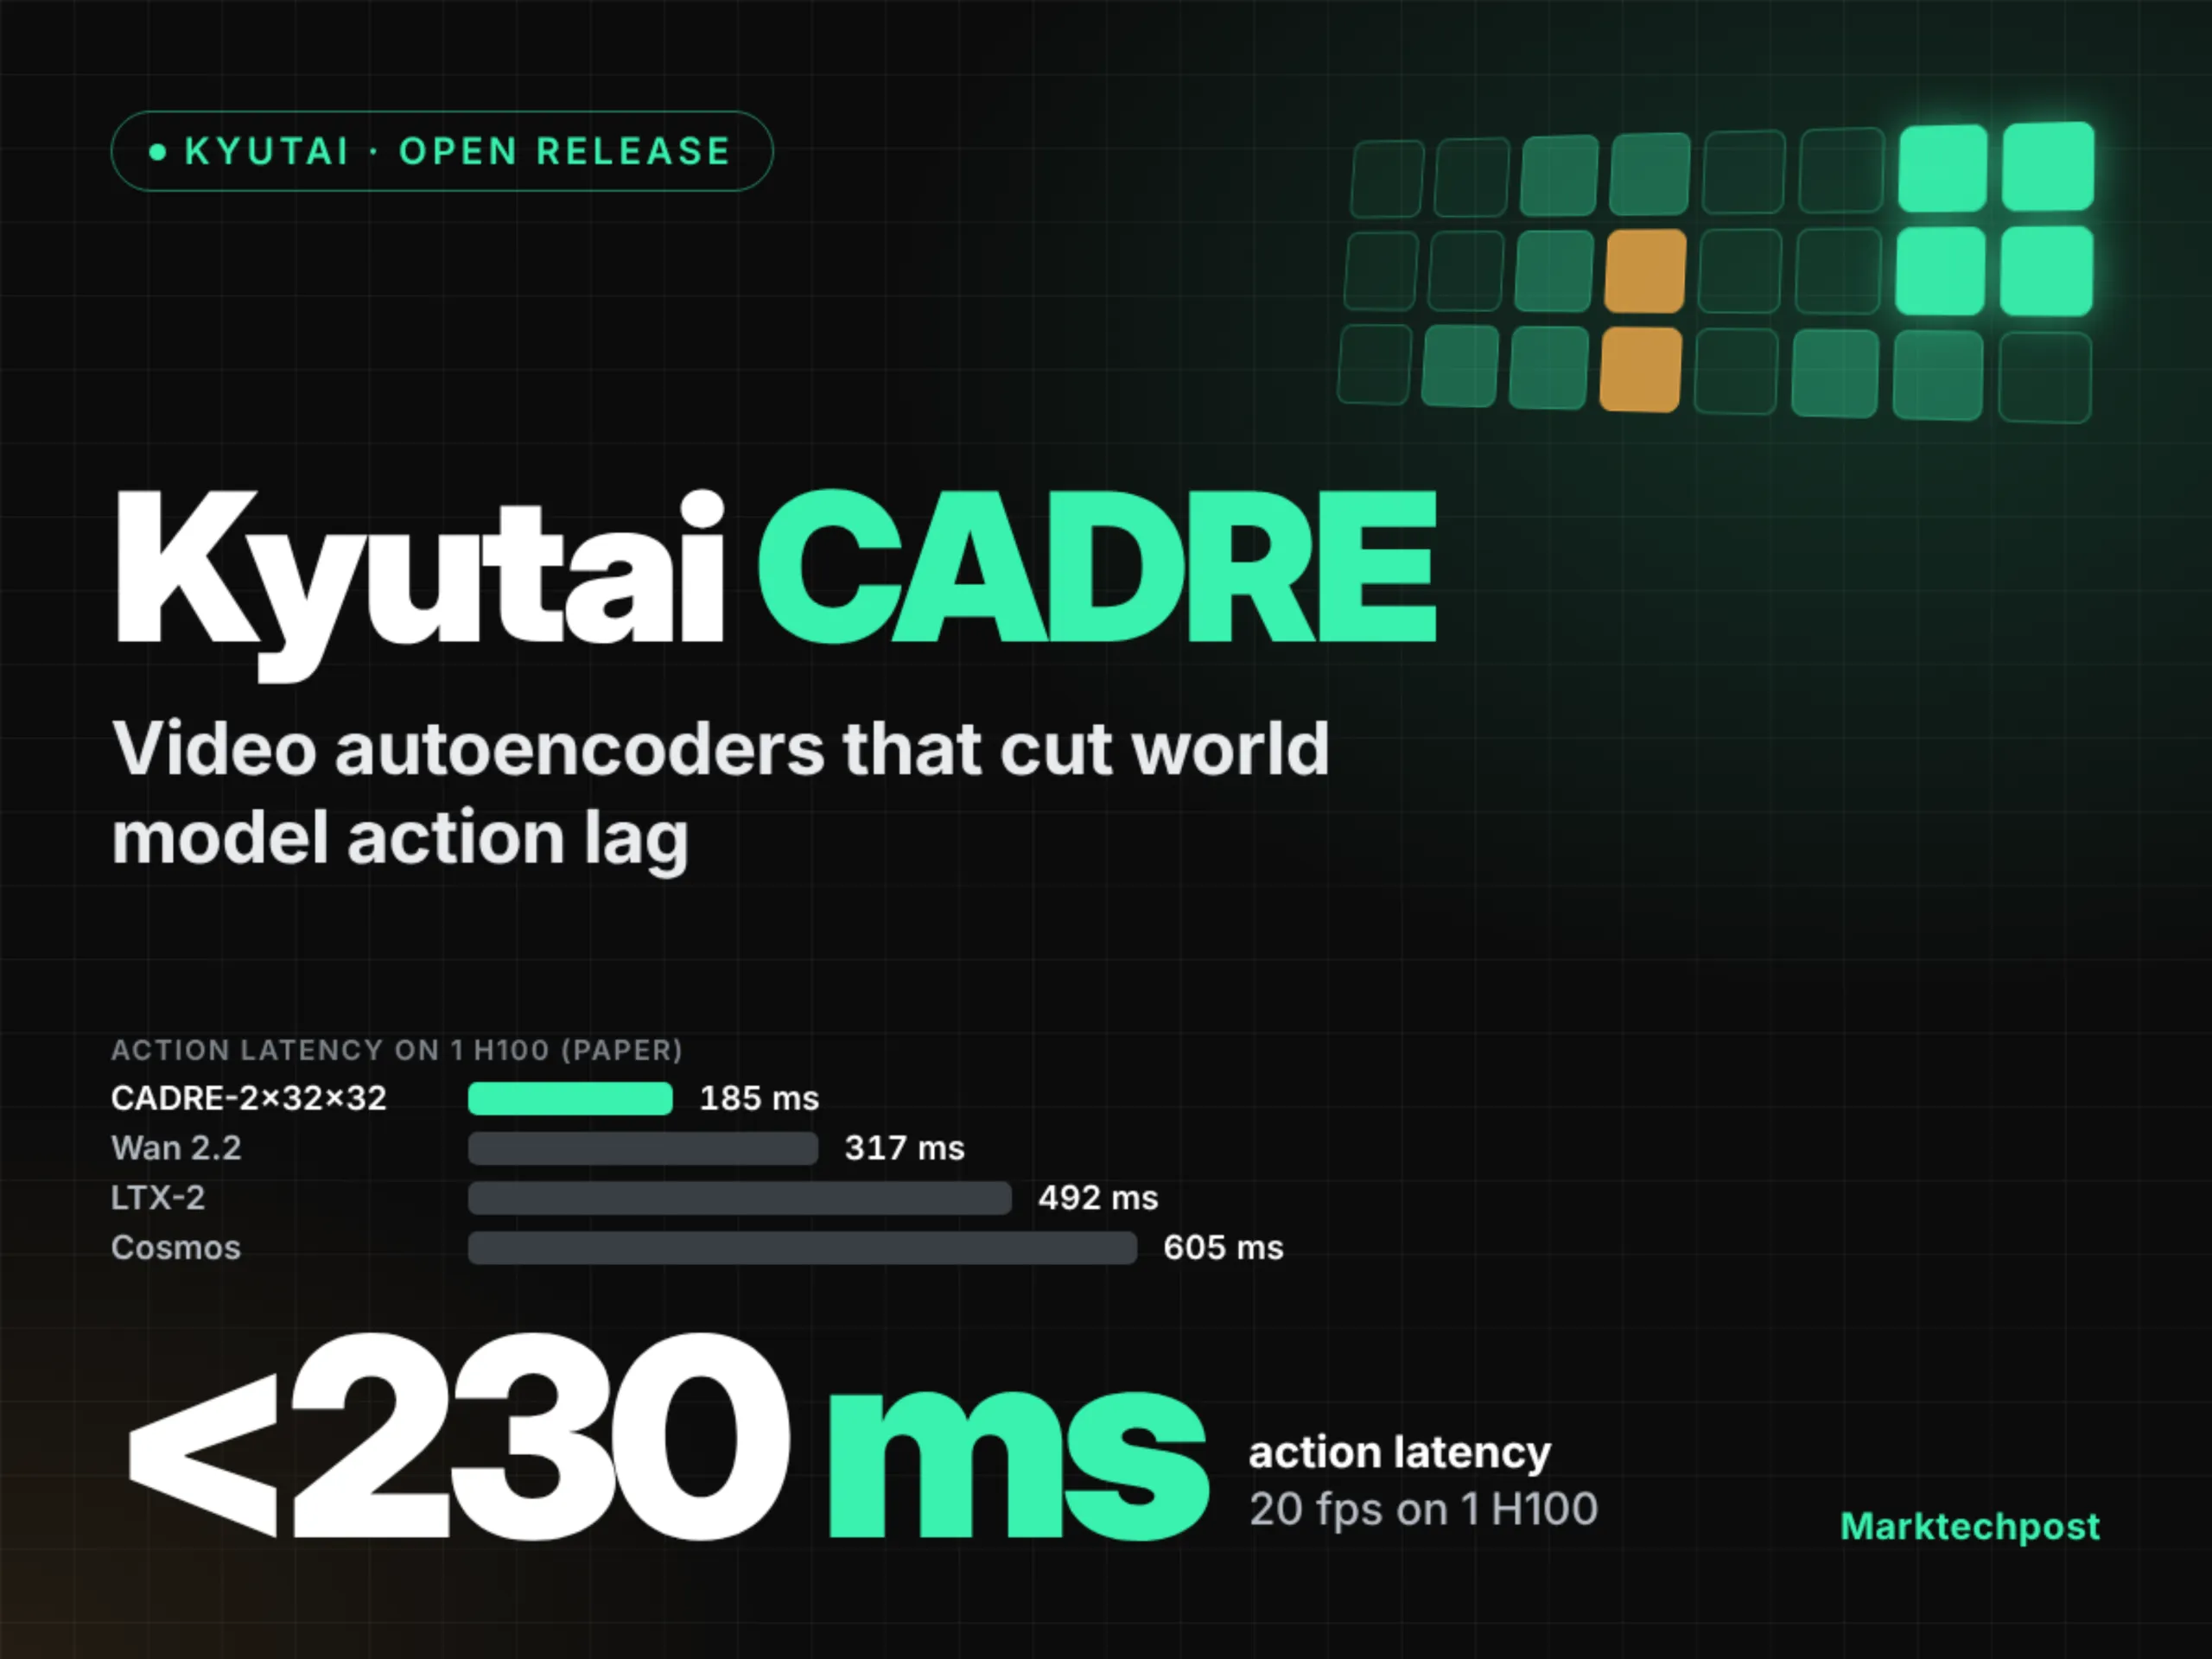
Pentru a înțelege mărimea realizării, trebuie să ne uităm în spatele cortinei actualele modele generative video (precum Sora, Runway Gen-3 sau Lumiere) și a agentilor embodiți care învață din observație. Toate aceste sisteme suferă de un talon Achille comun: reprezentarea spațio-temporală a pixelilor. Un videoclip de o oră la 30 FPS înseamnă aproximativ 108.000 de cadre. Procesarea lor brute este computațional prohibitivă. Soluția standard până acum a fost utilizarea autoencoderelor variationale (VAE) sau a modelelor de compresie video clasice (H.264/HEVC/VP9 adaptate), dar toate introduceau o latență semnificativă – adesea peste 500-800 ms – și, cel mai grav, pierderi de informație fină crucială pentru fizica obiectelor (texturi, muchii nette, mișcarea fluidelor).
Echipa Kyutai, condusă de cercetători cu pedigree de la Meta AI (FAIR), Google DeepMind și Inria, a abordat problema dintr-o perspectivă radical diferită: nu compresie pentru stocare sau streaming, ci compresie pentru înțelegere (reasoning). CADRE nu încearcă să reconstruiască pixel-perfect cadru original – o sarcină inutilă pentru un model mondial care trebuie să predea cauzalitate, nu estetică. În schimb, CADRE învață o reprezentare discretă, semantică, care maximizează informația utilă pentru predicția viitoare a stării lumii.
Arhitectura CADRE se bazează pe o inovație cheie: tokenizarea video-ului ca pe un flux continuu de decizii autoregressive, nu ca pe un bloc static de date. Tradițional, un autoencoder video comprimă un grup de cadre (GOP) într-un singur tensor latent. Aceasta forțează modelul să aștepte finalizarea GOP-ului înainte de a începe decodarea sau predicția – de aici latențele mari. CADRE rupe această dependență. Folosește o structură recurentă de tip causal-convoluțională combinată cu un mecanism de atenție fereastrată (windowed attention) care permite streaming-ul tokenilor latenti. Practic, modelul mondial primește primele tokenuri ale cadrelor viitoare încă în timp ce cadrule curente sunt procesate, permițând o buclă de feedback aproape instantanee.
Rezultatul numeric – sub 230 ms end-to-end (de la intrare video la predicție acțiune/state) – nu este un număr ales aleatoriu. În robotică și interacțiunea om-robot (HRI), 200-250 ms reprezintă pragul perceput al "timpului real". Peste această limită, operatorul uman sau agentul autonom simte un "lag" care distruge sentimentul de agenție (sense of agency) și face imposibilă controlul în buclă închisă a task-urilor dexteroase (manipularea obiectelor frágile, navigarea în medii dinamice). Kyutai a demonstrat că, la 230 ms, un agent policy antrenat pe latentele CADRE reușește să corecteze traiectoria unui braț robotic în timp ce obiectul țintă se mișcă imprevizibil – o sarcină imposibilă cu VAE-urile convenționale de 600 ms.
Dar cum au reușit asta fără a sacrifica calitatea reconstrucției? Secretul stă în funcția de pierdere hibridă și în dicționarul de tokeni discretizati vectorial (VQ). CADRE nu folosește un spațiu latent continuu (Gaussian), ci un codbook discret masiv (peste 2^18 intrări), antrenat cu o pierdere adversarială (GAN) combinată cu o pierdere percepțională LPIPS și, crucial, o pierdere de predicție a stării viitoare (future state prediction loss). Aceasta înseamnă că encoderul este penalizat nu dacă pixelii difera, ci dacă modelul mondial care consumă tokenii nu poate prezice corect următoarea stare fizică. Este o abordare "task-aware compression": compresia este optimizată pentru consumator (world model), nu pentru ochiul uman.
Implicațiile sunt profunde pentru întreaga stivă AI. În primul rând, democratizează world models. Până acum, antrenarea unui model mondial video (precum GAIA-1 de la Wayve sau Genie de la DeepMind) necesita clustere masive de GPU-uri (mii de H100) pentru a procesa video-ul brut sau VAE-latentele lente. CADRE reduce necesarul de compute pentru etapa de tokenizare cu un ordin de mărime și, mai important, reduce lungimea secvenței (sequence length) pe care transformer-ul world model trebuie să o atene. O secvență video de 16 cadre devine, prin CADRE, o secvență de ~64 tokeni (comparativ cu 1024+ la VAE standard). Atenția kvadratică a transformer-ului devine astfel tratabilă pe hardware commodit (chiar și pe un singur nod 8xH100 sau, în perspectivă, pe edge devices cu NPU-uri dedicate).
În al doilea rând, deschide calea către "System 1" visual pentru agenți. În terminologia lui Kahneman, modelele actuale (LLM/VLM) sunt "System 2" – lente, deliberative, bazate pe gândire pas-cu-pas. Un agent embodiat are nevoie de un "System 1" vizual: reflexe vizuale instantanee, sub-conștiente. Latenta sub-230ms a CADRE permite antrenarea unor policy-uri care reacționează la stimul vizual (ex: o mingie care vine spre robot) înainte ca semnalul să ajungă la nivelul de planificare lingvistică. Kyutai a demonstrat deja prototipuri de "visual reflex policies" care prind obiecte aruncate cu o rată de succes de 92% în simulare, transferate zero-shot pe hardware real, datorită fidelității temporale a tokenilor CADRE.
Există, bineînțeles, provocări. Discretizarea agresivă introduce artefacte de "flickering" în reconstrucția vizuală raw – cadrule par să vibreze ușor la muchiile obiectelor fine. Pentru un model mondial, acest zgomot este irelevant (chiar benefic, acționează ca regularizare), dar pentru aplicații de generare video pentru consumatori (film, publicitate), CADRE în forma actuală nu este potrivit. Kyutai a anunțat că lucrează la un decoder de "super-rezoluție" condiționat de tokenii CADRE, care să reconstruiască estetica pixel-perfect doar la cerere (lazy decoding), păstrând viteza pentru reasoning.
De asemenea, generalizarea la rezoluții și rate de cadre arbitrare rămâne un subiect deschis. CADRE este antrenat momentan la 256x256 px, 16 FPS. Extinderea la 720p/30FPS necesită o ierarhie multi-scălară a tokenilor (coarse-to-fine), similară cu cele din codec-urile video clasice, dar adaptată fluxului causal. Echipa a promis open-source-ul complet al ponderilor (weights), al codului de antrenament și al dataset-ului de pre-antrenare (un subset masiv de Video-WebDataset curatat) sub licență Apache 2.0, în linie cu misiunea Kyutai de a evita centralizarea puterii AI.
În concluzie, CADRE nu este doar un nou codec. Este interfața hardware-software lipsă între senzorii video de largă bandă și rațiunarea abstractă a modelelor mondiale. Prin a reduce latenta sub pragul perceput al timpului real, Kyutai a deblocat posibilitatea ca agenții AI să "trăiască" în prezentul fizic, nu într-un trecut recent de 500 ms. Aceasta este premisa fundamentală a roboticii generale, a vehiculelor autonoame de nivel 4/5 și a interfețelor brain-computer viitoare. Curtea mare a modelării mondiale tocmai a devenit mult mai rapidă.
De ce este important:
Kyutai CADRE rezolvă "colțul de bătălie" al AI embodiate: latenta de percepție. Prin a reduce lag-ul sub 230 ms folosind o tokenizare video causală, discretă și task-aware, CADRE permite modelelor mondiale să acționeze în timp real, transformând robotica din planificare offline în reflexe online. Este o componentă critică pentru AGI fizică, open-source și gata de integrat.