
Să începem cu începutul. Qwen este o familie de modele lingvistice dezvoltată de gigantul chinez Alibaba, recunoscută pentru performanța solidă pe o gamă largă de sarcini. Versiunea de 27 de miliarde de parametri este una dintre vedetele open-source, folosită de cercetători, dezvoltatori și companii din întreaga lume. Dar Qwen, ca orice model mare, are un apetit pe măsură: necesită resurse computaționale considerabile pentru a rula la capacitate maximă. Aici intră în scenă cuantificarea — un proces prin care greutățile modelului sunt comprimate, pierzând o parte din precizie, dar câștigând eficiență.
Acum, cuantificarea nu este o noutate. Cercetătorii comprimă modele de ani de zile, reducând precizia de la 16 biți la 8 biți, la 4 biți, ba chiar și la 2 biți. Fiecare pas în jos vine de obicei cu o degradare a performanței — modelul devine mai rapid și mai ușor, dar și mai "prost", ca să spunem așa. Gândește-te la asta ca la o fotografie: cu cât comprimi mai mult fișierul JPEG, cu atât pierzi din detalii. Până acum, regula era clară — vrei calitate, plătești în biți.
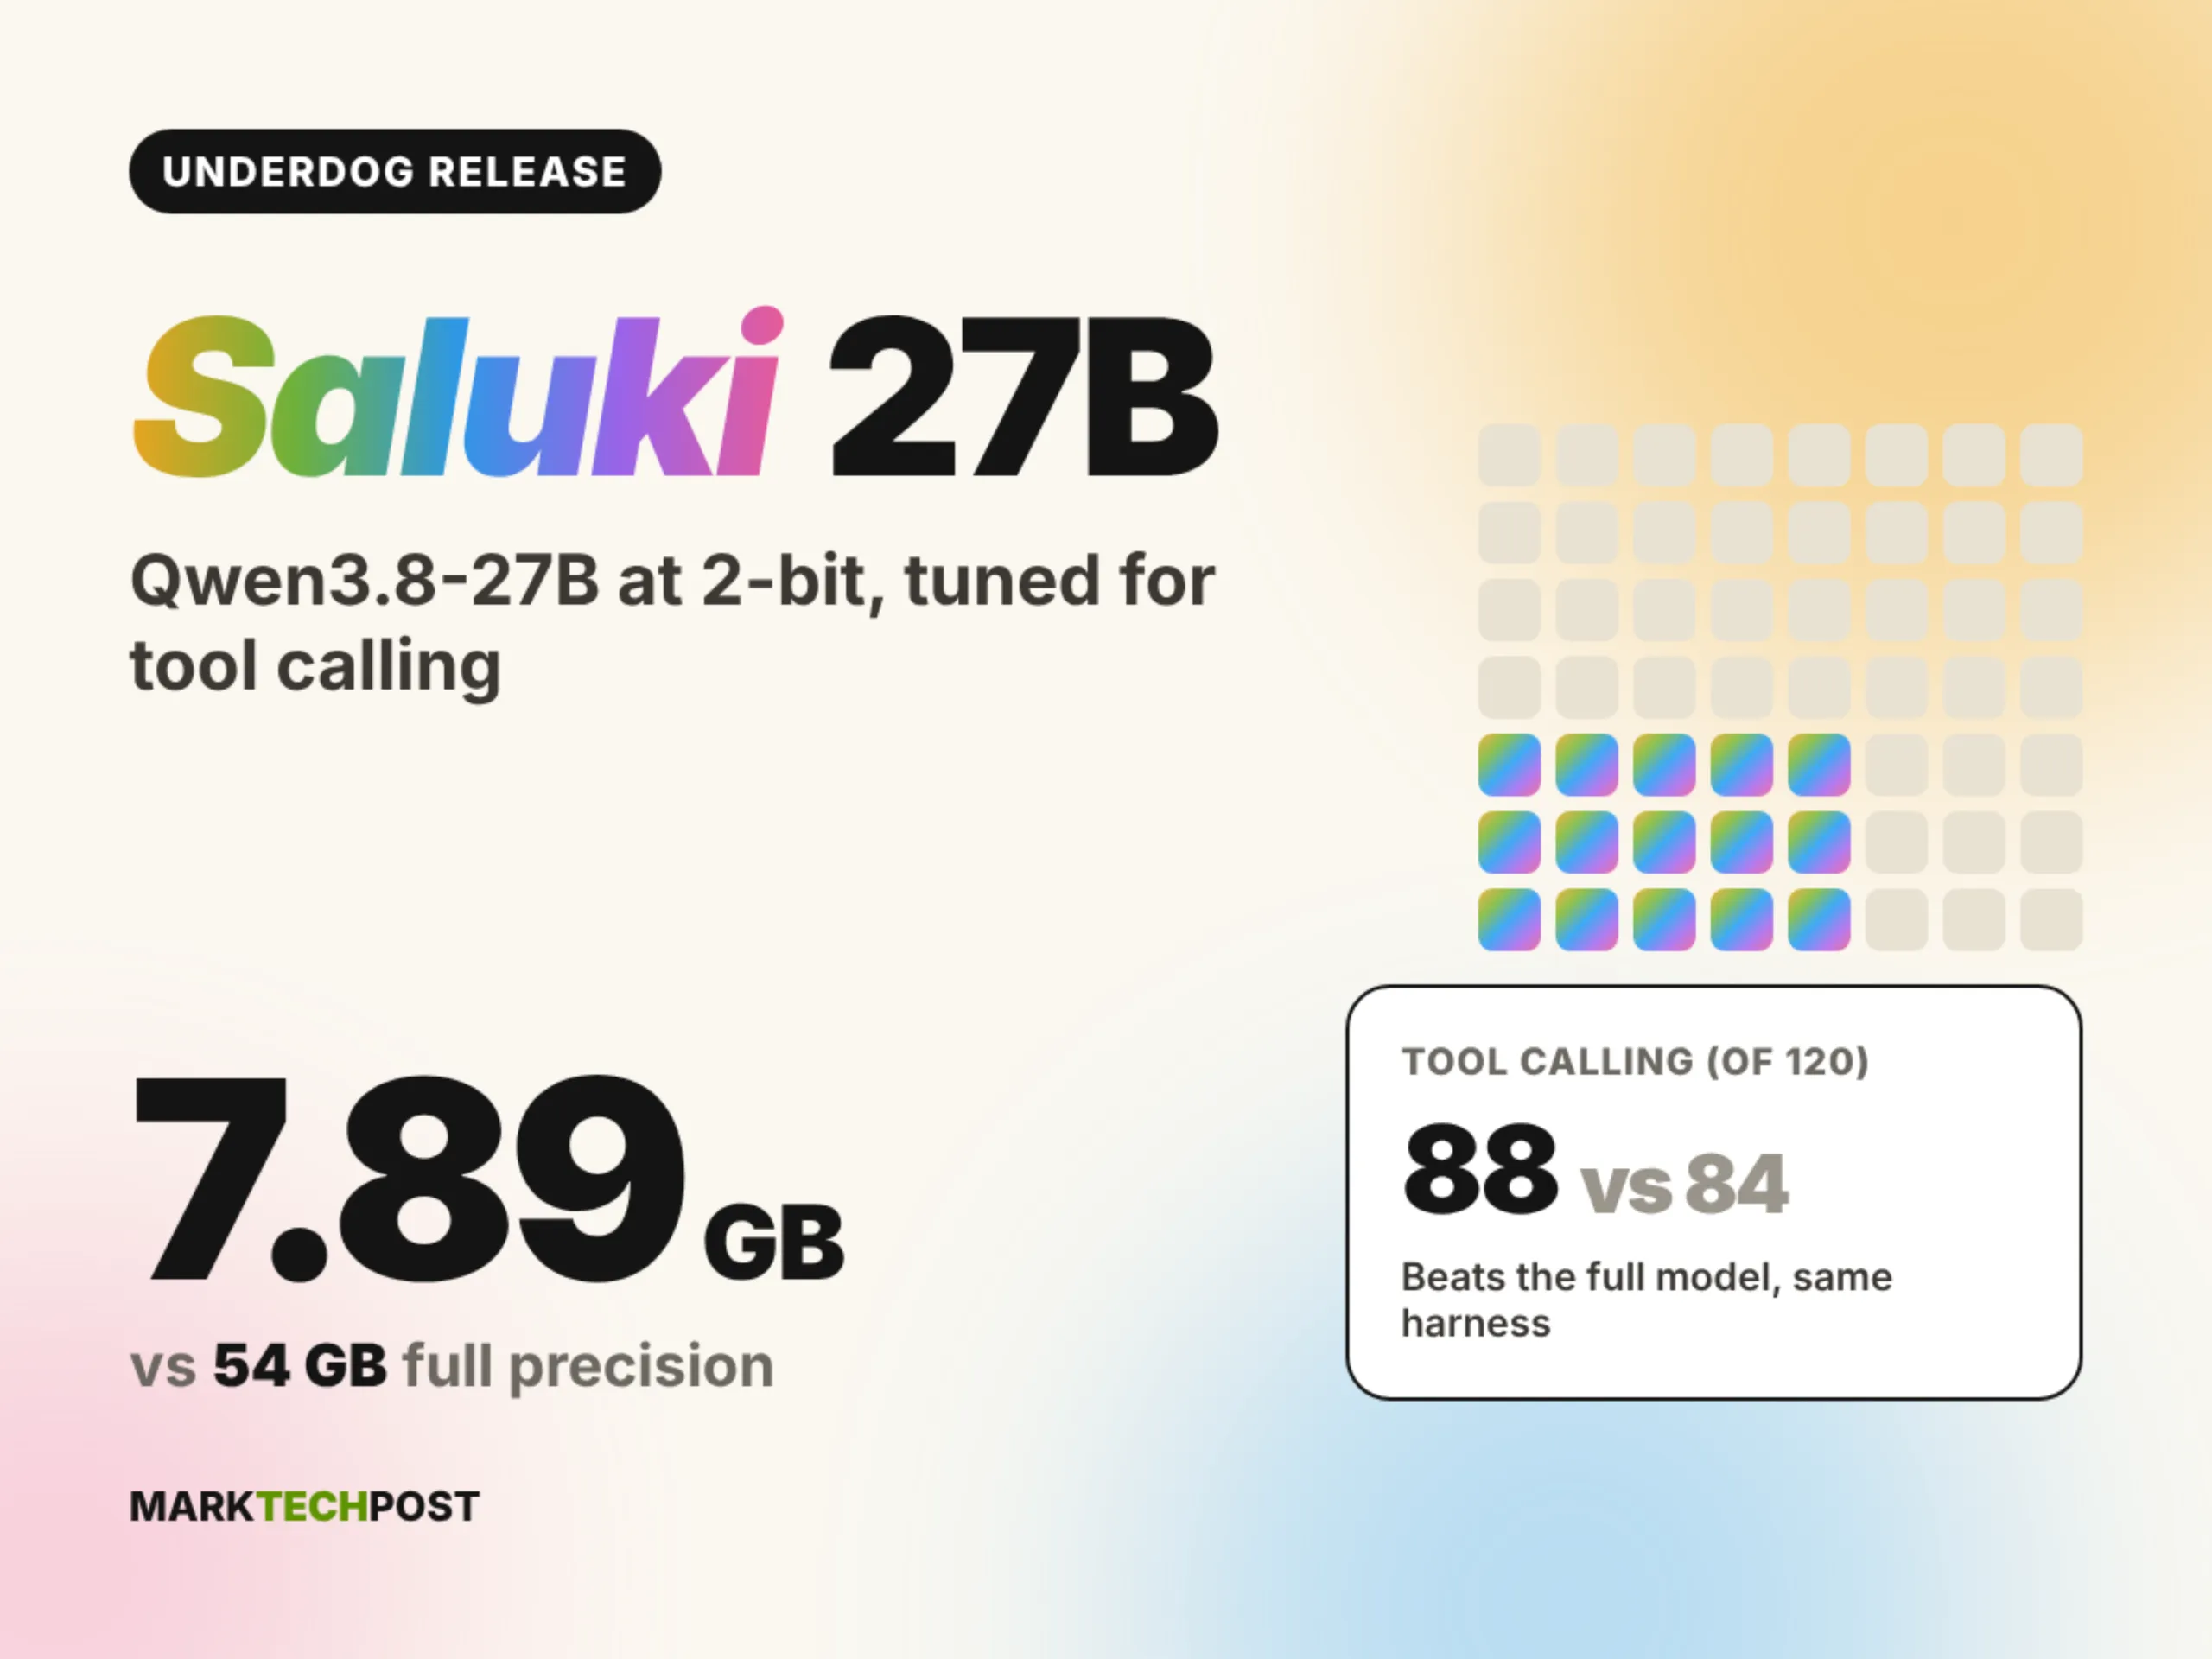
Saluki 27B a spart această regulă cu bâta. Folosind o tehnică de cuantificare extremă, la doar 2 biți, acest model nu doar că a reușit să rămână funcțional, ci a depășit versiunea originală Qwen3.8-27B la una dintre cele mai critice sarcini din era agenților AI: apelul de instrumente, sau "tool calling" în engleză. Da, ai citit bine. Un model comprimat, mai mic, mai eficient, bate originalul la bătaie.
Dar ce este mai exact tool calling și de ce contează atât de mult? În ecosistemul modern al AI, modelele nu mai sunt doar niște cutii care scriu texte frumoase. Ele sunt creierele din spatele agenților inteligenți — programe care pot acționa autonom, pot interacționa cu API-uri, pot executa comenzi, pot face rezervări, pot trimite email-uri, pot programa întâlnite. Pentru a face toate astea, modelul trebuie să "sune" instrumente externe, să primească răspunsuri și să integreze informațiile în fluxul său decizional. Capacitatea de a face acest lucru corect, rapid și fiabil este ceea ce diferențiază un model util de unul decorativ. Și Saluki 27B excelează aici.
Cum e posibil așa ceva? Ei bine, aici intră în discuție câteva fenomene interesante. În primul rând, cuantificarea la 2 biți nu este un proces simplu de "tăiere și strângere". Algoritmii moderni folosesc tehnici avansate pentru a păstra informațiile critice și a elimina zgomotul. În al doilea rând, anumite sarcini, cum ar fi tool calling, sunt poate mai puțin sensibile la pierderea de precizie decât, să zicem, raționamentul matematic complex sau generarea de text creativ. Un model comprimat poate pierde finețea în poezie, dar poate rămâne perfect capabil să formateze corect un apel JSON pentru un API.
Există și un al treilea factor, mai subtil, dar la fel de important. Antrenamentul. Modelele cuantificate suferă adesea un proces de fine-tuning post-cuantificare, în care sunt re-antrenați pe seturi de date mai mici pentru a "recompensa" pierderile de performanță. Dacă acest fine-tuning s-a concentrat pe scenarii de tool calling, nu e de mirare că modelul excelează exact acolo.
Comunitatea open-source a primit vestea cu entuziasm, dar și cu scepticism. Mulți dezvoltatori au descărcat modelul, l-au testat pe propriile aplicații și au raportat rezultate consistente. Pe forumuri și pe Discord, comentariile sunt în mare parte pozitive — lumea e uimită că un model atât de mic poate face față unor sarcini complexe. Desigur, sunt și voci care spun că performanța depinde mult de tipul de tool calling și de complexitatea instrumentelor folosite. Dar tendința generală e clară: Saluki 27B este o realizare tehnică serioasă.
Implicațiile practice sunt uriașe. Pentru startup-uri și dezvoltatori independenți care nu-și permit clustere de GPU-uri de ultimă generație, un model care rulează eficient pe hardware modest este un dar din cer. Pentru companiile mari, e o oportunitate de a reduce costurile operaționale fără a sacrifica funcționalitatea. Pentru cercetători, e o dovadă că încă nu am atins limitele a ceea ce se poate face cu cuantificarea.
Dar, ca orice poveste din lumea AI, nu totul e roz. Un model cuantificat la 2 biți este, prin definiție, o versiune mai puțin precisă a originalului. Pentru sarcini care necesită raționament profund, generare de conținut creativ sau precizie factuală ridicată, Qwen-ul original sau alte modele mai mari rămân superioare. Saluki 27B nu e un înlocuitor complet — e o unealtă specializată, optimizată pentru anumite scenarii.
Și aici ajungem la o lecție mai amplă pe care comunitatea AI o învață, poate mai greu decât ar trebui. Nu întotdeauna cel mai mare model este cel mai potrivit. Alegerea instrumentului potrivit pentru sarcina potrivită este o artă. Saluki 27B ne amintește că eficiența, nu dimensiunea, ar trebui să fie adesea criteriul decisiv. Mâine, s-ar putea să avem modele cuantificate la 1 bit care să bată recorduri. Cine știe? Lumea AI se mișcă rapid, iar regulile se schimbă în fiecare lună.
Cert este că Saluki 27B a reușit ceva ce mulți considerau imposibil: să comprimi un model până la punctul în care devine aproape de nerecunoscut ca dimensiune, și totuși să-l faci mai bun la sarcina lui principală. Este o dovadă a ingeniozității comunității open-source și un semn că viitorul AI nu aparține neapărat celor cu cele mai mari buzunare, ci celor cu cele mai bune idei.
De ce este important:
Acest model demonstrează că cuantificarea agresivă nu mai este sinonimă cu degradarea performanței. Pentru dezvoltatorii care construiesc agenți AI cu resurse limitate, Saluki 27B oferă o alternativă viabilă la modelele masive, democratizând accesul la capabilități avansate de tool calling. Pe termen lung, astfel de realizări pot accelera adoptarea AI în companii mici și medii, pot reduce bariera de intrare în domeniu și pot forța giganții tehnologici să-și regândească strategiile de optimizare. E un moment definitoriu pentru filosofia "small is beautiful" în inteligența artificială.