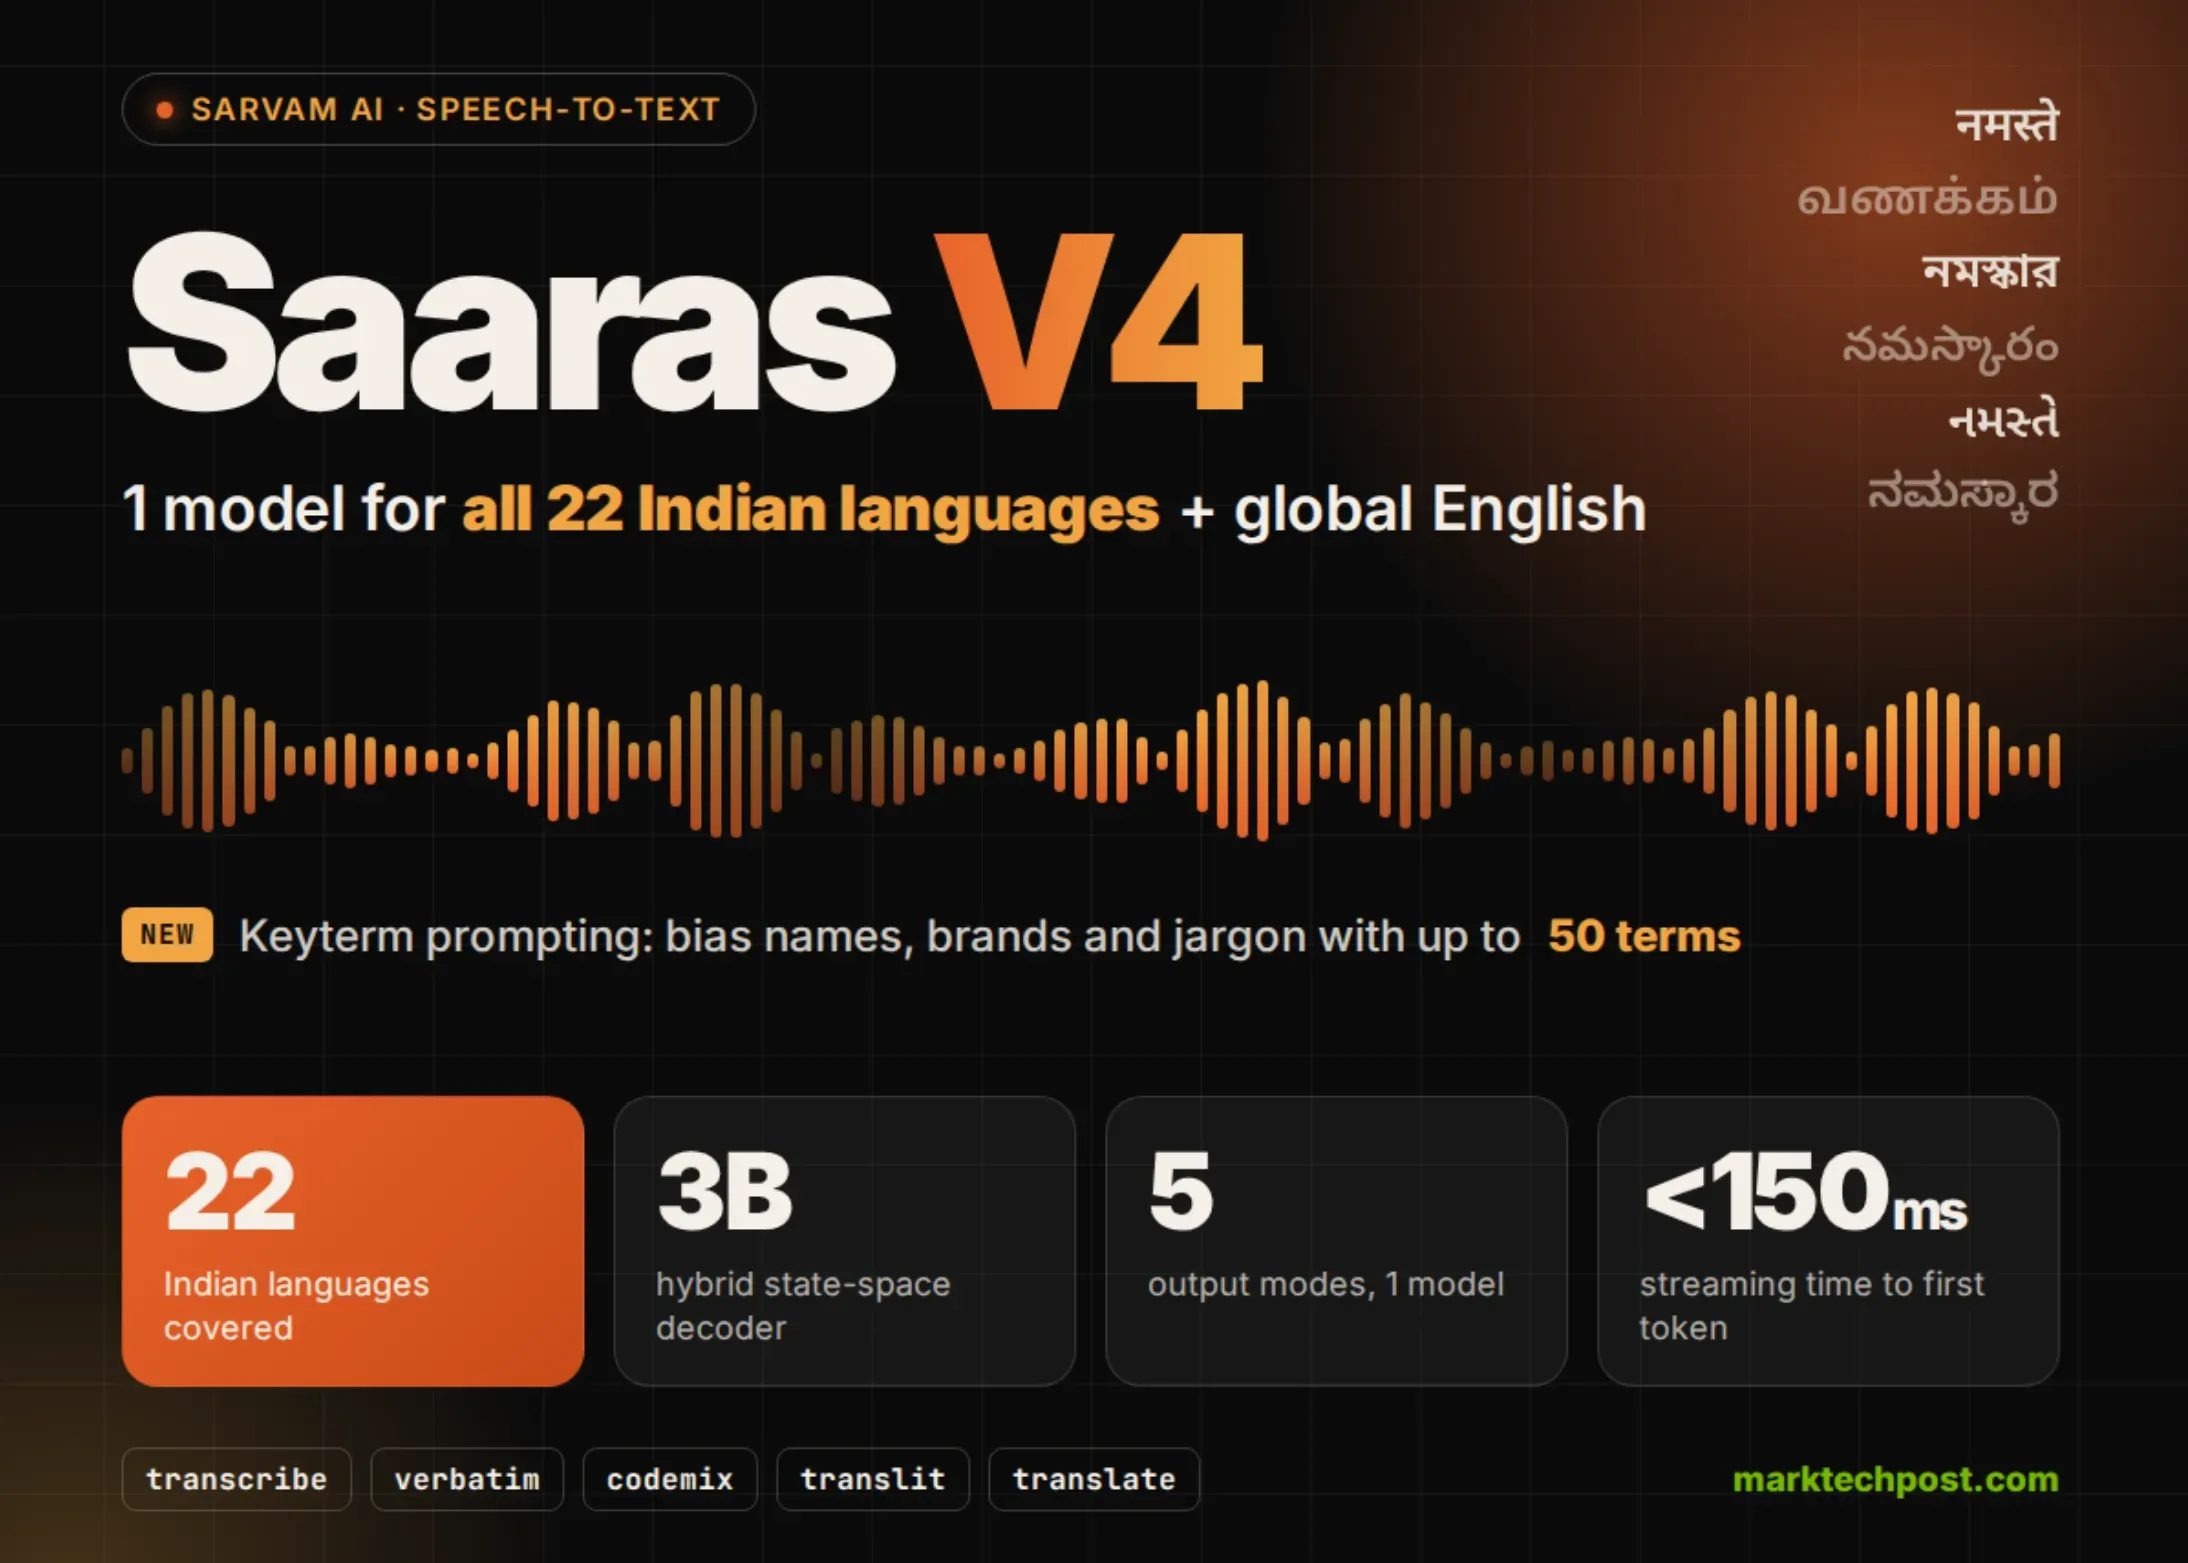
Pentru cei inițiați, Sarvam AI nu este un jucător nou pe piață. Fondată de cercetătorii Vivek Raghavan și Pratyush Kumar, compania s-a născut dintr-o frustrare fundamentală: majoritatea modelelor STT de top (Whisper de la OpenAI, modelele Google sau Meta) funcționează minunat pentru engleză, chineză sau spaniolă, dar se prăbușesc dezastruos în fața diversității lingvistice a Indiei. Nu vorbim aici de dialecte obscure, ci de limbi cu zeci de milioane de vorbitori – hindi, bengali, telugu, marathi, tamil, urdu, gujarati, kannada, odia, malayalam, punjabi, asameză și lista continuă – care au fost, până recent, "copiii răi" ai revoluției AI.
Saaras V4 vine să schimbe exact această narativă. Conform detaliilor tehnice publicate de echipă, arhitectura modelului a fost repensată de la bază pentru a gestiona ceea ce specialiștii numesc "code-switching" (comutarea de cod) – fenomenul extrem de comun în India unde un vorbitor trece fluid din hindi în engleză, apoi poate în limba maternală regională, într-o singură propoziție. Modelele tradiționale, antrenate pe seturi de date "curate" (monolingve), halucină sau oprește transcrierea în momentul schimbării limbii. Saaras V4, însă, a fost antrenat pe un corpus masiv de date audio reale, zgomotose, preluate din contexturi de zi cu zi: apeluri de servicii clienti, emisiuni radio locale, discuții pe WhatsApp, lecții online. Aceasta nu este o performanță de laborator; este o performanță de "câmp de luptă".
O analiză a benchmark-urilor interne, dar și a unor teste independente rulate de comunitatea de dezvoltatori indieni, arată o reducere semnificativă a Ratei de Eroare a Cuvintelor (WER - Word Error Rate) pentru limbi ca odia, asameza sau kashmiri – limbi care, până acum, erau practic inaccesibile pentru automatizare. Pentru engleză, modelul se aliniază performanței modelului Whisper Large-v3, dar cu o fracțiune din parametrii și, crucial, costurile de inferență. Aceasta nu este o detaliu minor: într-o țară unde lățimea de bandă și costurile GPU sunt o barieră reală, eficiența este o caracteristică, nu un lux.
Dar de ce este importantă această poveste pentru un observator european sau american? Pentru că India devine, treptat, laboratorul lumii pentru AI inclusivă. Dacă rezolvi problema recunoașterii vorbirii pentru 1,4 miliarde de oameni care vorbesc sute de limbi și dialecte, într-un mediu acustic haotic și pe hardware ieftin, ai rezolvat problema pentru oricine. Soluția nu este să construiești modele mai mari (paradigma "Scaling Laws" a Occidentului), ci să construiești modele mai înțelepte, mai eficiente, care respectă diversitatea. Sarvam AI pariază pe paradigmele "Small Language Models" (SLM) și pe arhitecturi specifice (precum modelele bazate pe Conformer sau variantele de Transformer optimizate pentru latență redusă), demonstrând că suveranitatea tehnologică nu înseamnă neapărat să ai cel mai mare cluster de GPU-uri, ci să ai cele mai bune date și cea mai bună înțelegere a contextului local.
Implicațiile practice sunt uriașe. Gândiți-vă la un fermier din Maharashtra care poate accesa schemele guvernamentale de subvenții vorbind în marathi în telefon, fără a trebui să navigheze un site web complex în engleză sau hindi. Gândiți-vă la o doamnă din Tamil Nadu care poate dicta un mesaj medical în tamil pentru o consultație telemedicină. Sau la un operator de call center din Bangalore care poate folosi un sistem de transcriere în timp real care înțelege amestecul de kannada și engleză al clientului. Acestea nu sunt scenarii de science-fiction; sunt cazuri de utilizare pe care Sarvam le activează acum, prin API-uri accesibile și, important, prin lansarea ponderilor modelului (open weights) pentru cercetare și dezvoltare non-comercială.
Desigur, drumul nu este fără obstacole. Comunitatea tehnică a ridicat deja întrebări legate de "hallucinations" (halucinații) în segmentele de vorbire rară sau a acentelor extrem de locale. De asemenea, licența "open weights" nu este o licență open source pură (precum MIT sau Apache 2.0), ceea ce limitează utilizarea comercială liberă – o decizie înțelegibilă pentru o startup care trebuie să construiască un model de business sustenabil, dar una care atrage critica puriștilor open source. Există și provocarea datelor: de unde vin exact cele thousands de ore de audio pentru limbi ca bodo sau dogri? Transparența seturilor de date (data provenance) va fi următorul mare câmp de luptă etic în această zonă.
Totuși, semnalul trimis de Sarvam AI cu Saaras V4 este puternic: AI-ul nu trebuie să fie un instrument de colonizare culturală, forțând toți să vorbească engleză sau chineză pentru a beneficia de tehnologie. Poate fi un instrument de emancipare digitală. Atât timp cât modelele occidentale cursează după AGI (Inteligență Artificială Generală) abstractă, jucători precum Sarvam, ai4bharat (IIT Madras) sau Bhashini (inițiativa guvernamentală) construiesc "AI-ul pentru restul noii lumi" – un AI care ascultă, înțelege și răspunde în limba ta maternă.
Lansarea Saaras V4 nu este doar un update de software; este o declarație politică și tehnologică. Arată că suveranitatea digitală a Indiei nu este un slogan, ci un produs de software gata de deployat. Și pentru restul lumii, este o lecție de umilință și inovație: viitorul AI-ului nu este monolingv, ci poliglot, nu este centralizat, ci distribuit, și nu ignoră "coada lungă" a limbilor, ci o abordează cap în cap.
De ce este important:
Lansarea Saaras V4 de către Sarvam AI reprezintă un moment pivotal pentru democratizarea accesului la tehnologie. Prin acoperirea tuturor a 22 de limbi oficiale indiene și a englezei globale într-un singur model eficient, această tehnologie elimină bariera limbii pentru sute de milioane de utilizatori care au fost exclusi din economia digitală. Demonstrează că inovația reală în AI nu vine neapărat din laboratoarele cu bugete infinite din Silicon Valley, ci din nevoia de a rezolva probleme reale, complexe și locale. Pentru industria globală, este un model de referință (blueprint) pentru construirea de sisteme AI suverane, incluzive și sustenabile, esențiale pentru viitorul unei societăți digitale globale echitabile.