Ce înseamnă arhitectura MoE cu 600B parametri
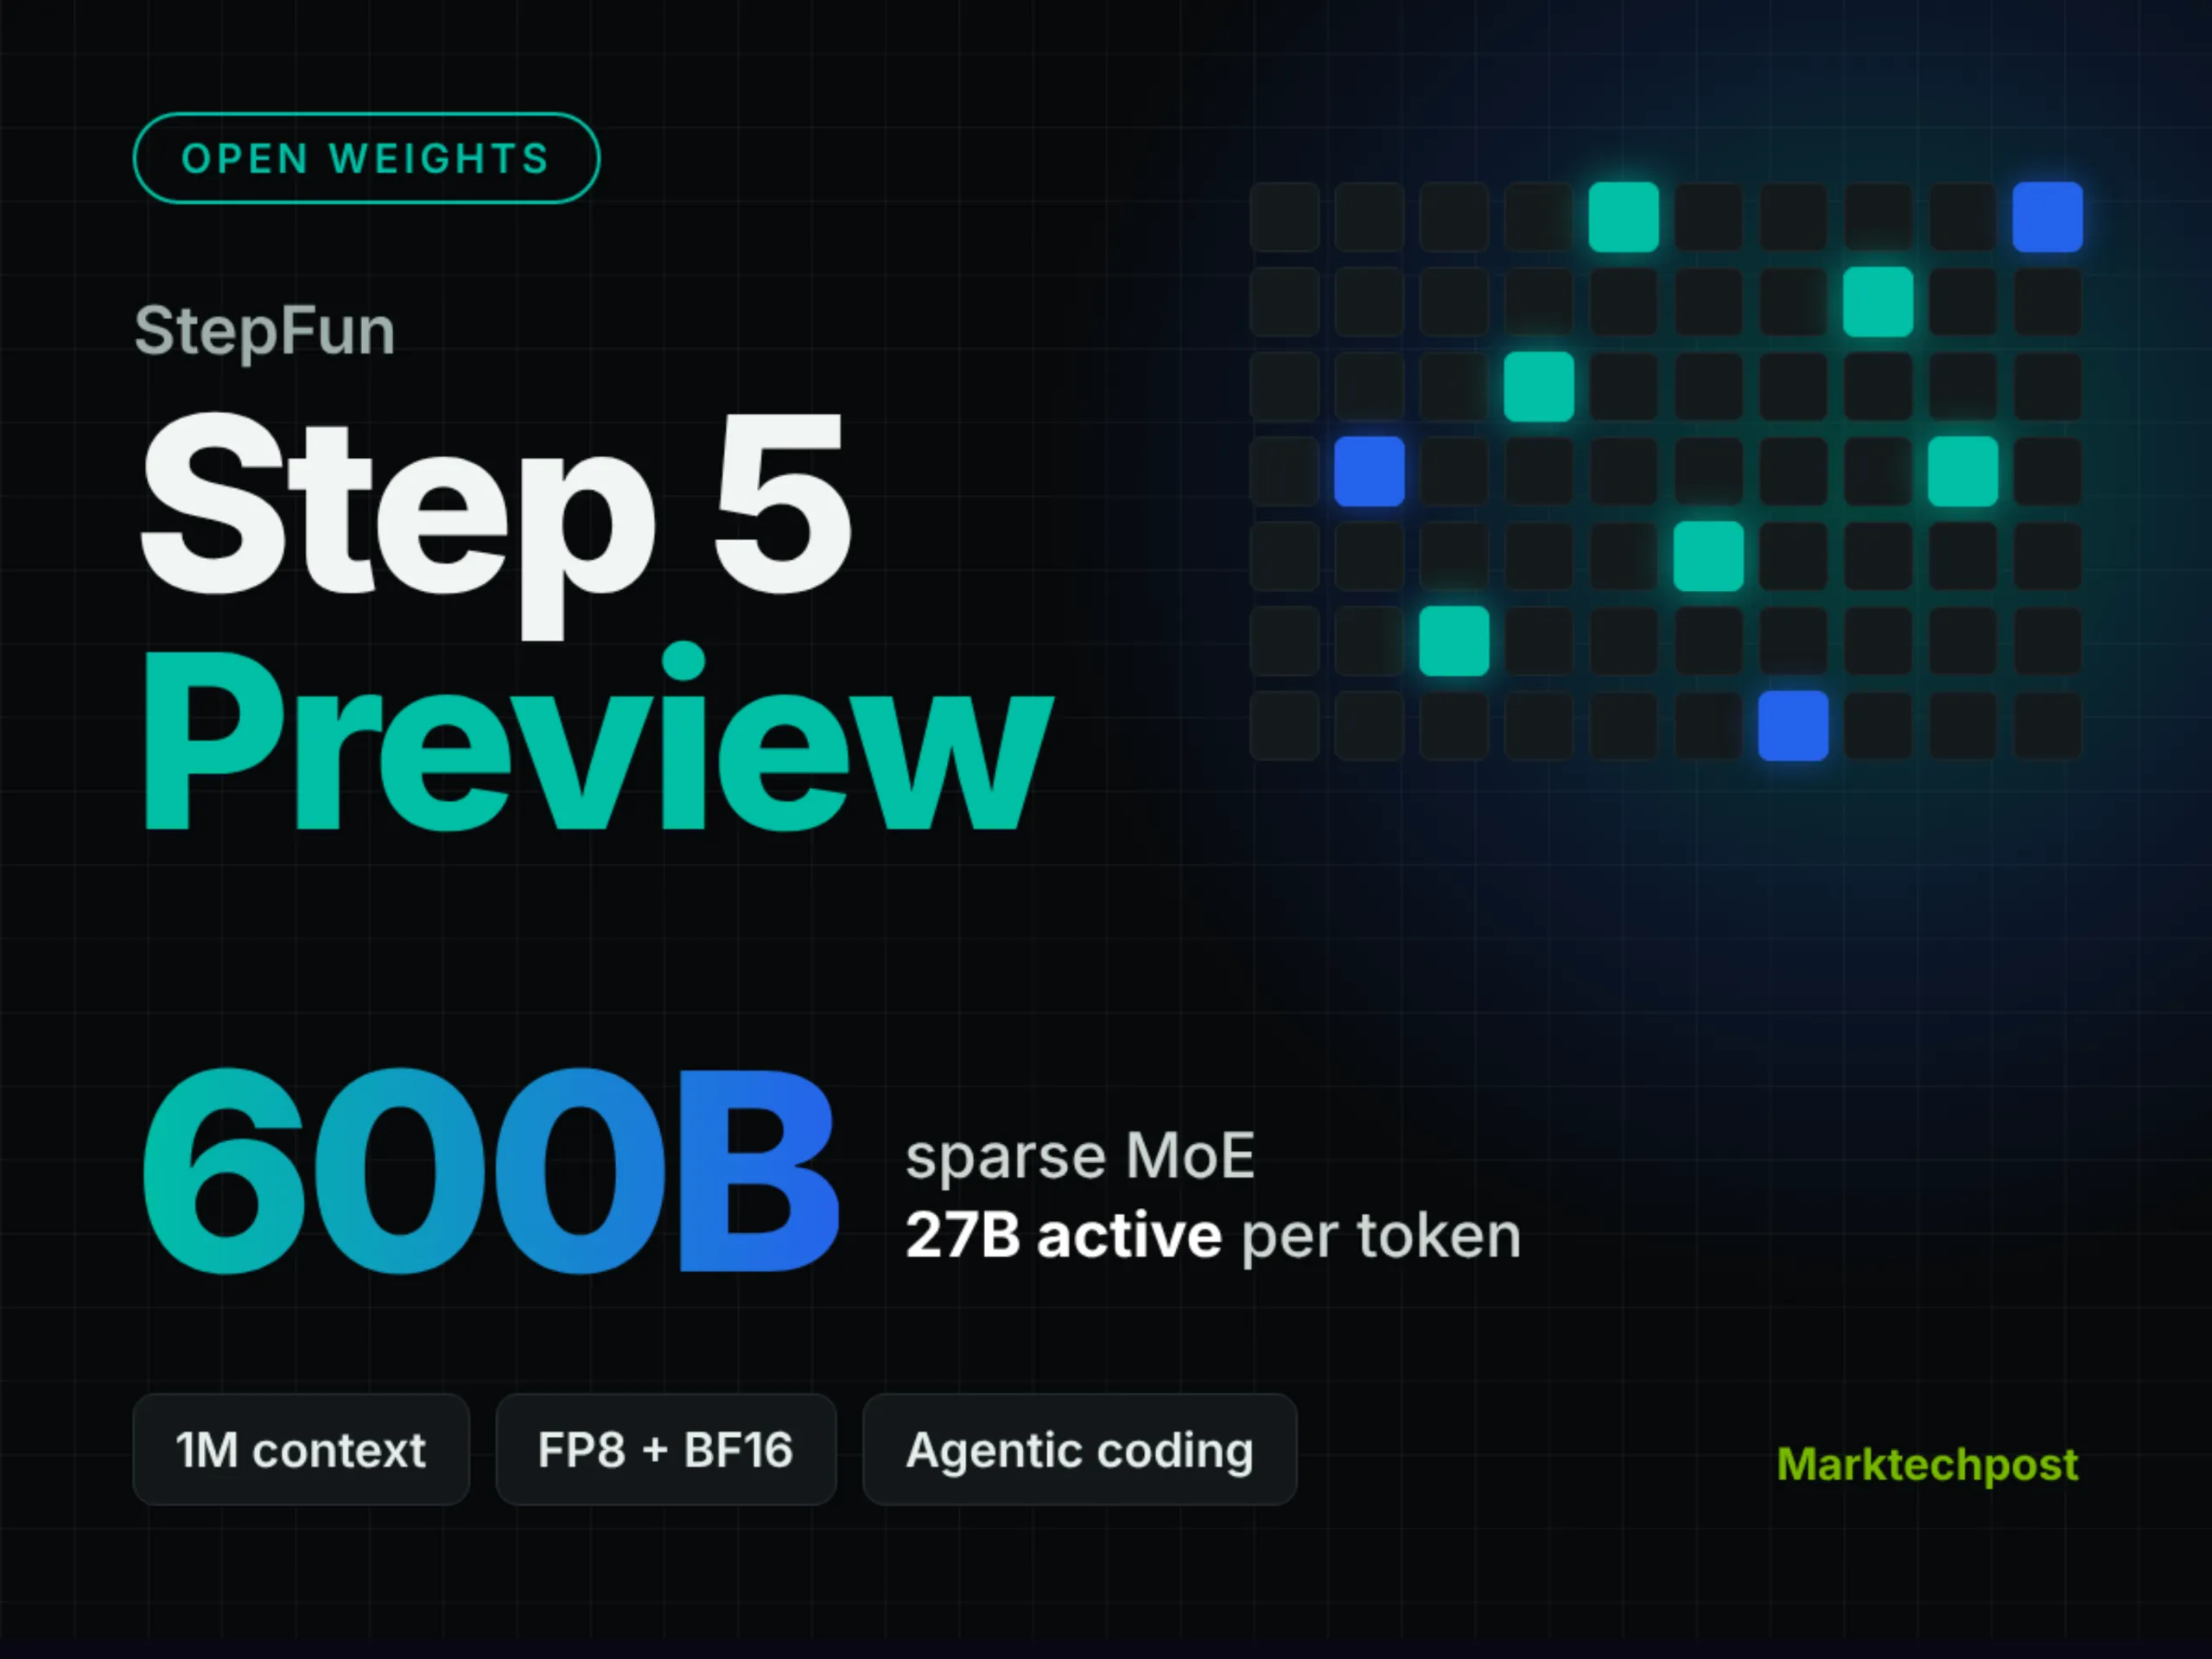
Pentru cei care nu sunt la curent cu terminologia, un model MoE (Mixture of Experts) funcționează pe un principiu elegant: deși totalitatea parametrilor este uriașă, nu toți sunt folosiți simultan. Un mecanism de rutare decide, pentru fiecare token care intră în model, care experți sunt cei mai potriviți să-l proceseze. Astfel, la fiecare pas, se activează doar o fracțiune din rețea, în cazul de față 27 de miliarde de parametri din totalul de 600.
Avantajul este dublu. Pe de o parte, modelul dispune de o capacitate de reprezentare uriașă, ceea ce îi permite să învețe nuanțe diverse ale limbajului, cunoștințe din multiple arii și stiluri variate de raționament. Pe de altă parte, costul computațional rămâne rezonabil, deoarece nu toți parametrii sunt angajați în fiecare calcul. Este ca și cum ai avea o bibliotecă imensă cu mii de specialiști, dar pentru fiecare întrebare chemi doar câțiva dintre ei.
Contextul de un milion de token-uri: o bornă importantă
Fereastra de context reprezintă cantitatea de text pe care modelul o poate "vedea" simultan atunci când generează un răspuns. Un milion de token-uri este echivalentul a aproximativ 700-800 de pagini de carte, sau un întreg cod sursă pentru proiecte software de dimensiuni medii. Această capacitate deschestri uși importante pentru aplicații practice:
Competitorii direcți, precum modelele din familia Claude sau Gemini, au introdus recent ferestre de context de ordinul milioanelor de token-uri, dar pentru ecosistemul open-source, astfel de performanțe rămân excepționale. Step 5 se poziționează astfel ca un contender serios pentru cei care doresc performanță de top fără dependența de API-uri comerciale.
Despre StepFun și strategia open-source
StepFun nu este un nou-venit în industria inteligenței artificiale. Compania a demonstrat anterior capacități impresionante cu modele de generare de imagini și video, dar intrarea în liga modelelor lingvistice de mari dimensiuni marchează o nouă etapă strategică. Decizia de a publica ponderile deschise (open weights) este una curajoasă și semnificativă.
Prin publicarea ponderilor, comunitatea de cercetători și dezvoltatori poate:
Această abordare contrastează cu strategia companiilor americane precum OpenAI sau Anthropic, care își păstrează modelele închise și le expun doar prin intermediul API-urilor plătite. Pentru utilizatorii europeni, unde reglementările precum GDPR pun presiune pe stocarea și procesarea datelor, existența unor modele performante cu ponderi deschise este o gură de oxigen.
Provocări și limitări anticipate
Desi cifrele de pe hârtie sunt spectaculoase, realitatea implementării aduce provocări semnificative. Pentru a rula un model cu 600 de miliarde de parametri în configurație completă, este nevoie de infrastructură hardware considerabilă, GPU-uri de top cu zeci sau sute de GB de VRAM fiecare, sisteme de stocare rapide și soluții de paralelizare sofisticate. Chiar și cu doar 27 de miliarde de parametri activi, inferența rămâne costisitoare.
Mai mult, fiind o versiune "Preview", performanțele anunțate trebuie tratate cu rezerve. Este posibil ca modelul să fie încă în curs de optimizare, iar anumite comportamente să fie instabile sau să necesite ajustări. Comunitatea va trebui să testeze intensiv pentru a identifica punctele forte și slăbiciunile reale.
Un alt aspect de luat în calcul este limbajul. Modelele chineze au demonstrat în repetate rânduri performanțe excelente în limba engleză, dar suportul pentru limbi mai puțin reprezentate în datele de antrenament, cum ar fi româna, poate varia. Va fi interesant de văzut cum se comportă Step 5 pe texte în limba română, în special pe sarcini care necesită înțelegerea contextului cultural local.
Implicații pentru ecosistemul AI
Lansarea Step 5 vine într-un moment de intensificare a competiției globale în domeniul inteligenței artificiale. Pe lângă jucătorii consacrați din SUA, China investește masivă în dezvoltarea de modele proprii, iar deschiderea ponderilor face parte dintr-o strategie mai amplă de câștigare a influenței tehnologice.
Pentru dezvoltatorii europeni și români, accesul la un model de asemenea dimensiuni reprezintă o oportunitate de a construi aplicații specializate fără a depinde exclusiv de furnizori străini. De la asistenți juridici la sisteme de analiză medicală, de la instrumente educaționale la platforme de creație de conținut, posibilitățile sunt vaste.
Rămâne de văzut dacă Step 5 va reuși să se impună în fața alternativelor existente, cum ar fi modelele din familia LLaMA de la Meta, Qwen de la Alibaba sau DeepSeek. Competiția este acerbă, iar inovația în domeniul AI nu dă semne de încetinire. Un lucru este cert: peisajul open-source devine din ce în ce mai bogat, iar utilizatorii sunt principalii beneficiari.
De ce este important:
Lansarea Step 5 de către StepFun marchează o etapă semnificativă în democratizarea accesului la modele lingvistice de mari dimensiuni. Cu 600 de miliarde de parametri totali, doar 27 de miliarde activi la fiecare pas și o fereastră de context de 1 milion de token-uri, acest model oferă performanțe comparabile cu cele mai bune sisteme comerciale, dar cu avantajul ponderilor deschise. Pentru companiile și cercetătorii europeni preocupați de suveranitatea datelor, existența unor alternative open-source puternice este esențială. De asemenea, competiția acerbă dintre jucătorii chinezi și americani accelerează inovația și reduce costurile pentru toți utilizatorii. Românii interesați de dezvoltarea de aplicații AI avansate au acum la dispoziție o nouă unealtă puternică, care poate fi rulată local și adaptată nevoilor specifice.