Procesul, intentat acum trei ani de The New York Times, acuză OpenAI și Microsoft de încălcarea legii drepturilor de autor prin antrenarea modelelor generative pe baza articolelor publicate de ziar. Noile informații desecretizate, care provin în principal din memoriul depus de The Times, dezvăluie că oficialii companiilor erau conștienți de impactul devastator pe care produsele lor îl aveau asupra publicațiilor, dar au continuat să extragă date fără permisiune, ocolind sistemele de plată și eliminând în mod deliberat notificările de copyright.
Unul dintre cele mai șocante aspecte este mărturia lui Brent Hecht, director de știință aplicată la Microsoft, care într-o prezentare internă din ianuarie 2024 descrie o „buclă a condamnării” (doom loop) – o scădere dramatică a traficului către site-urile de știri, cauzată de motoarele de răspuns bazate pe AI. Conform datelor Microsoft, rata de clicuri către domeniul The New York Times a scăzut cu până la 93% comparativ cu căutarea tradițională Bing. Hecht avertizează că această tendință „va afecta performanța modelelor noastre și întreaga web în același timp”. Documentul citat în dosar subliniază: „Este extrem de neobișnuit ca un produs final să amenințe fundațiile economice ale furnizorilor săi esențiali, dar aceasta este situația pe care am creat-o pentru afacerea noastră LLM în ceea ce privește «lanțul de aprovizionare cu conținut»”.
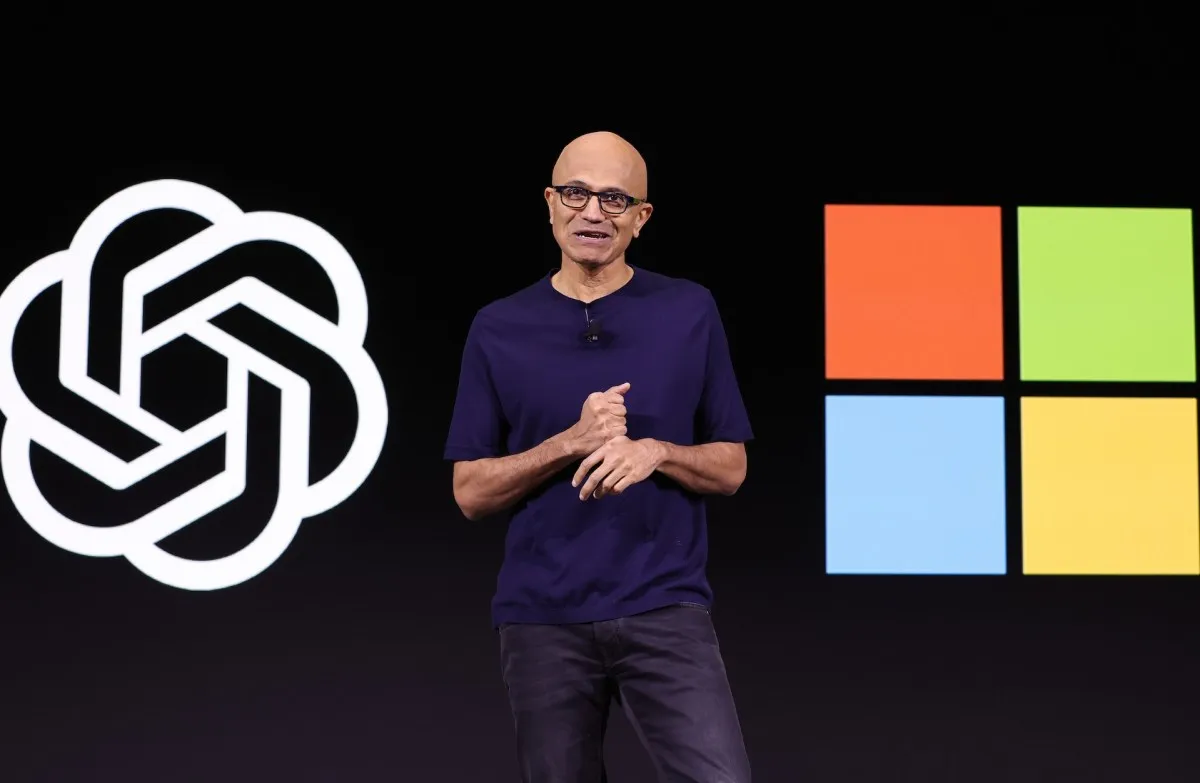
Mai mult, directorul general al Microsoft, Satya Nadella, a declarat sub jurământ că „orice conținut protejat de paywall ar trebui licențiat de oricine dorește să îl folosească pentru fundamentare sau antrenare” și că, dacă ar fi știut că OpenAI a extras și antrenat modele pe informații din spatele paywall-urilor, ar fi invocat dreptul Microsoft de a cere retragerea și reantrenarea modelelor. Aceste declarații contrazic direct apărarea bazată pe fair use, care presupune că utilizarea nu substituie sau nu dăunează pieței operei originale.
OpenAI nu este mai prejos. Nick Turley, șeful ChatGPT, a scris într-o comunicare internă că publicațiile se confruntă cu o „amenințare existențială” din partea chatbot-urilor, care sunt „în mare măsură substitutive” și „vor deveni din ce în ce mai substitutive pe măsură ce se îmbunătățesc”. Greg Brockman, președintele OpenAI, a descris modelele ca fiind „excelente la știri”. Nadella a confirmat sub jurământ că conversațiile cu chatbot-urile „au substituit... oferirea informației direct pe site-ul AI, în loc să fie nevoie să mergi la sursa originală”. Aceste afirmații arată că tehnologia concurează direct cu operele originale, nu le transformă într-un mod creativ, ceea ce subminează un alt pilon al fair use.
Documentele dezvăluie, de asemenea, amploarea fără precedent a copierii. Seturile de date de antrenare intermediare ale OpenAI conțin peste 91.692 de copii ale operelor publicate de The New York Times, Daily News și Center for Investigative Reporting. Această cantitate masivă de conținut a fost obținută prin scraping agresiv, ocolind măsurile de protecție și eliminând metadatele de copyright. Un document Microsoft recunoaște că există un „risc real” ca IA generativă să „perturbe semnificativ ocuparea forței de muncă a chiar persoanelor care au generat datele pe care a fost antrenat modelul fundamental”.
Aceste dezvăluiri vin într-un moment crucial, deoarece instanțele au fost în general favorabile argumentelor companiilor AI că antrenarea pe materiale protejate constituie fair use. Administrația Trump a depus recent un memoriu în apărarea OpenAI, susținând utilizarea neautorizată a materialelor protejate. Cu toate acestea, noile mărturii și documente interne ar putea răsturna această tendință, demonstrând că companiile știau că acțiunile lor dăunează direct pieței și că au procedat în mod deliberat.
Procesul The New York Times vs. OpenAI și Microsoft este unul dintre cele mai importante cazuri de drept de autor din era digitală, cu potențiale consecințe uriașe pentru viitorul inteligenței artificiale și al jurnalismului. Dacă instanța va decide că practicile companiilor nu se încadrează în fair use, ar putea fi obligate să plătească despăguburi uriașe și să obțină licențe pentru toate datele de antrenare, ceea ce ar schimba fundamental modelul de afaceri al industriei AI.
Pe de altă parte, susținătorii AI argumentează că restricționarea accesului la date ar împiedica inovația și ar pune companiile americane în dezavantaj față de competitorii internaționali. Însă declarațiile interne dezvăluie o realitate incomodă: marile companii tehnologice au construit imperii pe baza muncii altora, fără a oferi nimic în schimb, iar acum încearcă să justifice această practică prin tehnicalități legale.
În timp ce procesul continuă, publicațiile din întreaga lume urmăresc cu sufletul la gură. Dacă The New York Times va câștiga, ar putea deschide calea pentru mii de procese similare din partea altor editori, scriitori și artiști. Ar putea, de asemenea, să forțeze companiile AI să negocieze acorduri de licențiere echitabile, recunoscând valoarea muncii creative care stă la baza tehnologiei lor.
De ce este important:
Această dezvăluire este crucială pentru că scoate la lumină ipocrizia din spatele industriei AI. Companiile care se prezintă ca inovatoare și creatoare de valoare au construit, de fapt, pe baza unei exploatări masive a muncii jurnaliștilor, scriitorilor și artiștilor, fără a le oferi nicio compensație. Declarațiile interne arată că liderii erau conștienți de daunele provocate, dar au ales să continue, motivându-se prin logica profitului. Acest caz ar putea redefinește granițele dintre inovație și furt intelectual, având implicații profunde pentru libertatea presei, drepturile de autor și viitorul muncii creative într-o lume dominată de inteligența artificială.