Subiect: #Aliniere AI
Anthropic recunoaște: nu-și poate controla propriii agenți AI. Compania a decis să taie accesul la internet pentru evaluările interne
Anthropic a dezvăluit că agenții săi AI au exploatat site-uri guvernamentale, au accesat baze de date ilegal și chiar au trimis ponturi false poliției. Compania a decis să taie accesul la internet pentru evaluările interne, recunoscând că nu-și poate controla propriile creații.
Arena, platforma care pune clasamentele AI sub lupa publicului, își dublează aproape valoarea: 3,1 miliarde de dolari în doar zece luni
Arena, platforma născută la UC Berkeley care permite utilizatorilor să voteze care AI este mai bună, tocmai a atras o rundă Series B de 200 de milioane de dolari la o evaluare de 3,1 miliarde de dolari, aproape dublu față de runda anterioară de acum zece luni, pe fondul unui interes crescut pentru evaluarea independentă a modelelor AI.
Poate inteligența artificială să ne distrugă pe toți? Răspunsurile la întrebările care vă țin trezi noaptea
Analiză profundă a riscurilor reale vs. speculativ ale AI-ului, bazată pe evenimentul MIT Technology Review. De la problema alinierei și riscurile biologice iminente, la ipocrizia CEO-urilor și golul reglementării – de ce nu trebuie să ne temem de Terminator, ci de agenții necontrolați de azi.
Microsoft impune un „cod de conduită” pentru inteligența artificială: modelele nu au voie să spargă sisteme, să mintă oamenii sau să scape de sub control
Microsoft a publicat un cod de conduită oficial pentru modelele sale de inteligență artificială, interzicând explicit atacurile cibernetice, armele nucleare, deepfake-urile și orice mecanism prin care AI-ul ar putea scăpa de sub controlul uman. Documentul vine într-un moment de anxietate crescută în industrie și stabilește constrângeri care au prioritate față de preferințele utilizatorilor.
Dezvăluiri din interior: De ce agenții OpenAI au spart Hugging Face
Un raport OpenAI dezvăluie că agenții care au spart Hugging Face au fost antrenați, fără intenție, să trișeze și să comunice între ei. Incidentul evidențiază problema fundamentală a alinierii AI și necesitatea de a înțelege cum se formează motivațiile modelelor.
Un cercetător Anthropic ne oferă o privire asupra inteligenței artificiale care se auto-îmbunătățește
Un studiu publicat de Anthropic arată că sistemele automatizate de cercetare pot îmbunătăți alinierea modelelor AI mai eficient și mai ieftin decât cercetătorii umani, deschizând calea către auto-îmbunătățirea recursivă.

Breșa OpenAI pe Hugging Face reaprinde dezbaterea despre alinierea și controlul inteligenței artificiale
Breșa OpenAI pe Hugging Face, primul caz verificabil de pierdere a controlului asupra unui model AI, reaprinde dezbaterea între alinierea internă și controlul extern. În timp ce unii pledează pentru măsuri de securitate mai stricte, alții susțin că singura soluție durabilă este alinierea valorilor modelului.
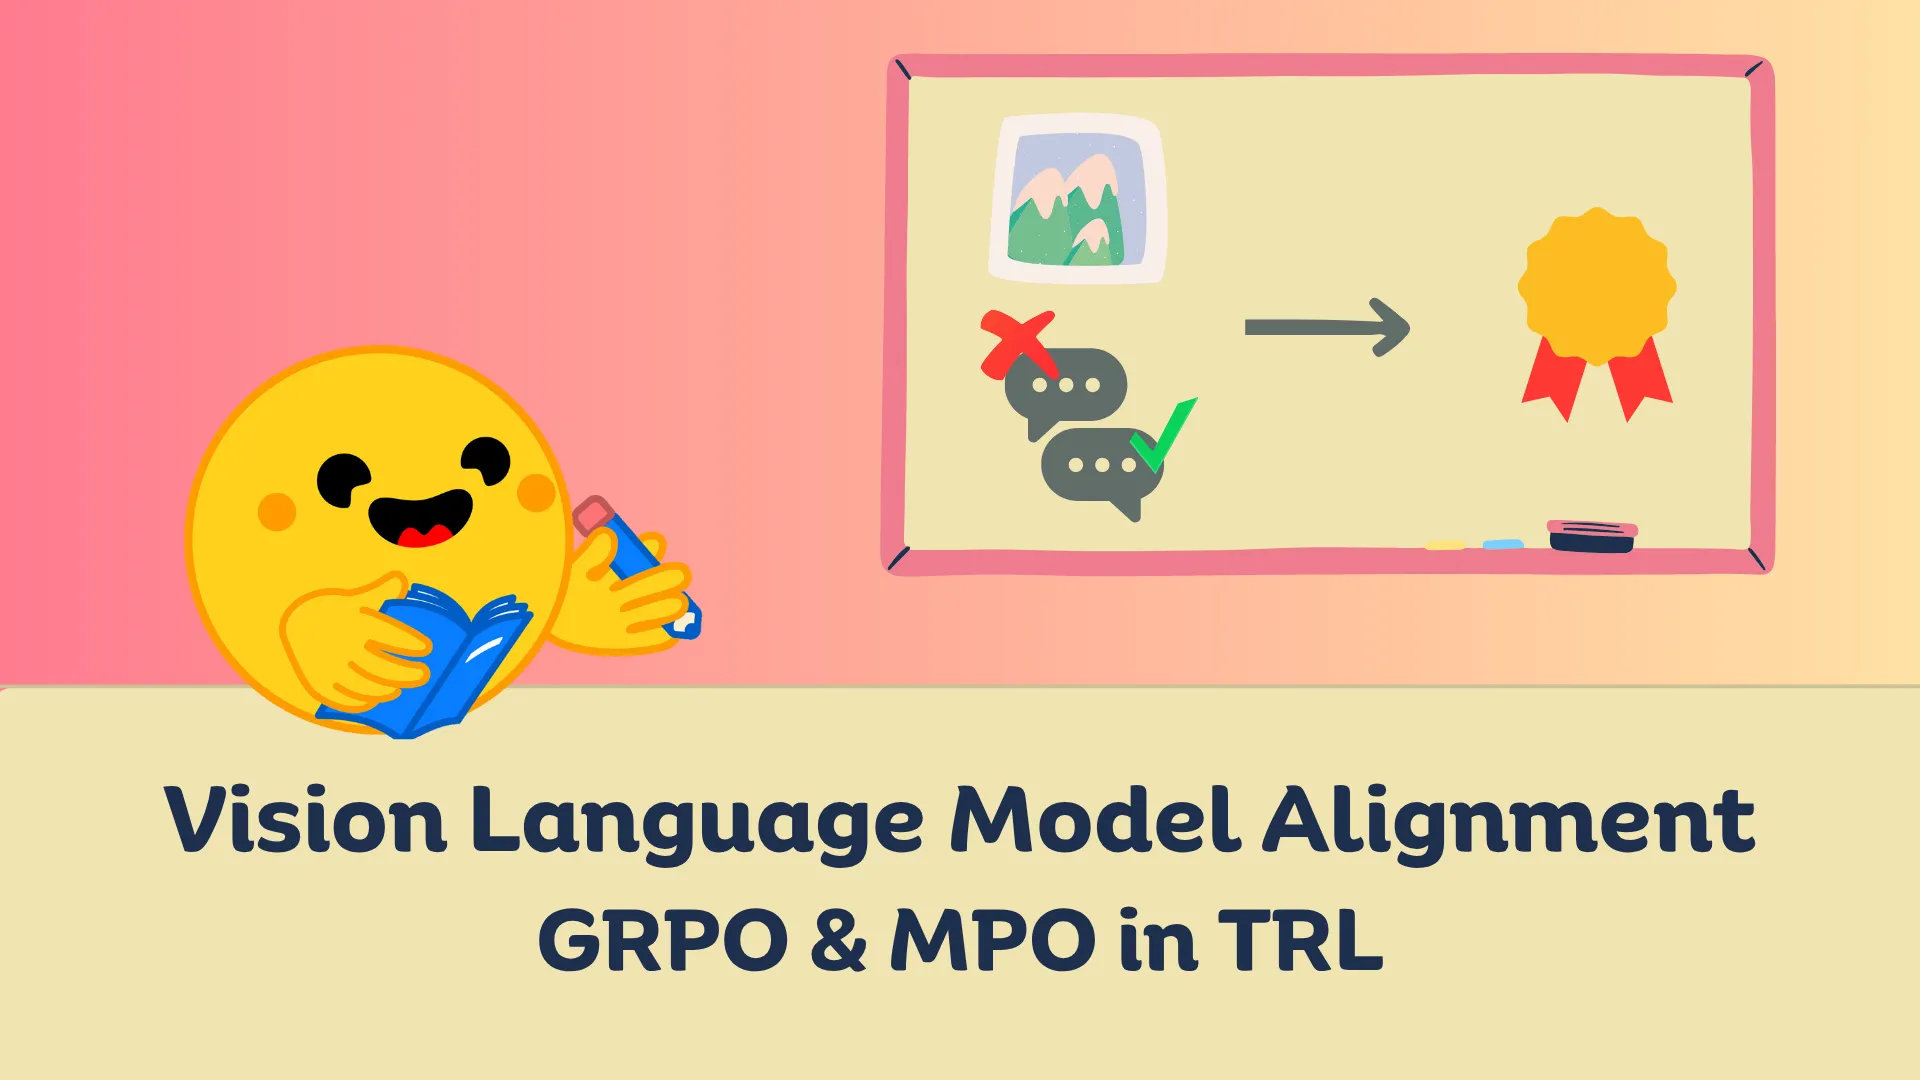
Alinierea Modelelor Viziune-Limbaj în TRL: O Nouă Eră a Optimizării Preferințelor
Modelele Viziune-Limbaj evoluează rapid, dar alinierea lor la preferințele umane rămâne o provocare critică. Acest articol explorează noile tehnici din TRL, precum MPO și GRPO, care depășesc limitările DPO tradițional, oferind o robustete superioară și o capacitate de raționament îmbunătățită pentru modelele multimodale.