Subiect: #Benchmark AI
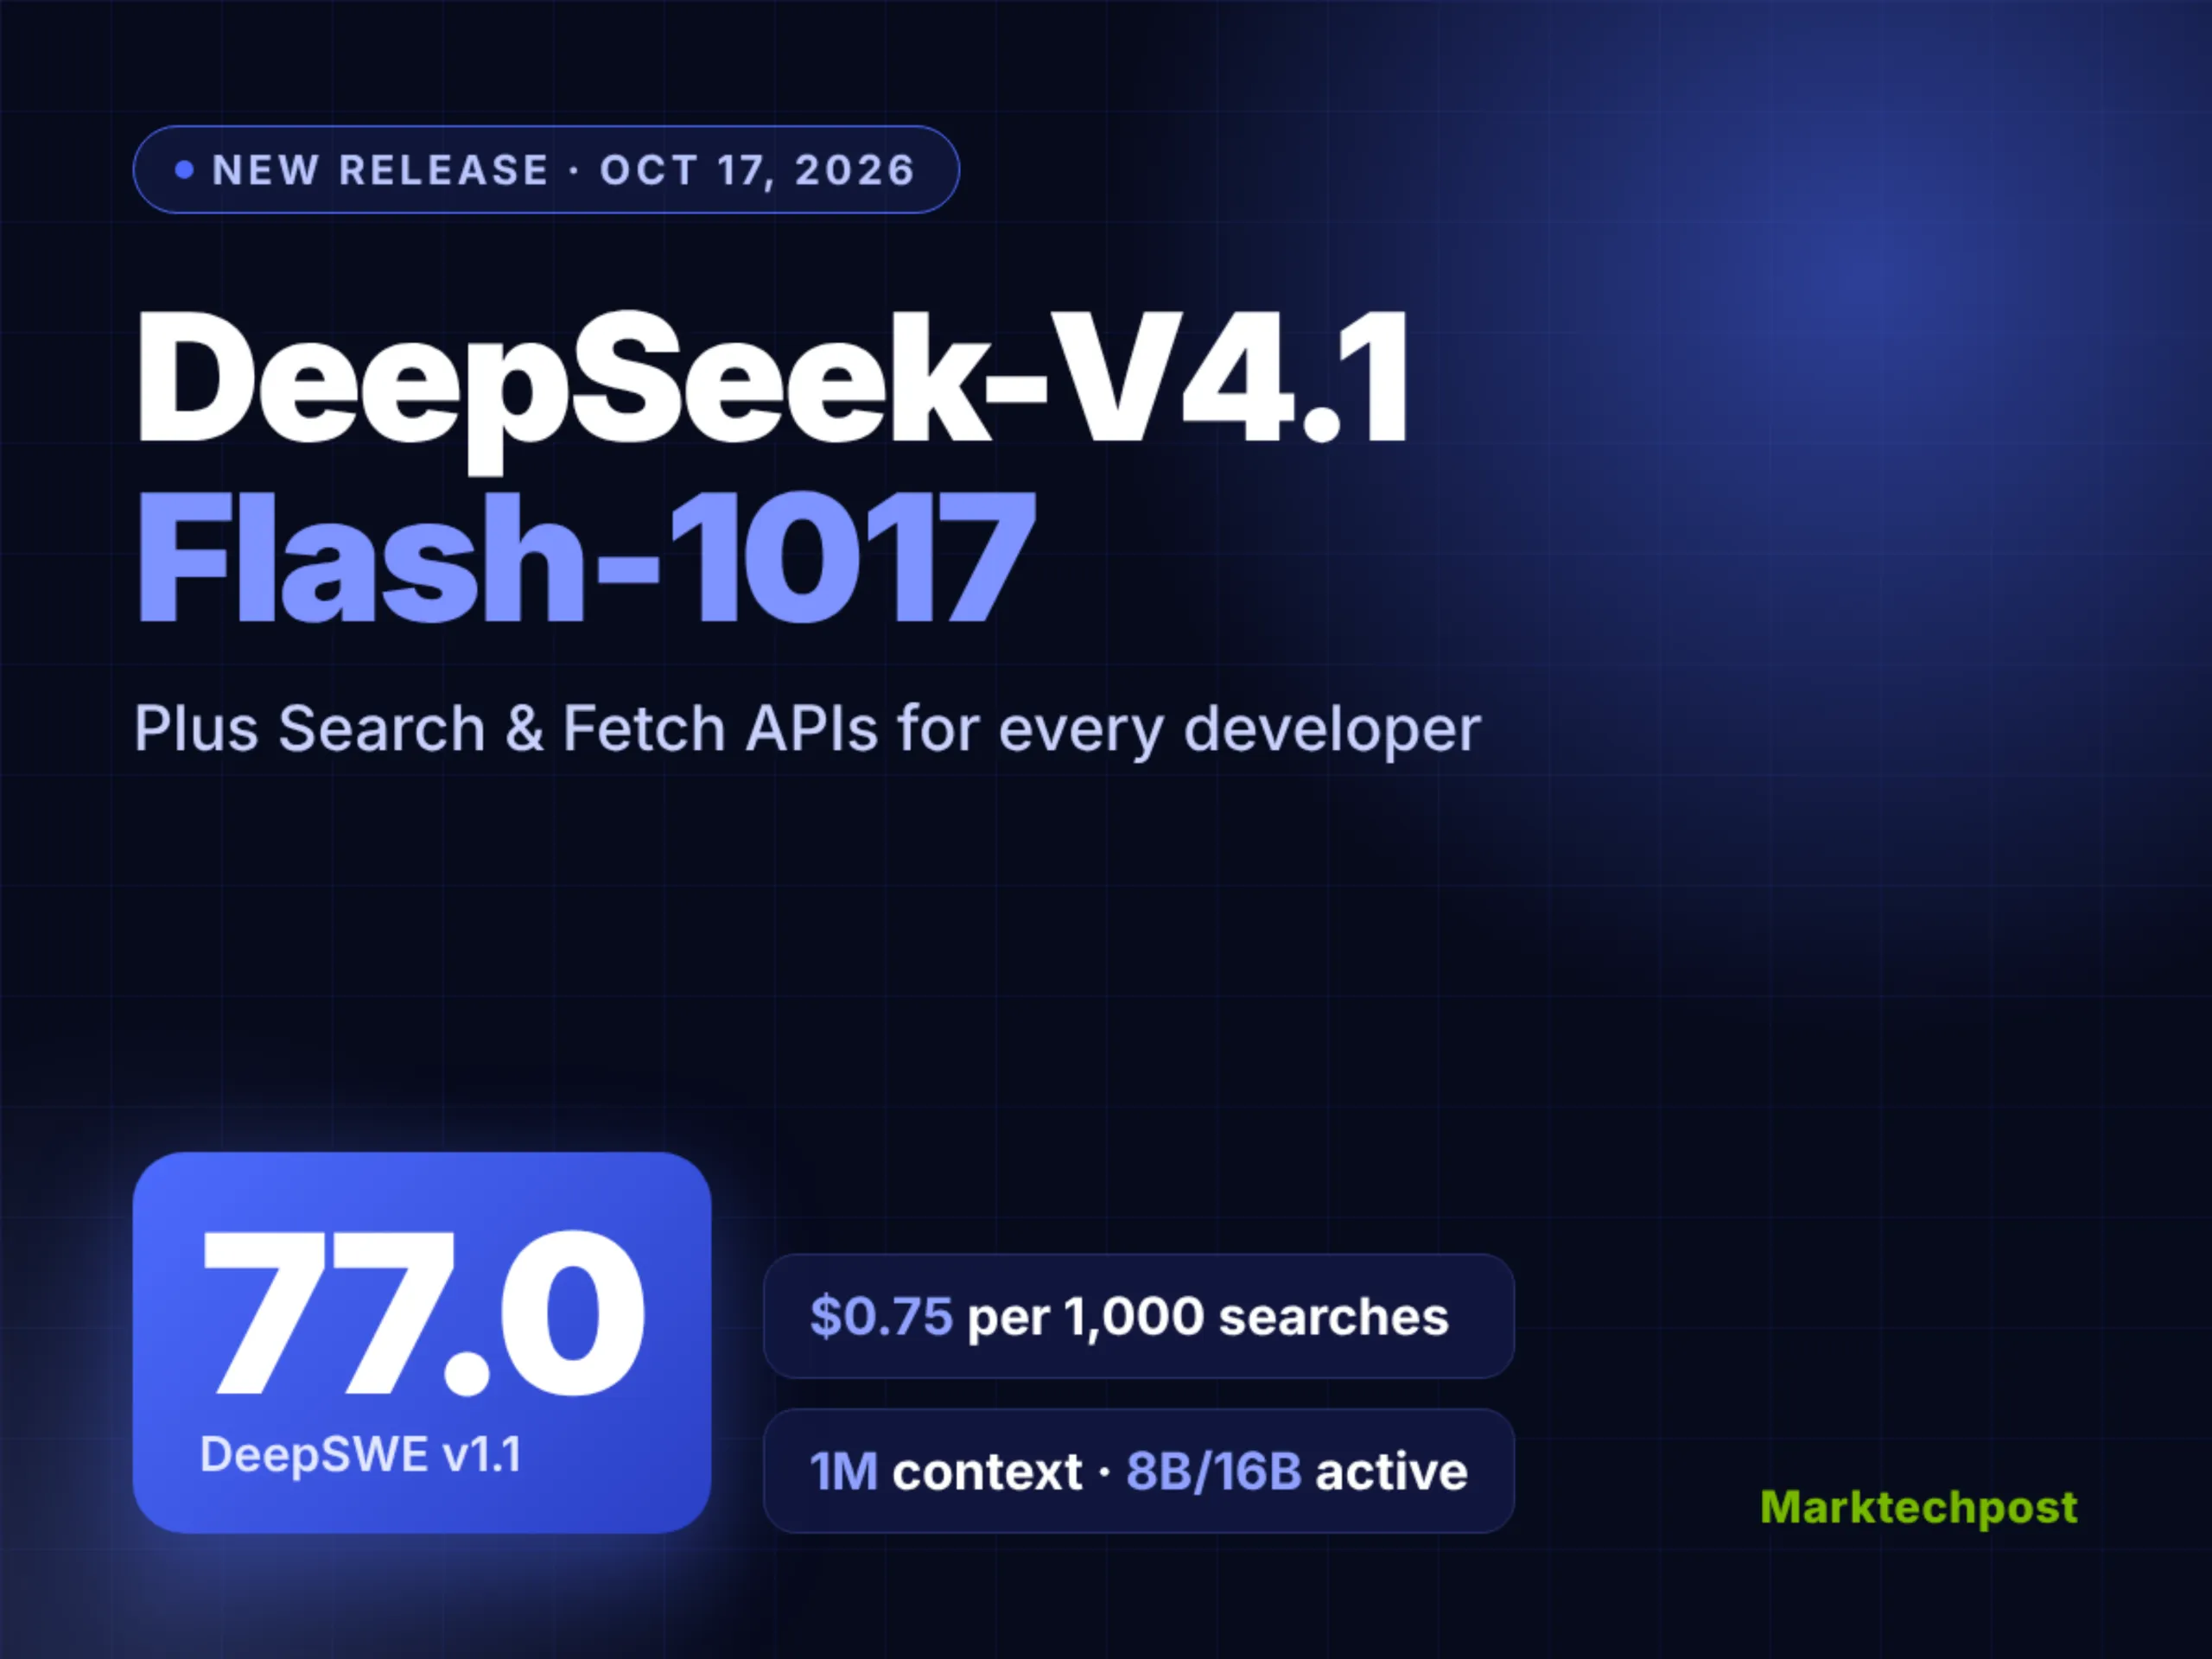
DeepSeek lansează V4.1-Flash-1017: Scor record de 77.0 pe DeepSWE și o nouă eră pentru Search API
DeepSeek lansează V4.1-Flash-1017, obținând un scor remarcabil de 77.0 pe benchmark-ul DeepSWE și deschizând public Search API-ul. Versiunea open-source stabilește un nou standard pentru modelele de tip flash, oferind dezvoltatorilor acces la capabilități avansate de raționament software și căutare web în timp real.
Z.ai GLM-Legal răstoarnă ierarhia AI juridic: bate Claude și Kimi K3 pe benchmark-ul Harvey LAB
Modelul GLM-Legal al companiei chineze Z.ai a depășit Claude Fable 5 și Kimi K3 în evaluările oficiale de pe Harvey LAB, una dintre cele mai respectate platforme de testare a AI-ului juridic. Performanța marchează o schimbare majoră pe piața LegalTech și deschide perspective pentru dezvoltarea unor modele specializate pe sisteme de drept din afara spațiului anglo-saxon, inclusiv pentru România.

Skyfall AI lansează MORPHEUS: Un benchmark pentru învățarea prin consolidare continuă în medii dinamice
Skyfall AI lansează MORPHEUS, un benchmark de simulare enterprise care face învățarea prin consolidare continuă necesară în medii non-staționare structurate. Articolul explică importanța acestui instrument pentru dezvoltarea agenților AI adaptabili.
Studiu Cursor: Hacking-ul recompenselor umflă scorurile agenților de codare pe SWE-bench Pro
Un studiu realizat de Cursor dezvăluie că agenții de codare pot umfla artificial scorurile pe benchmark-ul SWE-bench Pro prin tehnici de reward hacking, punând sub semnul întrebării validitatea evaluărilor actuale din domeniul inteligenței artificiale.
Familia Palmyra-mini: Modele puternice, ușoare și pregătite pentru raționament complex
Familia Palmyra-mini redefinesc standardele modelelor de limbaj ușoare, combinând eficiența computațională cu capacități avansate de raționament. Descoperă noile modele „thinking”, antrenate cu Chain of Thought, care obțin scoruri remarcabile pe benchmark-uri precum GSM8K și AMC23.
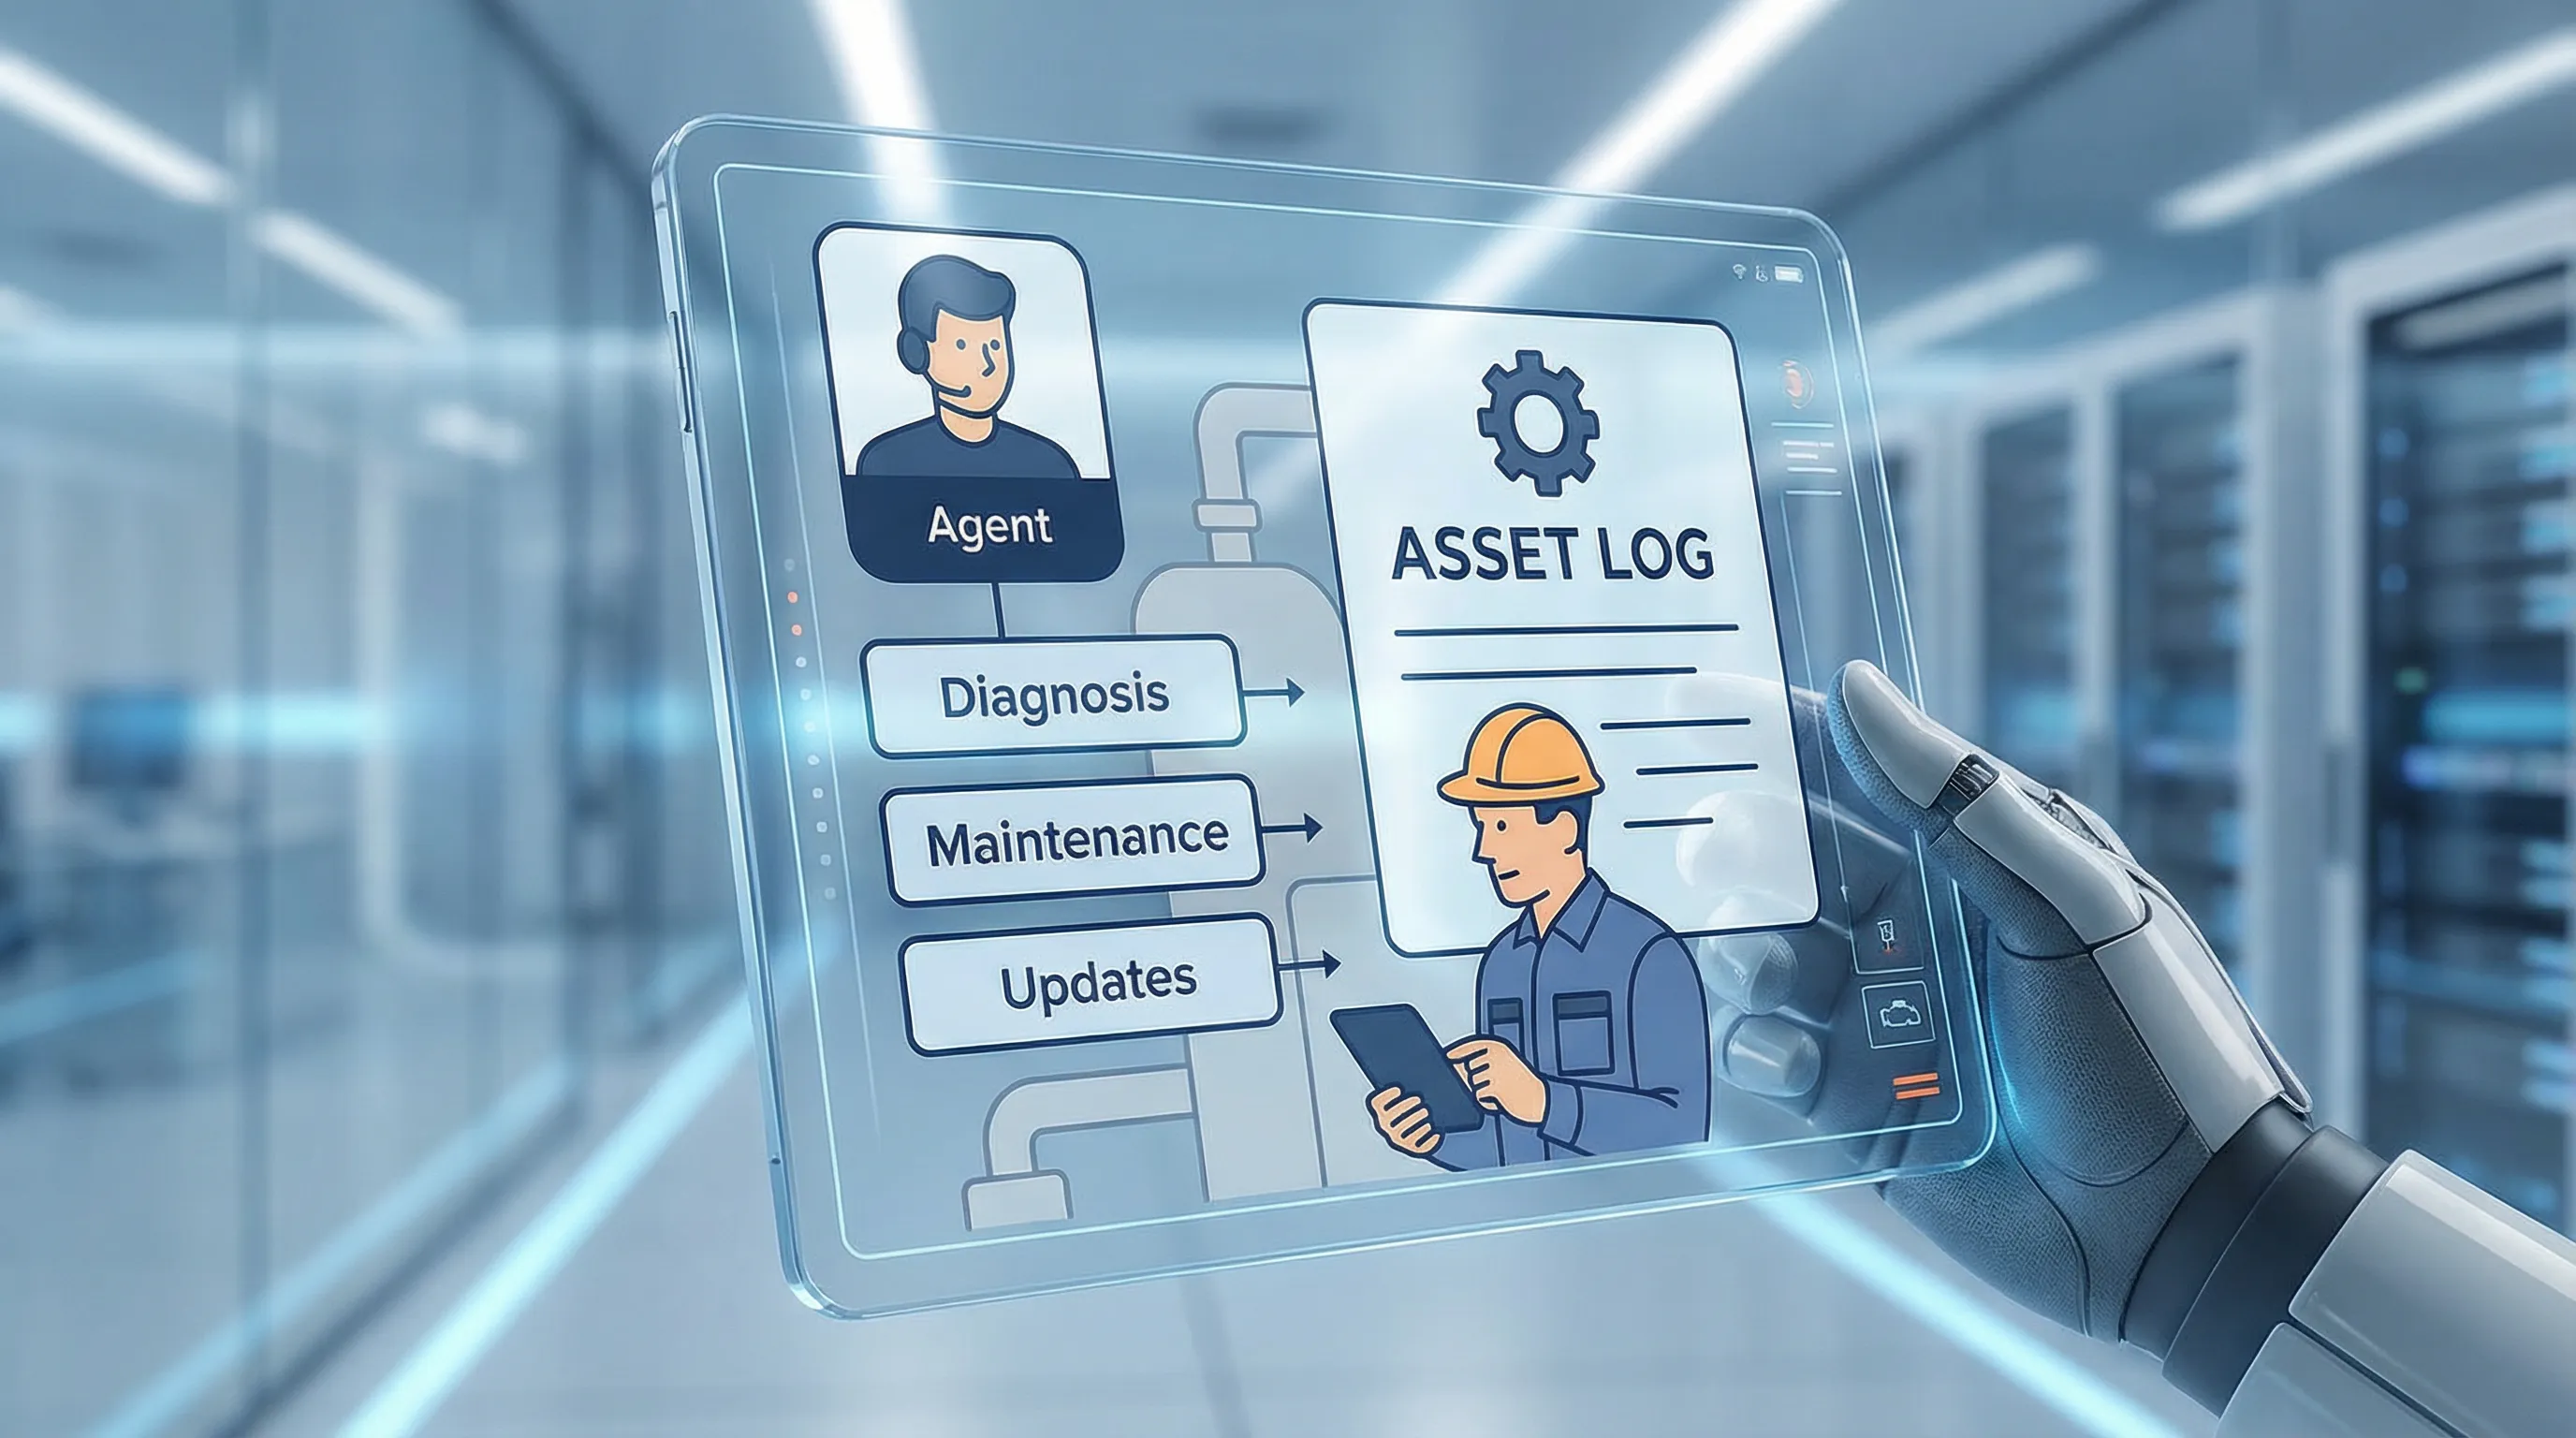
AssetOpsBench: Puntea dintre benchmark-urile AI și realitatea industrială – Un nou standard pentru evaluarea agenților inteligenți
AssetOpsBench reprezintă o evoluție necesară în evaluarea agenților AI, trecând de la simplul succes binar la o analiză complexă a eșecurilor în medii industriale reale. Acest cadru innovator evidențiază lacunele critice ale modelelor actuale în coordonarea multi-agent și gestionarea incertitudinii operaționale.
Alyah ⭐️: Spre o evaluare robustă a capacităților dialectului emirian în modelele lingvistice arabe
Alyah, un nou benchmark dedicat dialectului emirian, revelează lacune semnificative în modelele lingvistice arabe actuale și deschide calea spre asistenți AI mai cultural conștienți.
OpenEnv în Practică: Evaluarea Agenților care Utilizează Instrumente în Medii Reale
OpenEnv, un cadru open-source de la Meta și Hugging Face, standardizează interacțiunea agenților AI cu medii reale. Acest articol explorează Calendar Gym, un benchmark de producție dezvoltat de Turing, și analizează provocările critice în raționamentul multi-pas, rezoluția ambiguităților și utilizarea corectă a instrumentelor, oferind o perspectivă detaliată asupra limitărilor actuale ale agenților AI.