Subiect: #GPU
OpenAI pregătește o rundă istorică de 30 miliarde de dolari la o evaluare de 1,25 trilioane, amânând IPO-ul pentru un moment mai favorabil
OpenAI renunță la IPO-ul iminent și negociază o rundă istorică de 30 miliarde $ la 1,25 trilioane $ evaluare, condusă de Coatue și investitori din EAU. Acordul include acces la capacitate de calcul (GPU), esențială pentru antrenarea modelelor viitoare. Mișcarea ridică bara pentru rivalul Anthropic (care pregătește IPO la 1,5-2T $) și concentrează puterea AI în mâinile unor puțini actori super-puternici.
Cum să folosești Rebalancer-ul Meta: Ghid complet pentru plasarea sarcinilor și optimizare
Rebalancer, instrumentul open-source de la Meta, promite să rezolve una dintre cele mai dureroase probleme din antrenamentul distribuit: utilizarea ineficientă a resurselor GPU. Acest ghid explică ce este, cum se instalează și ce strategii de optimizare poți folosi pentru a-ți echilibra workload-ul pe clustere eterogene.
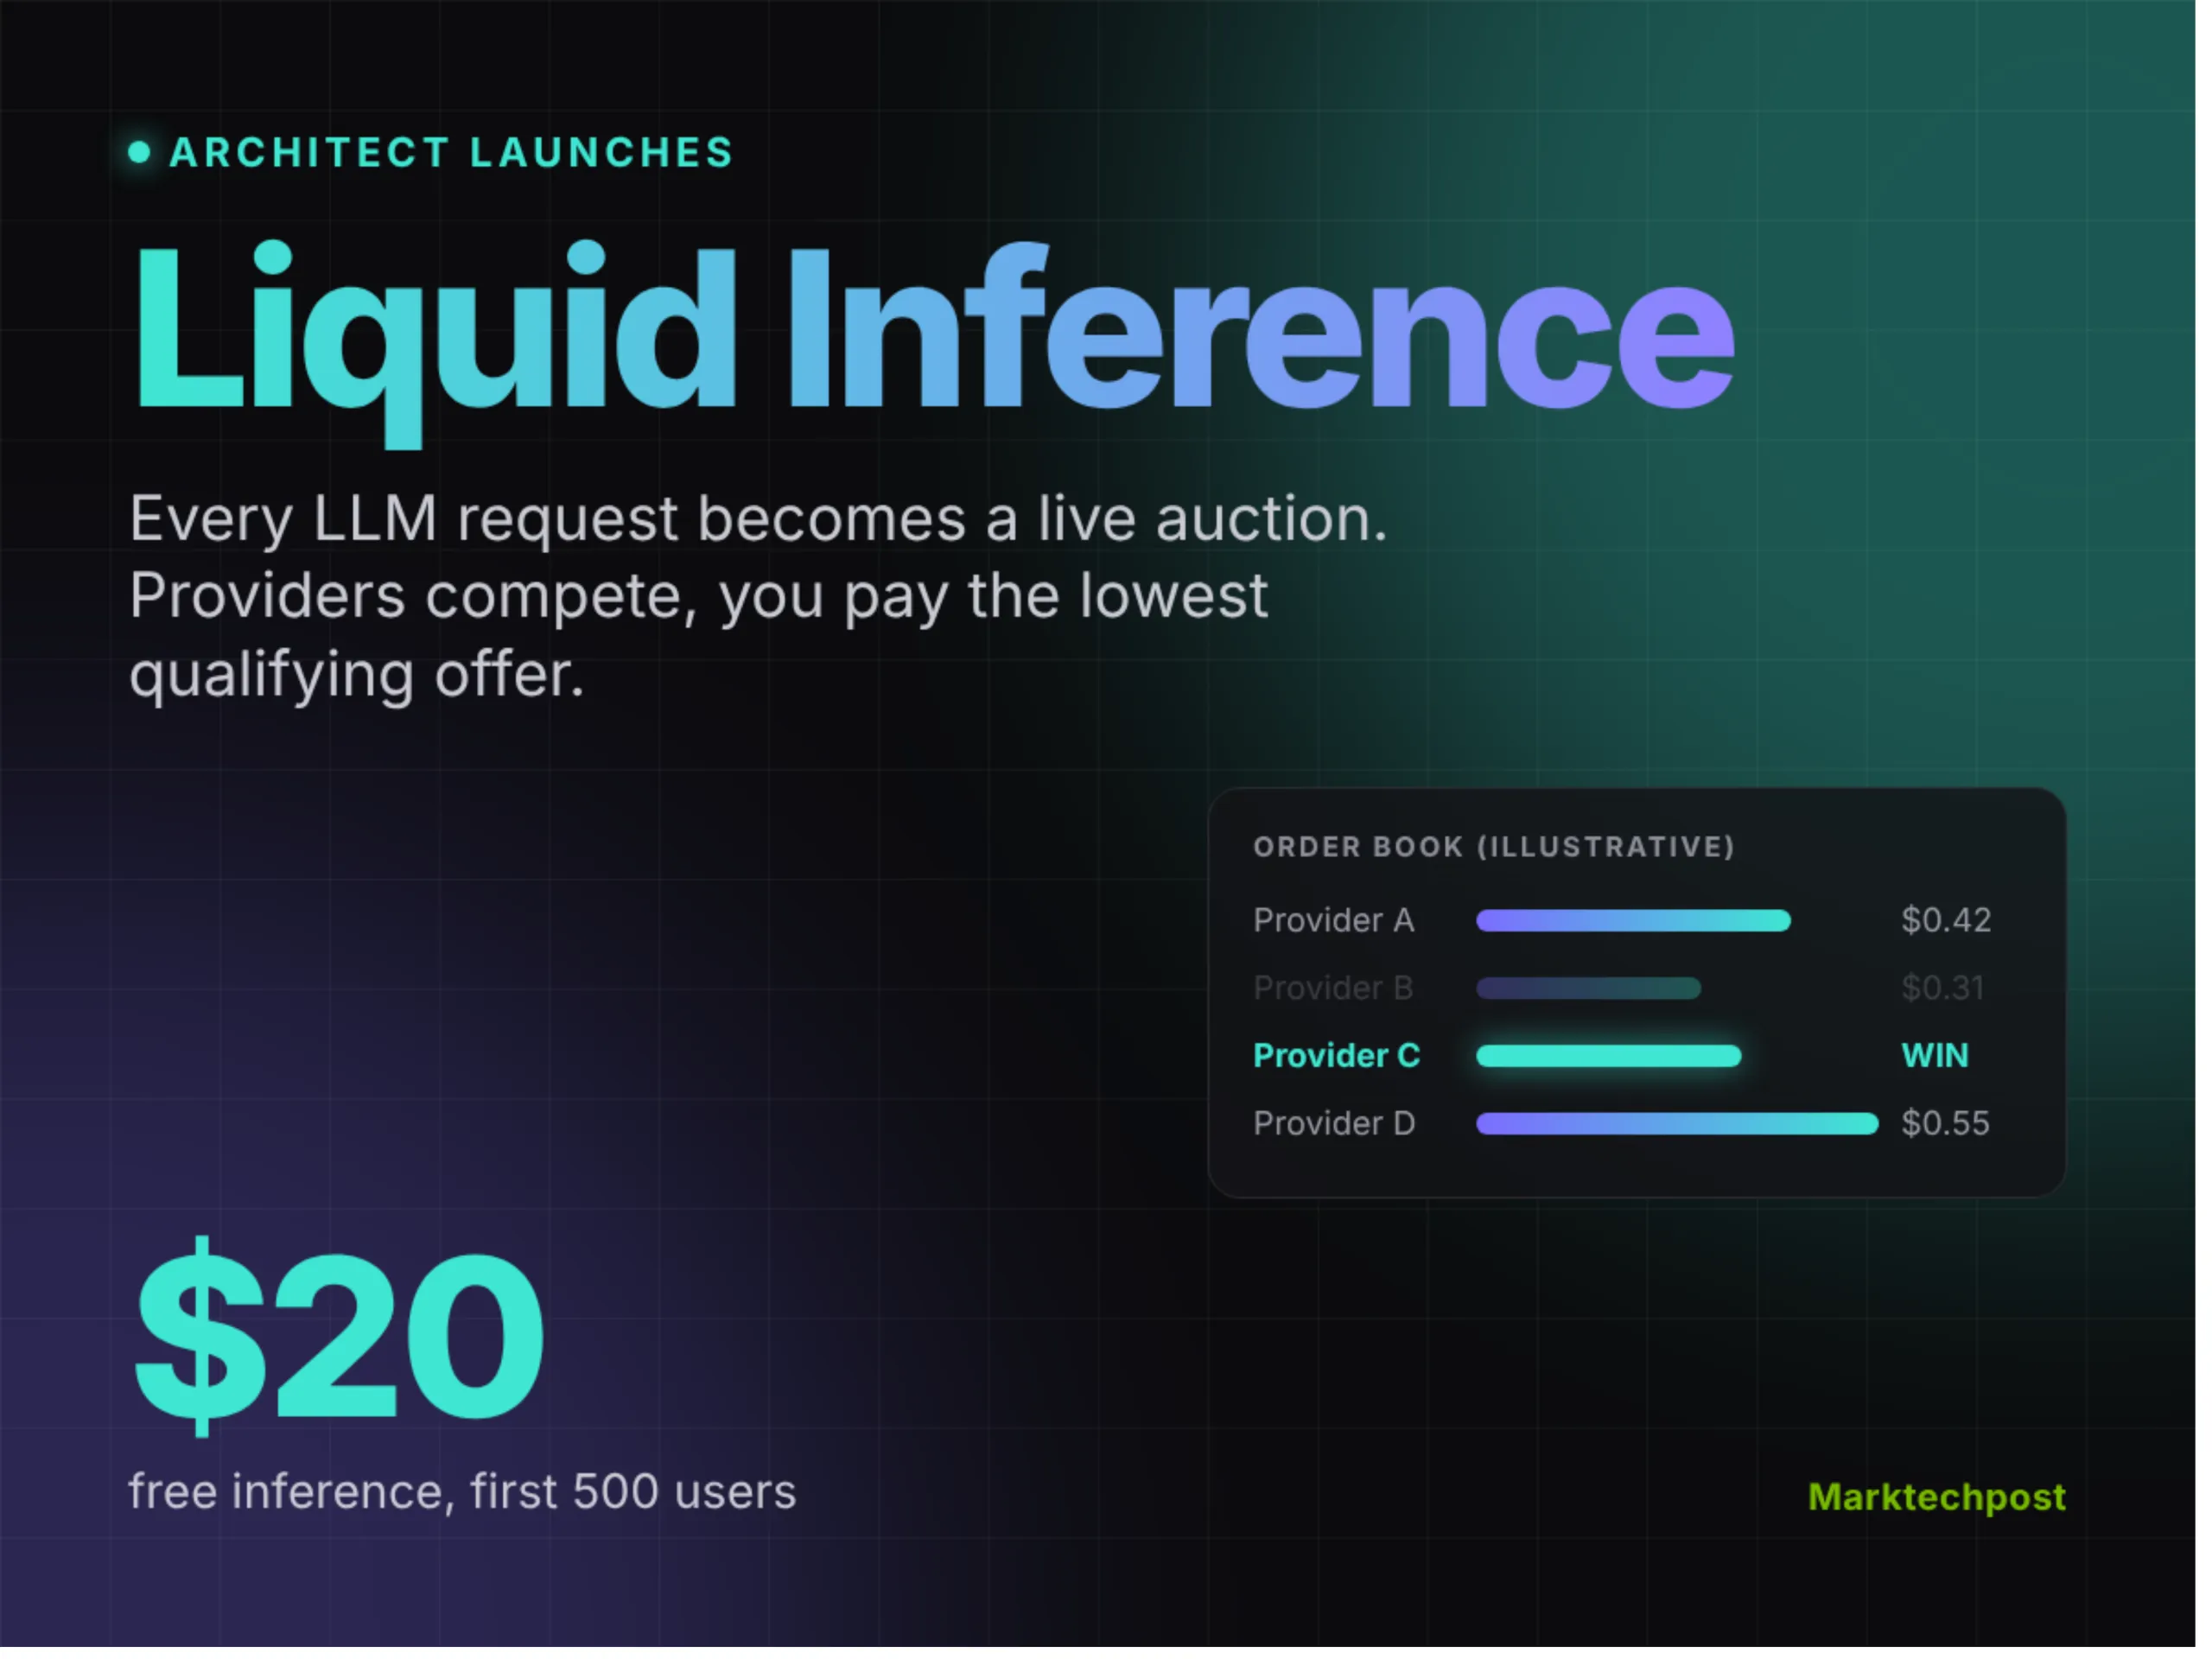
Architect lansează Liquid Inference: licitația în timp real care ar putea schimba economia inferenței pentru modelele lingvistice
Compania Architect lansează Liquid Inference, o piață în timp real unde capacitatea de calcul pentru modelele lingvistice mari este licitată la nivel de milisecundă. O idee care ar putea reduce risipa uriașă din centrele de date AI și ar putea democratiza accesul la inteligența artificială — dar care ridică și întrebări serioase despre guvernanță, securitate și echitate.
Penuria de GPU din propria infrastructură: De ce sarcinile de AI stau în coadă în timp ce capacitatea rămâne inutilizată
Articolul analizează paradoxa infrastructurii AI: GPU-urile raportează utilizare mică (5% mediu conform raportului Cast AI 2026), dar sarcinile stau în coadă. Explicăm diferența dintre alocare și utilizare, constrângerile de memorie, scheduling Kubernetes, și soluțiile de GPU sharing (MIG, MPS, vGPU).
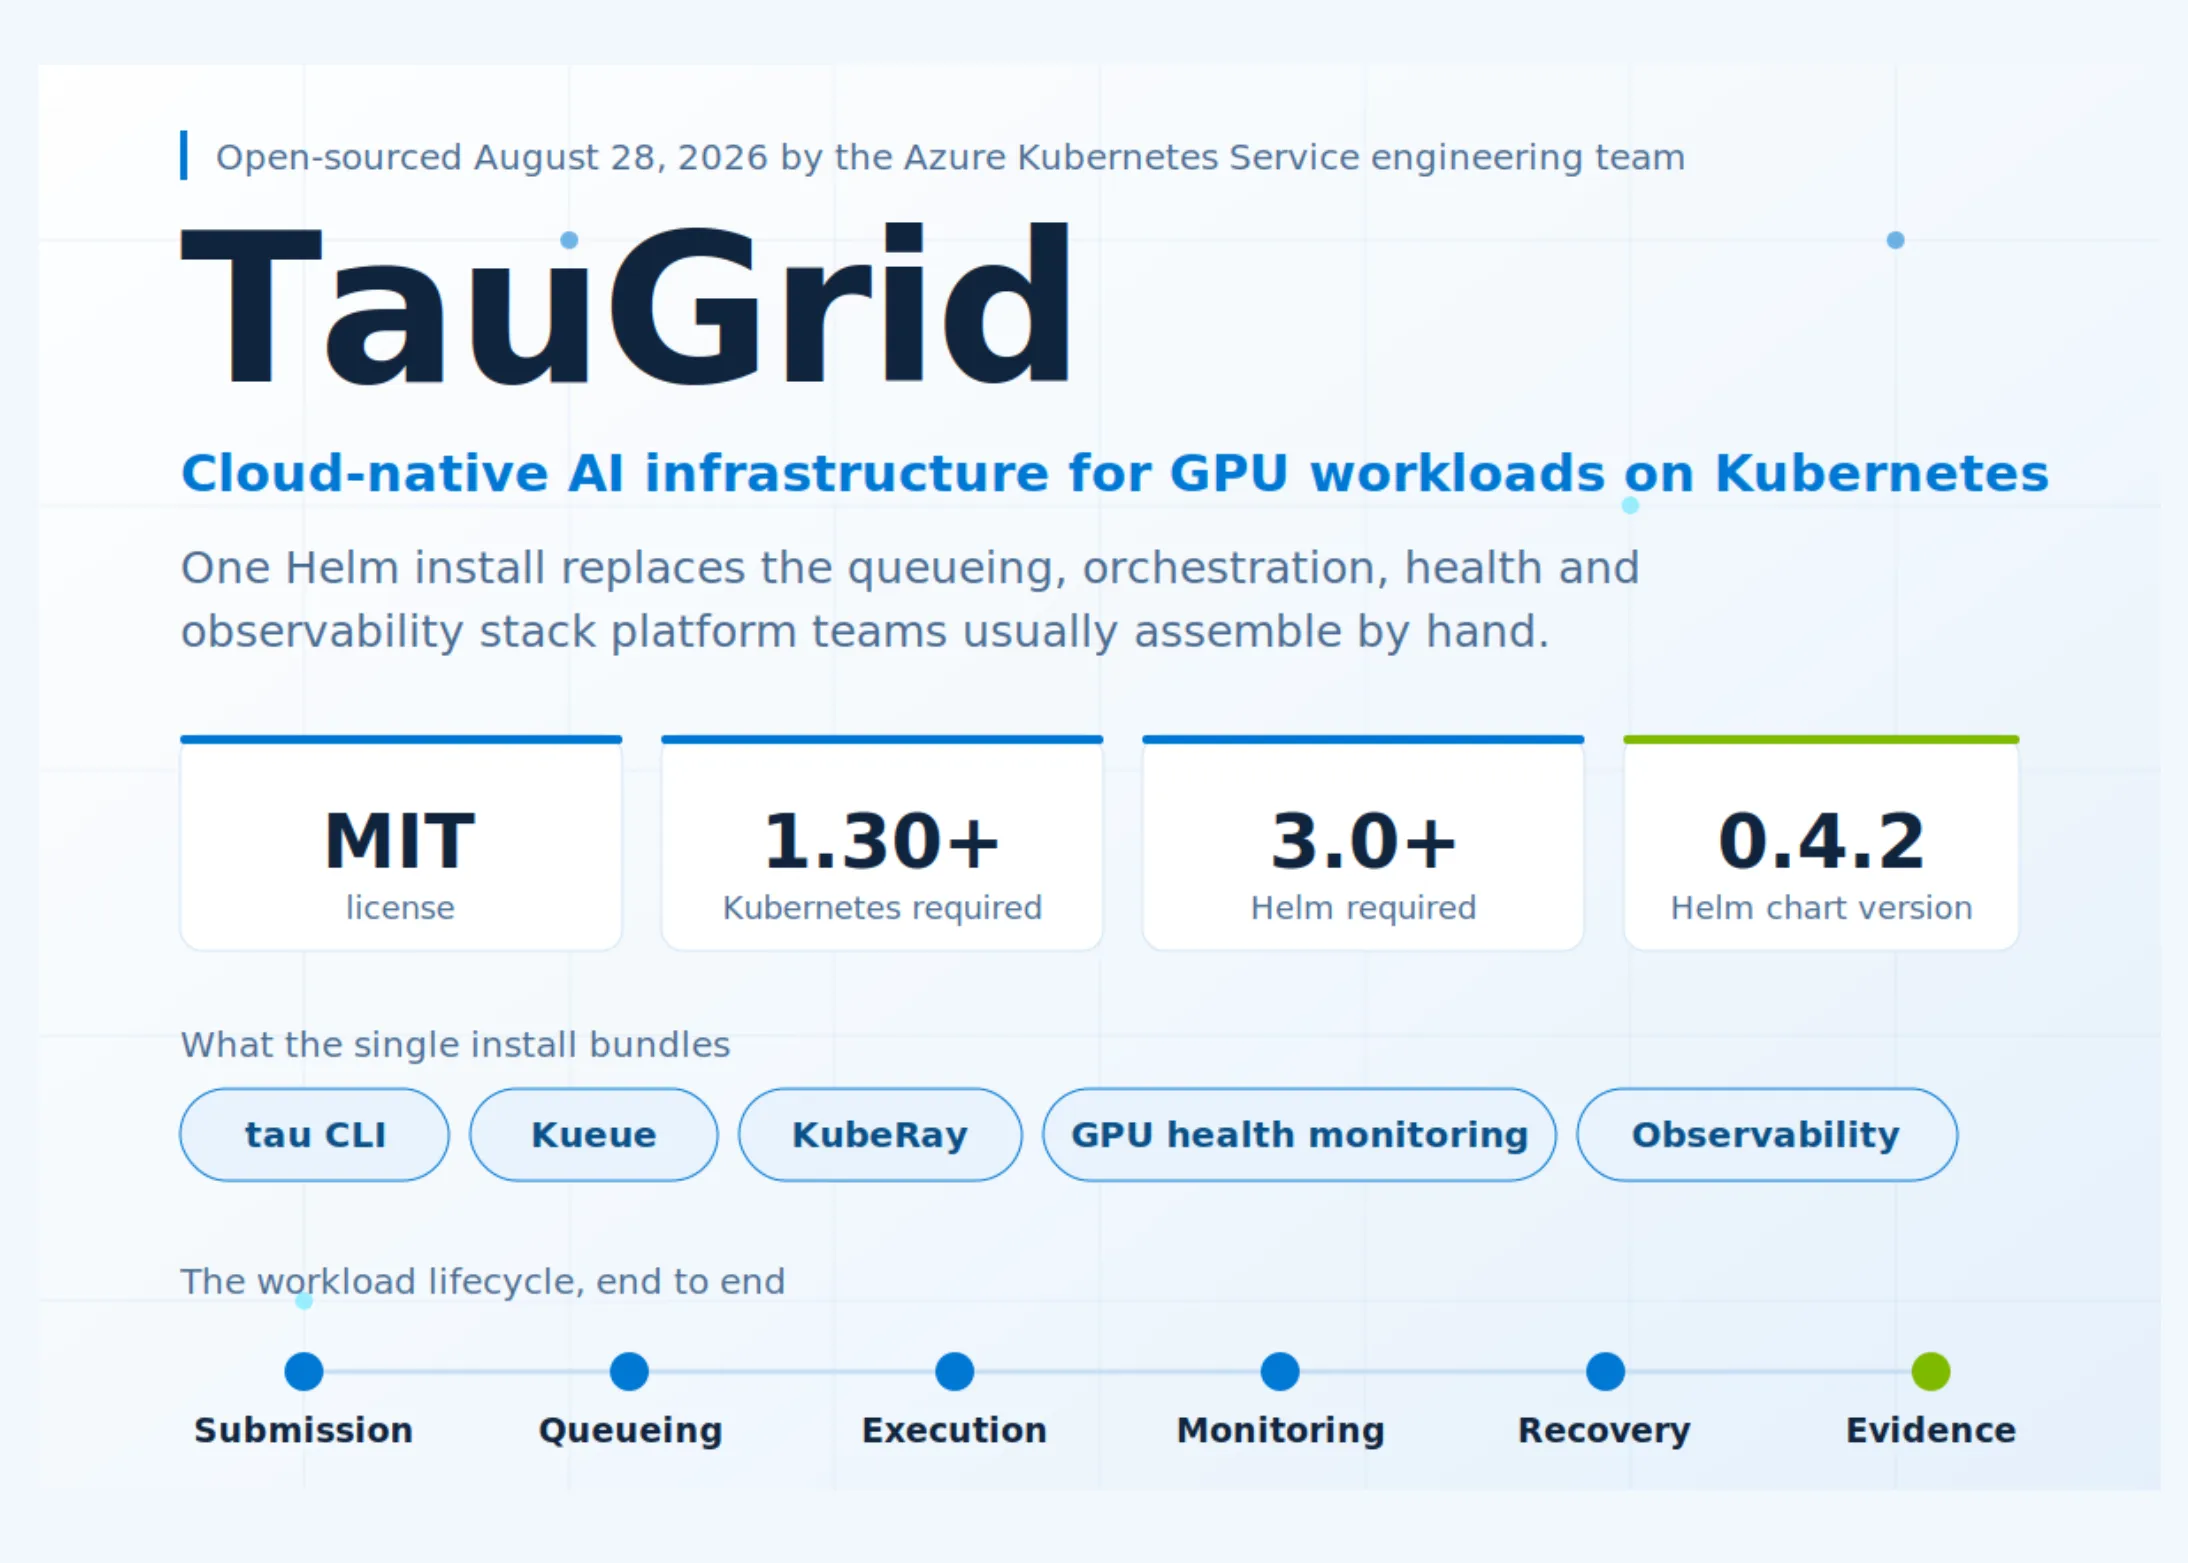
Microsoft deschide sursa TauGrid: un stack nativ Kubernetes pentru sarcini AI pe GPU
Microsoft a deschis sursa TauGrid, un stack nativ Kubernetes pentru gestionarea sarcinilor AI pe GPU. Acesta oferă programare inteligentă, scalare elastică și monitorizare avansată, democratizând accesul la infrastructură de calcul de înaltă performanță.
Cum se construiesc fluxuri de lucru de machine learning pe GPU: ghid practic cu NVIDIA cuML, RAPIDS și inferență accelerată
NVIDIA RAPIDS și cuML mută machine learning-ul clasic direct pe GPU, cu accelerări de până la 100x. De la clustering cu DBSCAN și K-Means, la benchmarking corect, explainability cu SHAP și inferență cu Forest Inference Library, iată cum arată un flux de lucru modern de data science pe plăci video.
NVIDIA dezvăluie BioNeMo Inference Runtime: cum a reușit să tripleze viteza de pliere a proteinelor pe GPU-uri H100
NVIDIA a publicat detalii despre BioNeMo Inference Runtime (BioIR), o bibliotecă Python care accelerează modelele de predicție a structurii proteinelor pe GPU-uri H100. Într-un benchmark pe 1.000 de ținte umane, versiunea Boltz-2 accelerată cu BioIR a atins 58.500 de resturi pliate per GPU-oră, de 2,90 ori mai mult decât o implementare open-source compilată cu torch. Runtime-ul optimizează la trei niveluri — kernel-uri personalizate, captură CUDA Graph și replicare distribuită prin Ray — și a alimentat deja extinderea bazei de date AlphaFold, cu aproximativ 31 de milioane de complexe proteice candidate.
Jensen Huang explică de ce Nvidia va crește spectaculos cu 70% anul viitor
Jensen Huang, CEO-ul Nvidia, a explicat la conferința Goldman Sachs de ce compania sa va crește cu 70% anul viitor, subliniind dominația sa în ecosistemul AI, produsele sale de înaltă performanță și strategia sa de a urmări fiecare gigawatt de infrastructură globală.
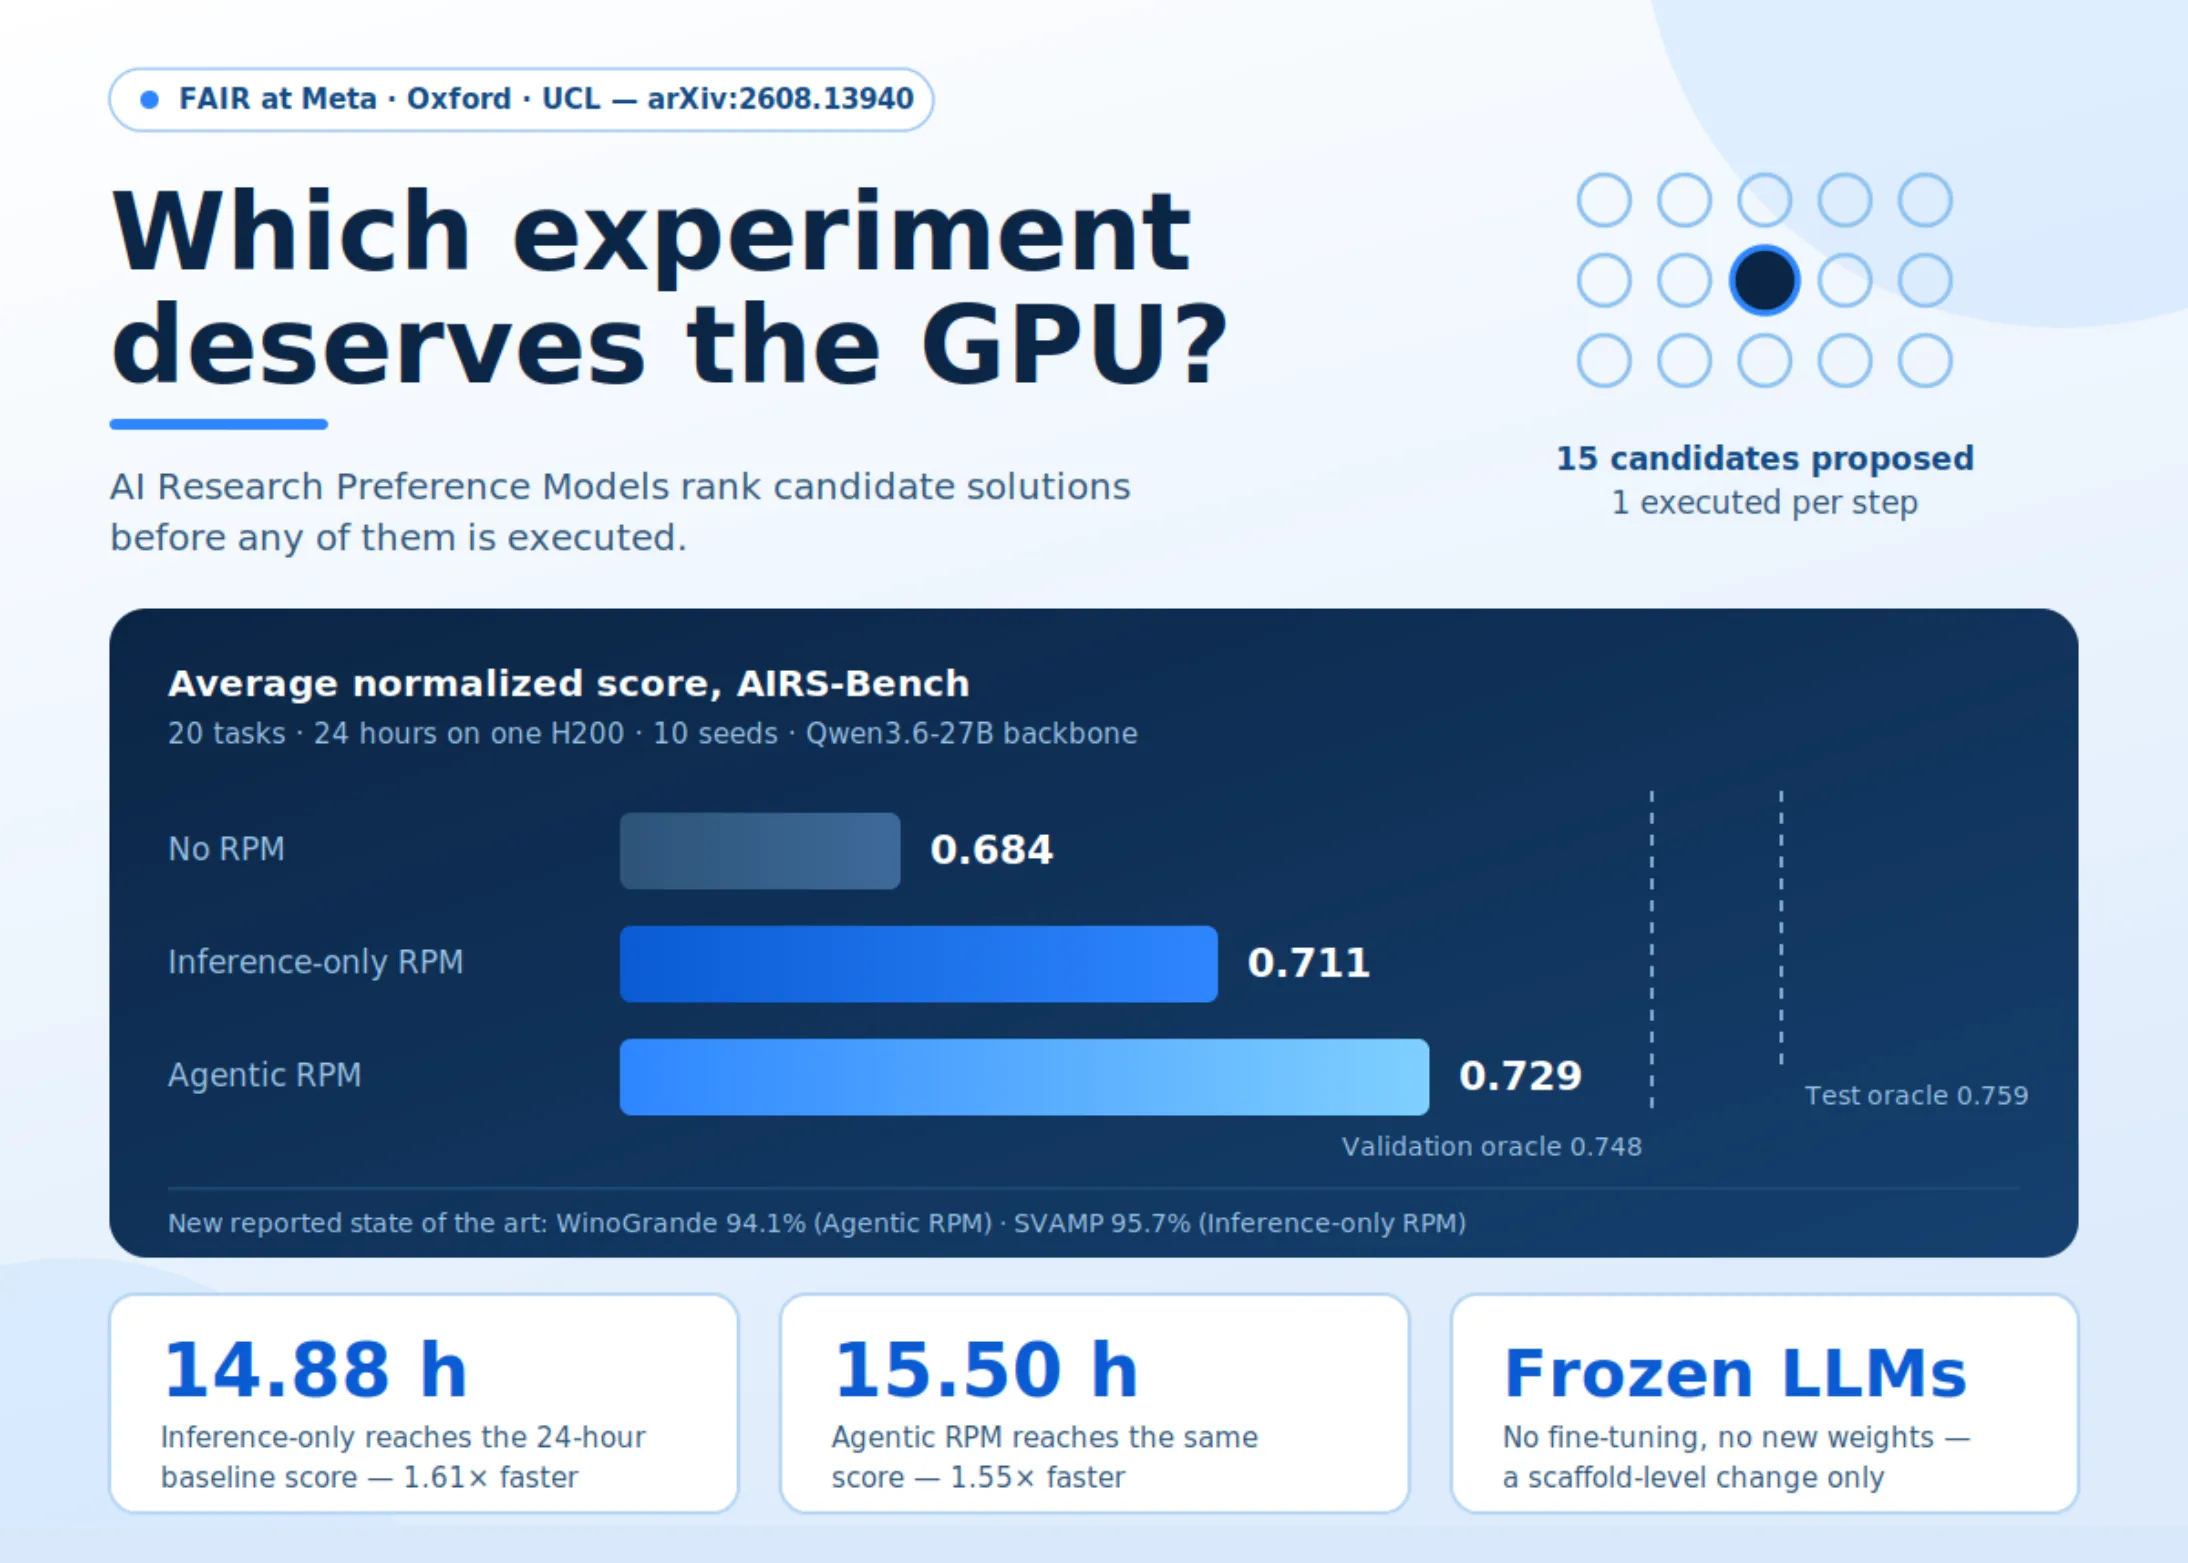
Meta FAIR introduce Modele de Preferință pentru Cercetare AI: Clasificarea Experimentelor de Învățare Automată înainte de a Cheltui Ore GPU
Meta FAIR introduce Modele de Preferință pentru Cercetare (RPM), o metodă inovatoare care clasifică experimentele de machine learning înainte de a aloca resurse GPU, reducând costurile și accelerând inovația în AI.
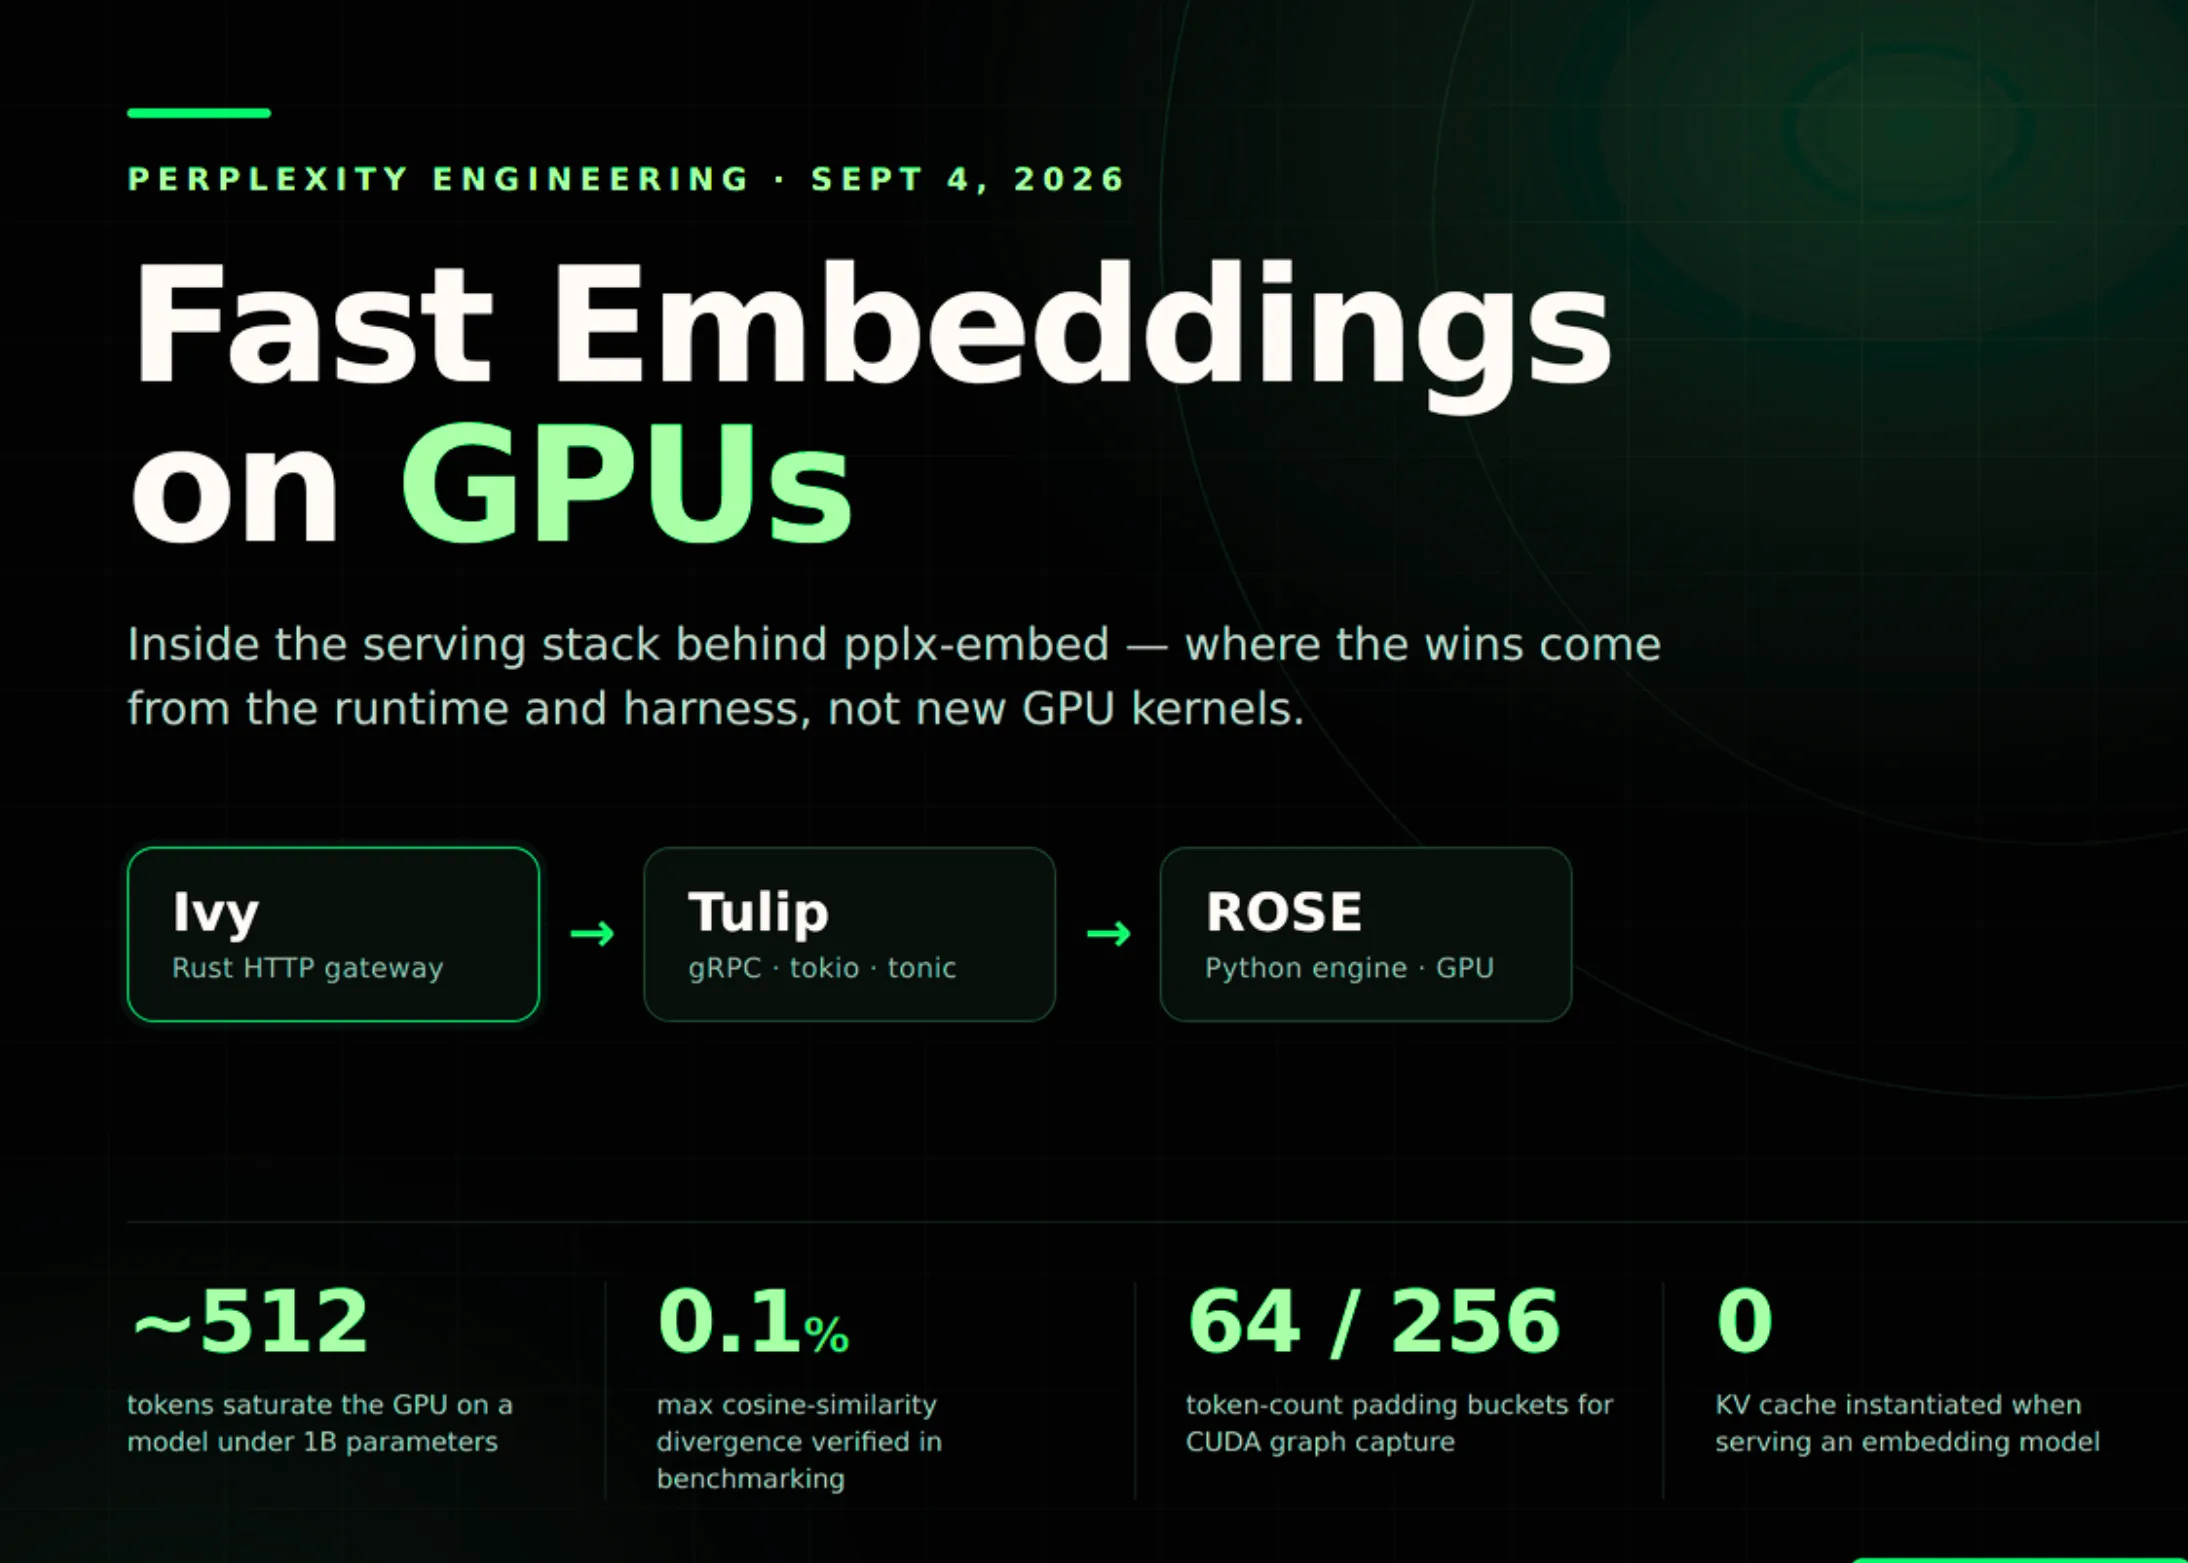
Perplexity dezvăluie arhitectura GPU a stivei de embedding: Cum Ivy, Tulip și ROSE alimentază pplx-embed
Perplexity AI dezvăluie pentru prima dată arhitectura completă a stivei sale de embedding GPU: Ivy (kerneli CUDA optimizați), Tulip (scheduler distribuit cu elastic batching) și ROSE (compresie vectorială ierarhică). Analizăm cum aceste trei componente reduc latenta, costurile și complexitatea la scară, și de ce această abordare "full-stack" devine noul standard pentru sistemele RAG de producție.
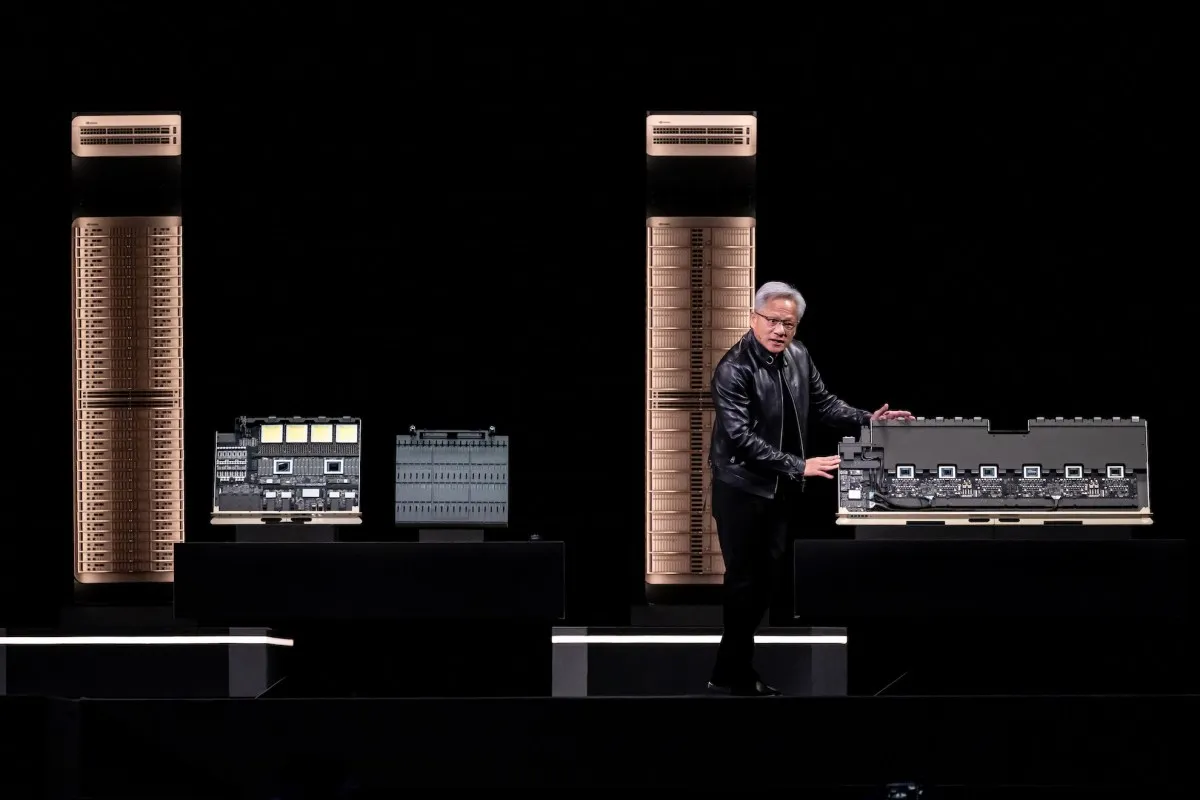
Avantajul Nvidia în AI nu se mai rezumă doar la GPU-uri
Nvidia își extinde avantajul în AI dincolo de GPU-uri, concentrându-se pe orchestrarea datelor și eficiența sistemelor. Arhitectura Vera Rubin și CPU-ul Vera devin la fel de importante ca și GPU-urile, iar competiția se mută la un nou nivel.
Amazon își triplează comanda de cipuri Nvidia: o alianță strategică de zeci de miliarde de dolari
Amazon își triplează comanda de cipuri Nvidia, adăugând 2 milioane de GPU-uri în centrele de date AWS, într-un parteneriat extins care include și integrarea tehnologiei Nvidia în robotica Amazon. Acordul, în valoare de zeci de miliarde de dolari, subliniază cererea explodată pentru AI și competiția dintre giganții tehnologici.