Subiect: #KV Cache
AI
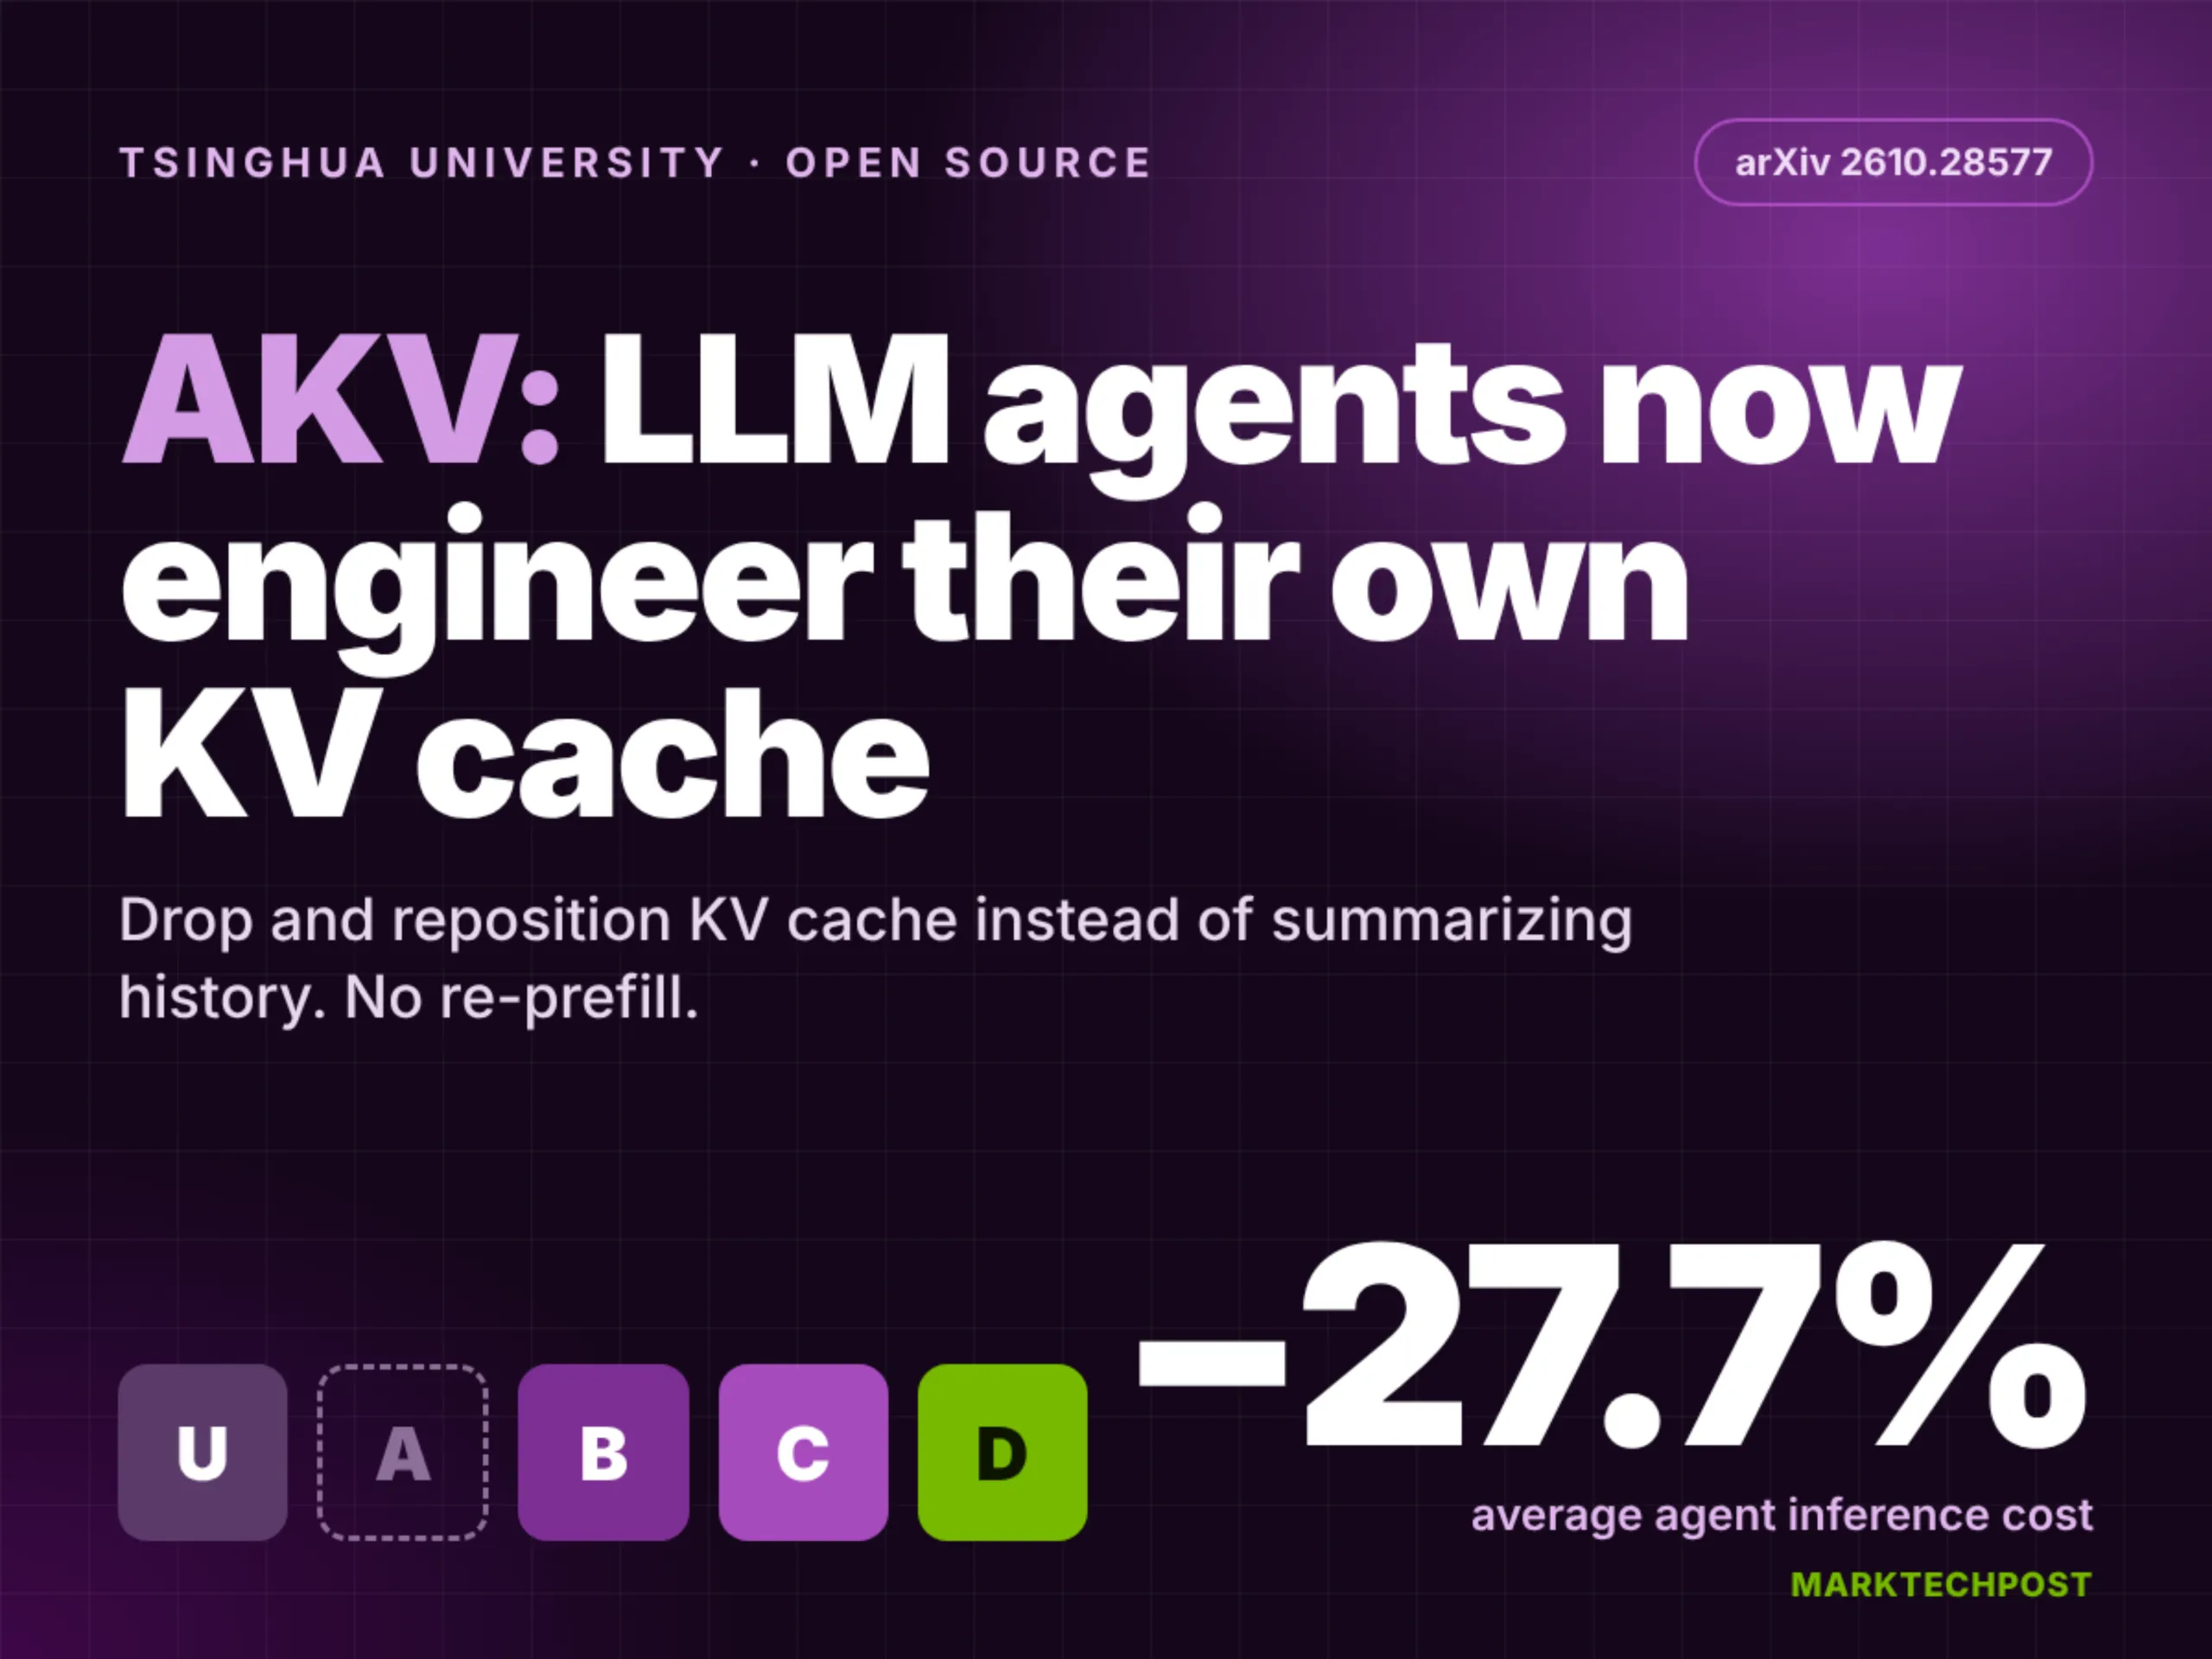
Universitatea Tsinghua lansează AKV: Serverul de cache open-source care revoluționează performanța agentilor LLM pe SGLang
Universitatea Tsinghua lansează AKV, un server de cache KV open-source specializat pentru agenți LLM pe SGLang. Dezleagă cache-ul de GPU, folosește evicție semantic-aware și reduce costurile de inferență cu 60-80%, devenind o componentă esențială pentru AI-ul în producție.
AI
Batching continuu: De la primele principii la optimizarea inferenței AI
Articolul explorează mecanismele fundamentale ale inferenței în modelele de limbaj de mari dimensiuni, de la atenție și KV caching până la batching-ul continuu, explicând cum aceste tehnici optimizează throughput-ul în scenarii de servire în sarcină ridicată.