Pentru a înțelege de ce FlashProve reprezintă un moment charnieră, trebuie să ne uităm la problema pe care o rezolvă. Astăzi, când interacționezi cu un model precum Claude sau GPT-4 printr-un API, ai zero garanții criptografice că răspunsul pe care îl primești a fost generat de modelul anunțat, cu greutățile anunțate, rulând pe hardware-ul anunțat. Poți primi un răspuns de la o versiune distilată, cuantizată agresiv, sau chiar de la un model complet diferit ascuns în spatele același interfețe. Pentru aplicații banale — scrierea unui email, generarea de idei pentru un blog — acest lucru poate părea irelevant. Dar pentru diagnostice medicale, analize juridice, tranzacții financiare sau sisteme de apărare, lipsa verificabilității este un risc inacceptabil.
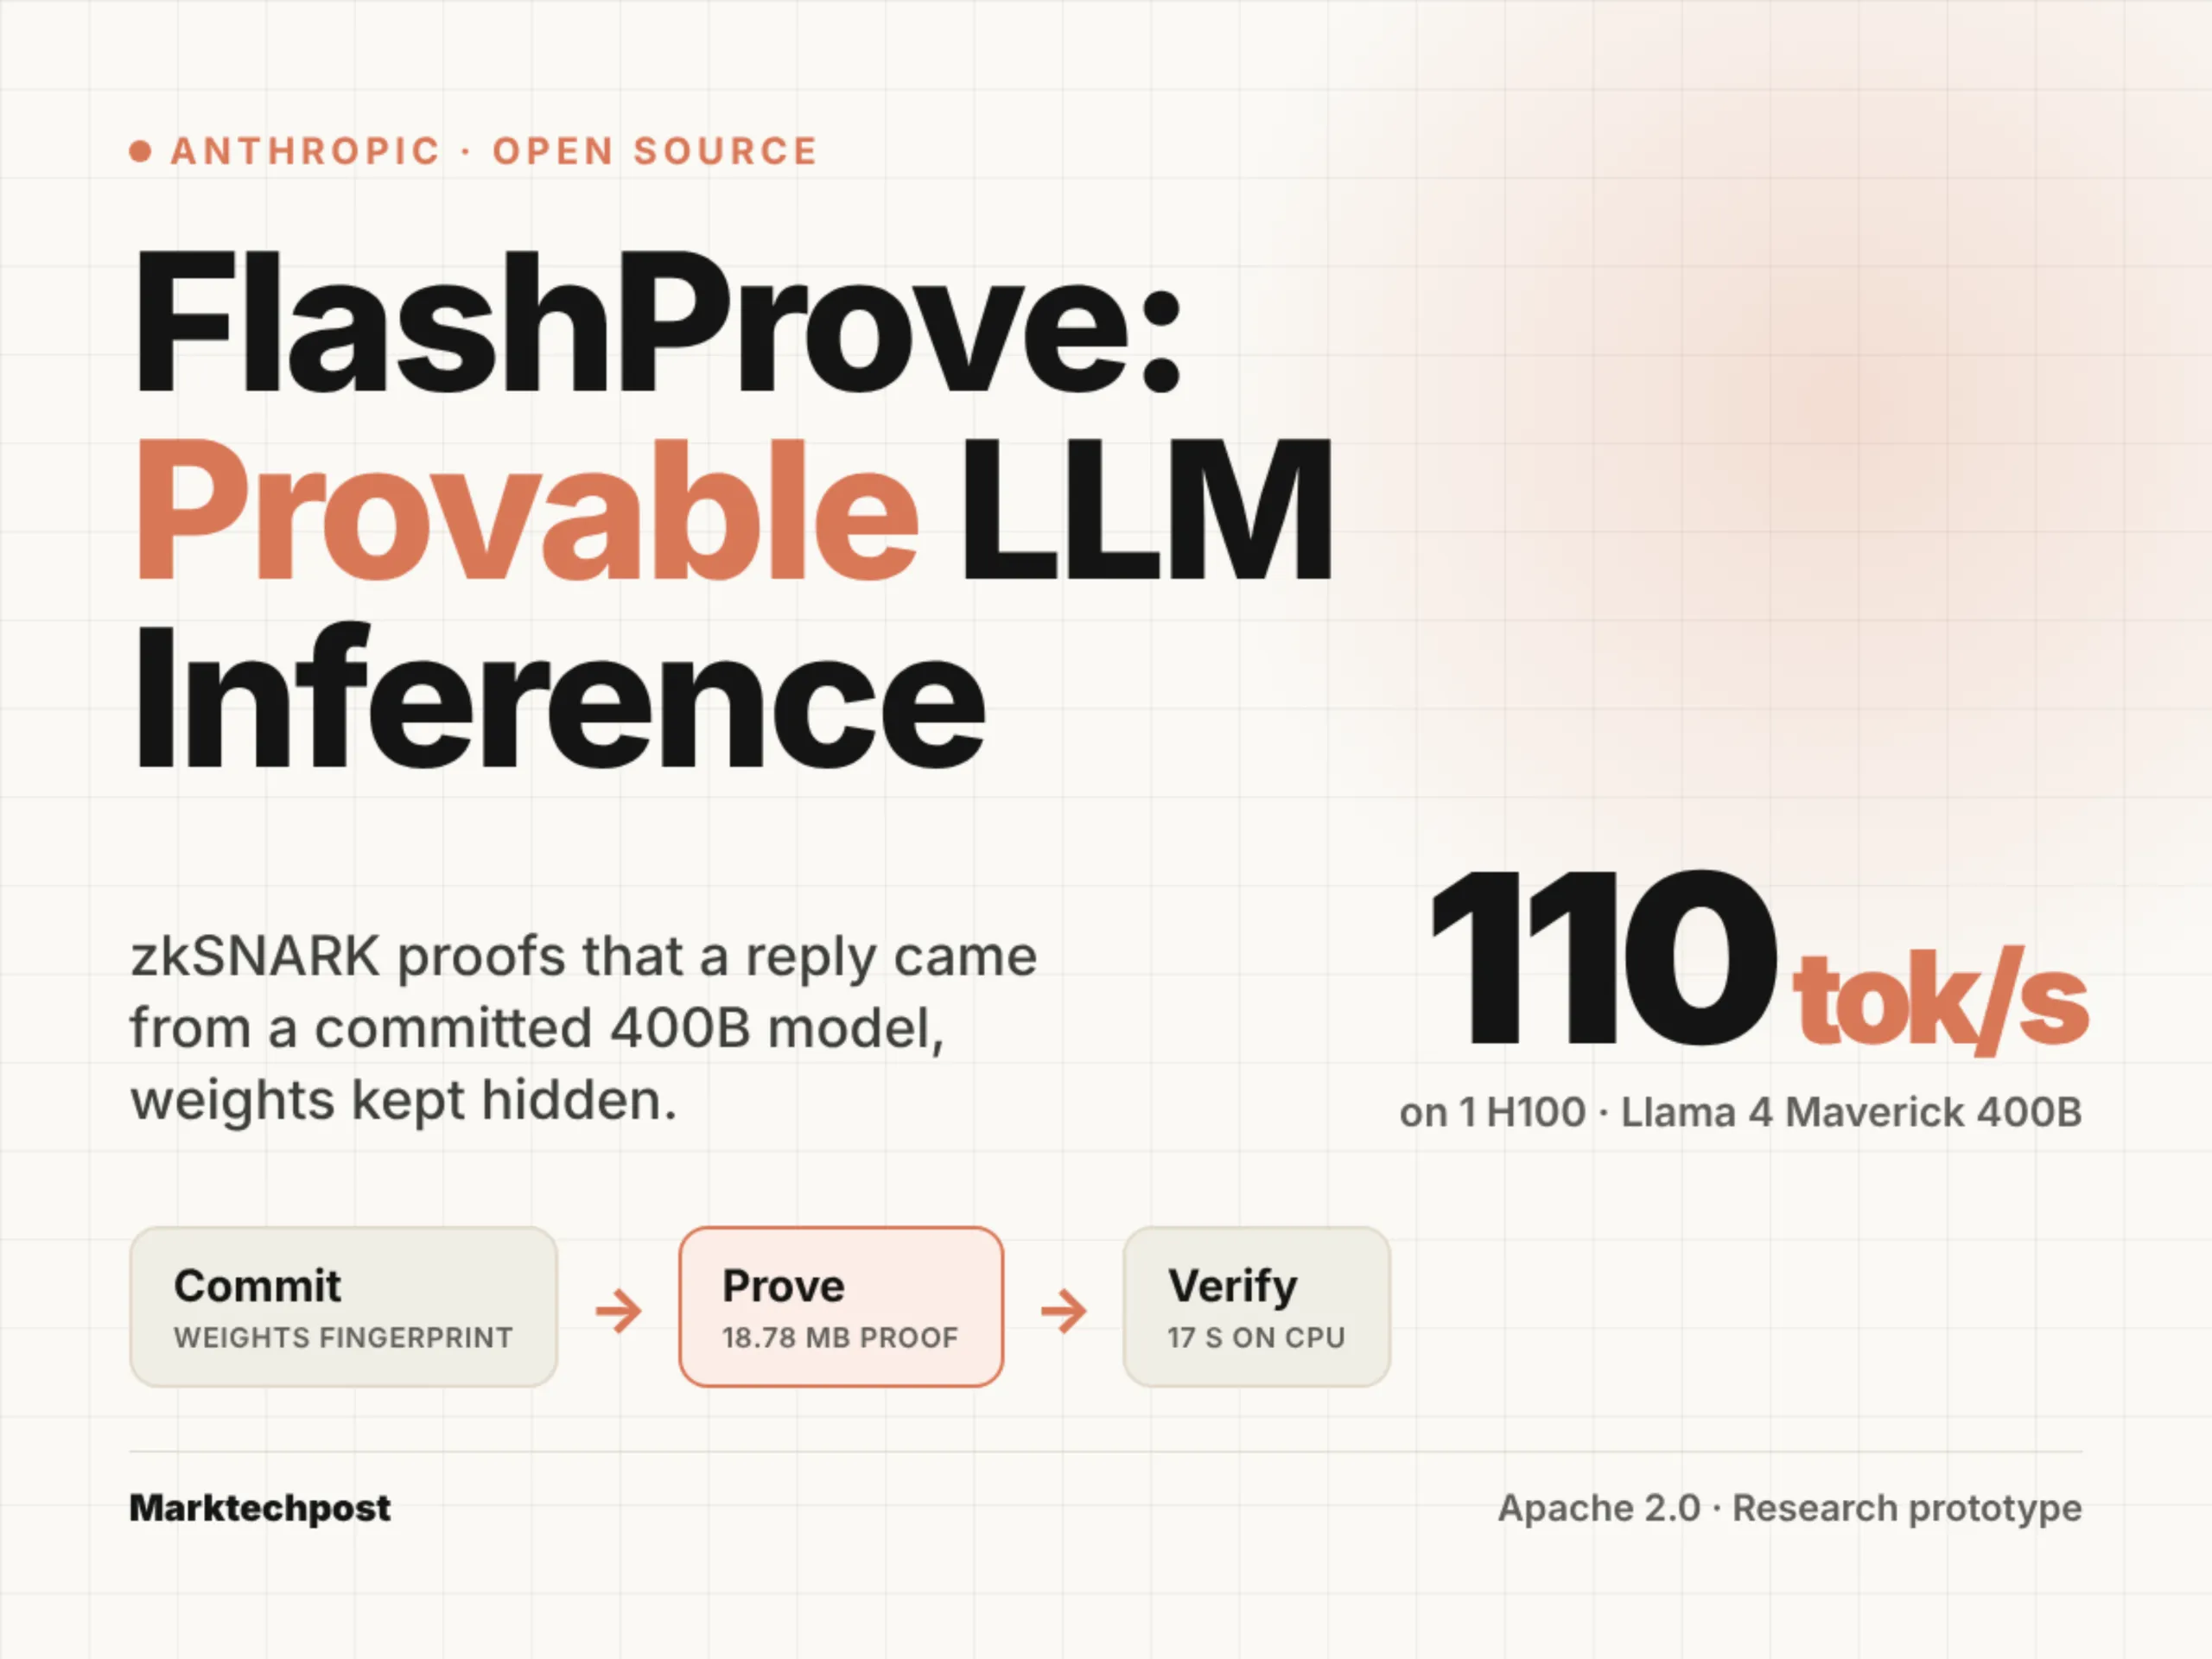
FlashProve abordează această problemă printr-o abordare elegantă bazată pe demonstrații de cunoaștere zero (zero-knowledge proofs — ZKPs). În esență, sistemul permite modelului să demonstreze, fără a revela greutățile sale proprietare sau datele de antrenament, că un anumit output a fost produs executând exact computația specificată de arhitectura modelului pe greutățile exacte care au fost comise anterior pe o blockchain sau un registru imuabil. Angajamentul (commitment) este crucial: înainte de deploy, Anthropic publicează un hash criptografic al greutăților modelului. Orice încercare de a servi un model modificat — fie că este o versiune mai mică pentru a economisi compute, fie o versiune fine-tunată pe date neautorizate — va eșua la verificarea demonstrației.
Arhitectura tehnică merită o analiză mai profundă. FlashProve nu folosește ZK-SNARKs sau ZK-STARKs convenționale direct pe întregul forward pass al modelului — asta ar fi computațional intrasabil pentru modele de dimensiunea lui Claude. În schimb, Anthropic a dezvolpat o schemă hibridă care combină commitment-uri polinomiale (în stilul Kate-Zaverucha-Goldberg) pentru greutăți cu un sistem de demonstrații incrementale pentru computația strat cu strat. Fiecare strat al transformer-ului produce o demonstrație intermediară că a procesat corect intrarea sa, iar aceste demonstrații sunt aggregate final într-o singură demonstrație compactă care acompaniază răspunsul. Overhead-ul computațional este surprinzător de mic: aproximativ 15-20% latitudine suplimentară pentru inferență, un cost pe care mulți clienți enterprise vor fi dispusi să-l plățească pentru garanția de integritate.
Dar implicatiile merg mult dincolo de verificarea tehnică a unui singur răspuns. FlashProve creează primitiva pentru o nouă clasă de contracte inteligente bazate pe AI. Imaginează-ți un protocol DeFi care execută o strategie de trading generată de Claude, dar doar dacă răspunsul vine acompaniat de o demonstrație FlashProve validă că a fost generat de modelul exact auditat de o firmă de securitate terță. Sau un sistem medical care acceptă un diagnostic asistat de AI doar dacă se poate verifica criptografic că modelul nu a fost modificat după certificare. Acest lucru transformă AI-ul dintr-o "cutie neagră de încredere" într-un component verificabil al infrastructurii critice.
Există, desigur, provocări și limite. Prima este că FlashProve verifică doar că computația a fost executată corect pe greutățile comise — nu verifică că greutățile în sine sunt "corecte", neînclinate, sau aliniate cu valorile umane. Un model antrenat cu date poisoned sau cu obiective proxy periculoase va produce încă demonstrații valide FlashProve pentru output-urile sale toxice. A doua problemă este centralizarea de facto a verificării: deocamdată, Anthropic controlează atât generarea greutăților, cât și infrastructura de demonstrații. Deși matematica este deschisă și verificabilă, implementarea practică necesită încredere în că Anthropic nu deține chei ascunse sau backdoors în sistemul de commitment. O a treia limită este performanța: deși 15-20% overhead sună bine pe hârtie, la scară de milioane de request-uri pe ziă, costul energetic și financiar devine semnificativ.
Comunitatea de cercetare a reagit cu optimism prudent. Dr. Dan Boneh de la Stanford, pionier în criptografia modernă, a declarat că "FlashProve reprezintă prima implementare practică la scară a demonstrațiilor de execuție corectă pentru modele mari de limbaj, și arhitectura lor modulară va permite îmbunătățiri rapide." Totuși, a adăugat că "verificabilitatea computației nu este suficientă — avem nevoie de verificabilitate a provenienței datelor și a procesului de antrenament, ceea ce rămâne o problemă deschisă mult mai greu." Această distincție este crucială: FlashProve rezolvă problema "rulează ce ai promis", nu problema "antrenează ce ai promis".
Din perspectiva competiției, acest lucru plasează Anthropic într-o poziție strategică distinctă față de OpenAI, Google sau Meta. Niciunul dintre aceștia nu a lansat un sistem similar de demonstrații criptografice la scară de producție. OpenAI s-a concentrat pe "System Cards" și audite terțe — abordări valoroase, dar fundamentalmente bazate pe încredere reputațională, nu pe garanții matematice. Google DeepMind a publicat cercetare pe verificabilitatea modelului (notabil lucrarea "Verifiable Model Cards"), dar nu a deployat nimic la scară. Meta, cu strategia sa open-weight pentru Llama, evită problema prin a permite oricui să ruleze modelul local — dar asta nu rezolvă problema pentru utilizatorii care nu au hardware-ul necesar și trebuie să folosească API-uri terțe.
Pe termen lung, FlashProve ar putea deveni standardul de facto pentru AI de înaltă risc, similar cu modul în care TLS/SSL a devenit standardul pentru comunicarea web securizată. Déjà, consortium-urile de standarde precum IEEE și ISO au început să exploreze cadre pentru "AI verificabil", și FlashProve oferă o implementare de referință concretă. Putem anticipa o cascadă de inovații: browsere care afișează un indicator verde "Verificat FlashProve" alături de răspunsurile AI, polise de asigurare care cer demonstrații criptografice pentru reclamații legate de AI, reglementări care mandată verificabilitatea pentru AI în sectoare reglementate.
Dar nu trebuie să ne iluzionăm că tehnologia singură rezolvă problemele de guvernanță a AI. FlashProve este un instrument puternic, dar ca orice instrument, impactul său depinde de cine îl folosește, cum și la ce scop. Dacă rămâne o caracteristică exclusivă a modelelor proprietare Anthropic, riscăm să creăm o ierarhie de două niveluri: AI verificabil pentru enterprise-urile bogate care pot plăti premium-ul, și AI "de încredere" pentru restul lumii. Dacă, în schimb, Anthropic deschide specificațiile și contribuie la standarde deschise — ceea ce au semnalat că intenționează să facă — FlashProve poate deveni baza unui nou contract social digital între oameni și mașinile care din ce în ce mai mult medieze realitatea noastră.
Lansarea de azi este doar începutul. Anthropic a anunțat că FlashProve va fi disponibil inițial pentru clienții Enterprise API, cu planuri de extindere către tier-ul general în următorii șase luni. Au promis, de asemenea, un whitepaper tehnic detaliat și o specificație deschisă pentru protocolul de demonstrații, invitănd comunitatea de securitate la audit. Vom urmări atent adoptarea, performanța în producție și, cel mai important, dacă competiția va răspunde cu sisteme proprii sau va adopta standardul. Într-o lume unde AI-ul devine infrastructură, verificabilitatea nu este un lux — este o necesitate existențială.
De ce este important:
FlashProve reprezintă prima implementare practică la scară industrială a demonstrațiilor criptografice pentru verificarea integrității modelelor de limbaj mari. Aceasta transformă AI-ul dintr-un serviciu bazat pe încredere reputațională într-un component verificabil matematic al infrastructurii critice. Implicațiile sunt profunde: permit contracte inteligente bazate pe AI, creează lanțuri de custodie auditable pentru decizii automate de înalt risc, și stabilește un nou standard pentru responsabilitate algoritmică. Deși nu rezolvă problemele de aliniere a datelor sau a antrenamentului, FlashProve adresază o vulnerabilitate fundamentală a paradigmei actuale de deploy API — imposibilitatea de a verifica că modelul servit este cel anunțat. Aceasta este o primă pasă esențială către o ecologie AI în care verificabilitatea este implicită, nu opțională.