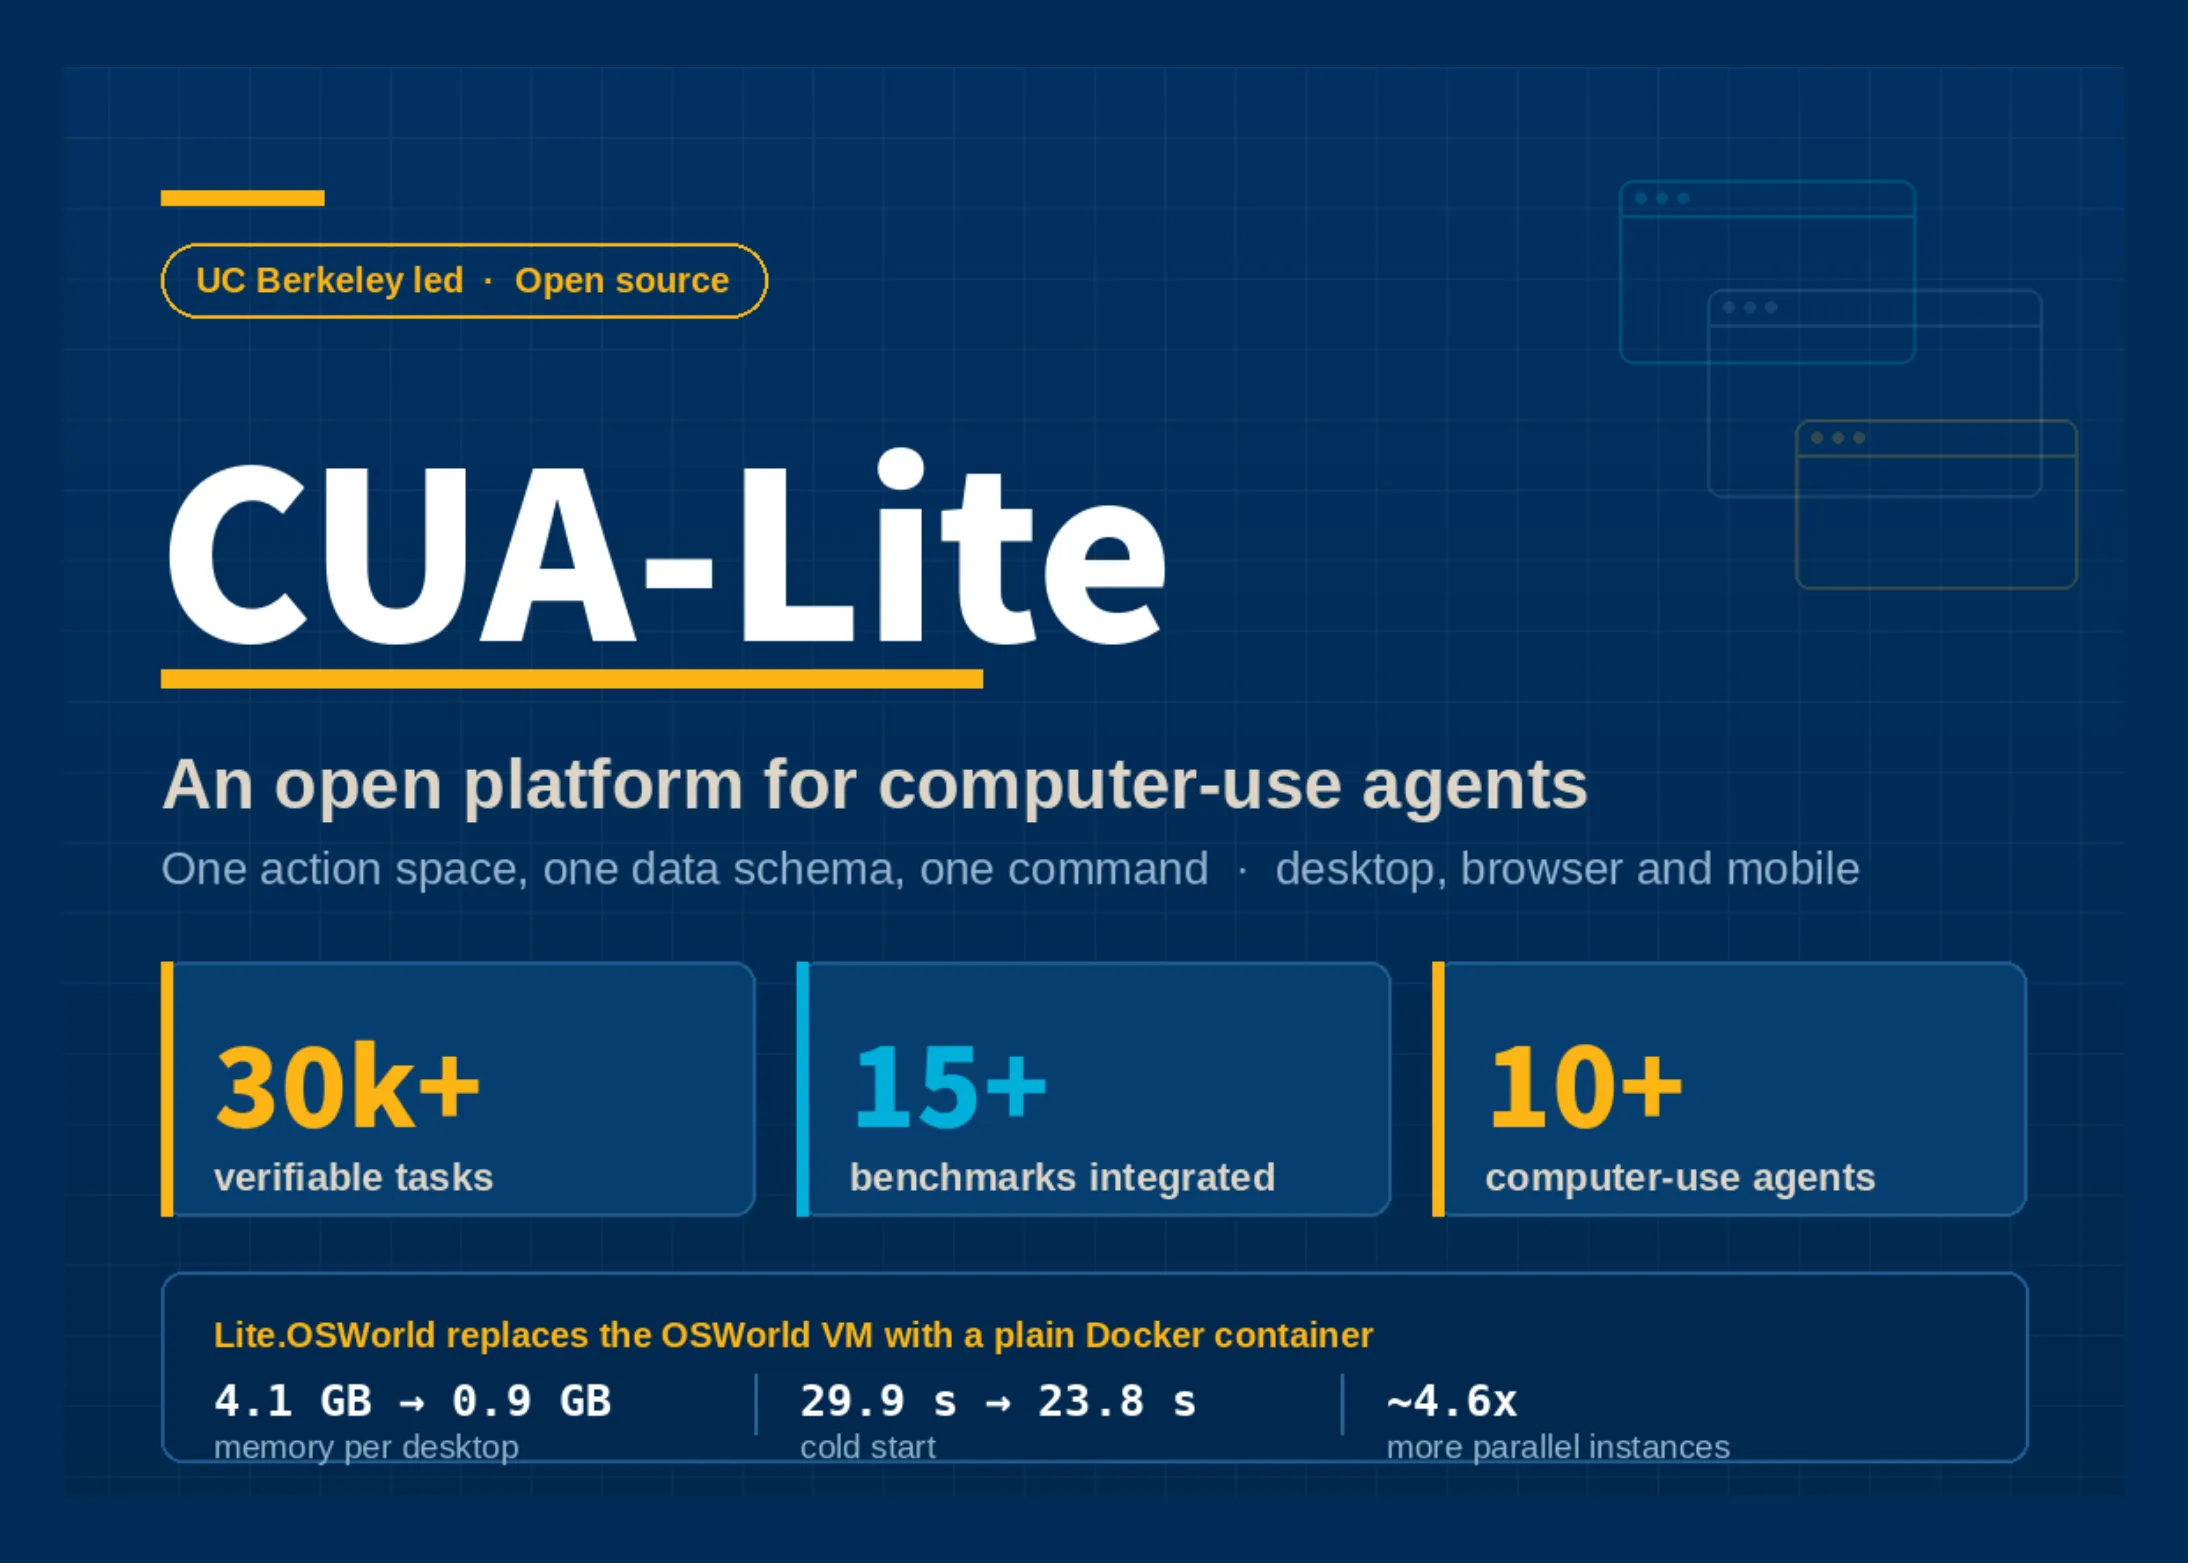
Pentru cei inițiați, termenul "computer-use agent" (CUA) a devenit un buzzword în ultimii ani, popularizat în special de demonstrațiile spectaculoase ale modelelor precum Operator de la OpenAI sau Computer Use de la Anthropic. Acești agenți nu se limitează la generarea de text sau cod; ei "văd" ecranul, "mută" mouse-ul, "tastează" la tastatură și navighează în sisteme de operare reale pentru a îndeplini sarcini complexe: de la rezervarea unui bilet de avion și completarea unui formular fiscal, la depanarea unei erori într-un container Docker sau scrierea și rularea de teste unitare pentru un proiect software. Problema? Până acum, construirea, testarea și antrenarea unui astfel de agent a fost un capcana logistică.
"Fiecare grup de cercetare își construia propriul sandbox, propriul set de date, propriul framework de evaluare", mi-a confidat un doctorand de la Berkeley, preferând anonimatul pentru că nu este portavoficial. "Era o turnul Babel. Nu puteai reproduce rezultatele altuia, nu puteai compara modelele head-to-head, și, cel mai grav, nu puteai face RL la scară largă pentru că mediul de antrenament era fragil și greu de scalat."
CUA-Lite vine să spargă exact acest blocaj. La nivel arhitectural, platforma este compusă din patru piloni fundamentali, fiecare gândit modular, dar integrat nativ cu celelalte.
Primul pilon este sandbox-ul. Nu este un simplu container Docker, ci un mediu virtualizat ușor, bazat pe microVM-uri (Firecracker), care pornește în sub-secunde și izolează complet execuția agentului de sistemul gazdă. Acest lucru înseamnă că poți rula mii de episoade de antrenament paralel, fără să te îngrijorezi că un agent dezordonat va șterge fișierele sistemului sau va accesa rețeaua neautorizat. Sandbox-ul expune o interfață unificată de tip "observație-acțiune": observația este un screenshot (sau un flux video) al desktop-ului, iar acțiunea este un tuplu (tip_acțiune, coordonate, text_opțional) care acoperă click-uri, tastare, scroll, drag-and-drop și taste de scurtătură.
Al doilea pilon este stratul de date. CUA-Lite vine ambalat cu CUA-Bench, un benchmark nou, curat și extensibil, care acoperă trei categorii majore de sarcini: productivitate de birou (Google Docs, Sheets, email, calendar), dezbvoltare software (VS Code, terminal, Git, browser pentru documentație) și navigare web complexă (formulare multi-pas, site-uri cu conținut dinamic, autentificare). Datele nu sunt statice; platforma include un motor de generare de traiectorii sintetice care poate crea noi episoade de antrenament pe cerere, variind configurația ferestrelor, rezoluția, tema vizuală și chiar limba interfeței. Aceasta este o cheie criticală pentru RL: diversitatea mediului previne overfitting-ul agentului la anumite pattern-uri vizuale.
Al treilea pilon, evaluarea, este poate cel mai inovativ. Majoritatea benchmark-urilor actuale (precum OSWorld sau WebArena) se bazează pe o singură metrică: success rate (a reușit sau nu agentul să finalizeze sarcina?). CUA-Lite introduce un framework de evaluare multidimensional: success rate, da, dar și step efficiency (câte acțiuni a folosit comparativ cu un expert uman), recovery rate (cât de bine se recuperează după o greșeală), safety violations (a accesat fișiere interzise? a dat click pe reclame?), și compute cost (câte FLOPS a consumat modelul de vizionare pentru a procesa screenshot-urile). Rezultatele sunt aggregate într-un scor compus, CUA-Score, care permite o comparare justă între agenți de dimensiuni și arhitecturi diferite – de la un GPT-4V masiv până la un model open-source de 7B parametri distilat local.
Ultimul pilon, RL (Reinforcement Learning), este motorul care le leagă pe toate. CUA-Lite nu te obligă să folosești un anumit algoritm (PPO, GRPO, DPO, etc.), dar îți oferă infrastructura pentru a face RL la scară: un replay buffer distribuit care stochează tranzițiile (observație, acțiune, recompensă, următoarea observație), un reward server care calculează recompensele dense (nu doar sparse la finalul episodului) folosind modele de recompensă antrenate pe feedback uman, și o integrare nativă cu Ray și Accelerate pentru antrenament multi-GPU/multi-nod. Crucial, platforma suportă offline RL (antrenament pe date colectate anterior) și online RL (colectare activă de date prin explorare), permițând o curbură de învățare continuă.
Dar de ce "Lite"? Numele nu este un eufemism pentru "slab". Este o promisiune de ușurință de adopție. Toată stiva rulează cu o singură comandă: `pip install cua-lite && cua-lite launch`. Nu ai nevoie de un cluster Kubernetes, nu ai nevoie de o contabilitate AWS de 10.000 dolari/lună pentru a începe. Un singur GPU (chiar și un RTX 3090/4090 consumer) este suficient pentru a rula evaluări complete și chiar pentru a face fine-tuning RL pe modele mici. Pentru scalare, platforma se extinde orizontal fără schimbări de cod.
Impactul potențial este uriaș. În acest moment, barrera la intrare pentru a construi un agent computer-use competitiv este estimată la zeci de ingineri și luni de muncă doar pentru plumbing-ul infrastructurii. CUA-Lite reduce aceasta la ore. Așteptăm să vedem o explozie de experimente: agenți specializați pentru QA testing automat, agenți care migrează aplicații legacy în cloud, agenți care fac accessibility testing real (navigând cu screen reader), agenți care învață să joace jocuri video vechi pentru preservare digitală. Și, poate cel mai important, o bază comună pentru siguranță. Acum putem benchmark-ui standardizat prompt injection resistance, data exfiltration attempts, sau unintended purchases într-un mediu controlat, înainte de a deploya agenții în producție.
Comunitatea a reagit rapid. În primele 48 de ore, repository-ul a strâns peste 2.000 de stele, iar canalul Discord dedicat a ajuns la 1.500 de membri. Contribuții au început să apară: un wrapper pentru Windows (inițial era Linux-only), un adapter pentru modelul local Qwen2-VL-7B, un script de conversie a datelor WebArena în formatul CUA-Lite. Echipa Berkeley a anunțat că urmează CUA-Pro, o versiune cu sandbox-uri GPU-accelerate (pentru jocuri/rendering 3D), suport nativ pentru mobile (Android/iOS via emulare), și un marketplace de module de competență (skills) pre-antrenate: "book_flight", "debug_python", "fill_tax_form".
Nu totul e perfect. Criticii (înclusiv unii din propria echipă Berkeley, off-record) îndoiesc că generalizarea va rămâne problema nr. 1. Un agent antrenat pe CUA-Bench să rezolve sarcini de birou poate eșua dramatic pe o interfață medicală specializată sau un panou de control industrial SCADA. De asemenea, costul computațional al observației vizuale (procesarea screenshot-urilor la 10-20 FPS printr-un ViT mare) rămâne collo de bottleneck pentru latenta interactivă în timp real. Dar aceste sunt probleme de cercetare, nu de infrastructură. Și CUA-Lite a rezolvat partea de infrastructură.
Într-un peisag dominat de modele proprietare "black-box" accesate prin API-uri costisitoare și opace, CUA-Lite este o lufță de aer curat. Nu garantează că vom avea agenți perfecti mâine, dar garantează că oricine cu o idee bună și un GPU poate începe să experimenteze astăzi. Și istoria AI-ului ne învață că învingătorii nu sunt cei care au cele mai mari modele, ci cei care au cele mai bune unelte pentru a itera rapid.
De ce este important:
CUA-Lite nu este doar un instrument tehnic; este un catalyst pentru democratizarea agenților AI. Prin eliminarea barierei infrastructurale – sandbox-uri fragile, benchmark-uri fragmentate, lipsa de pipeline-uri RL scalabile – platforma mută focusul comunității de la "cum fac să ruleze asta?" la "cum fac să fie mai inteligent?". Acest lucru accelerează inovația, permite evaluarea riguroasă a siguranței înainte de deploy, și oferă o alternativă credibilă la ecosistemele închise ale giganților tehnologici. Pentru România și Europa, unde resursele de compute sunt limitate, un astfel de framework open-source, ușor de rulat local, este esențial pentru suveranitate tehnologică și pentru a forma o nouă generație de ingineri AI capabili să construiască, nu doar să consume, agenți autonomi.