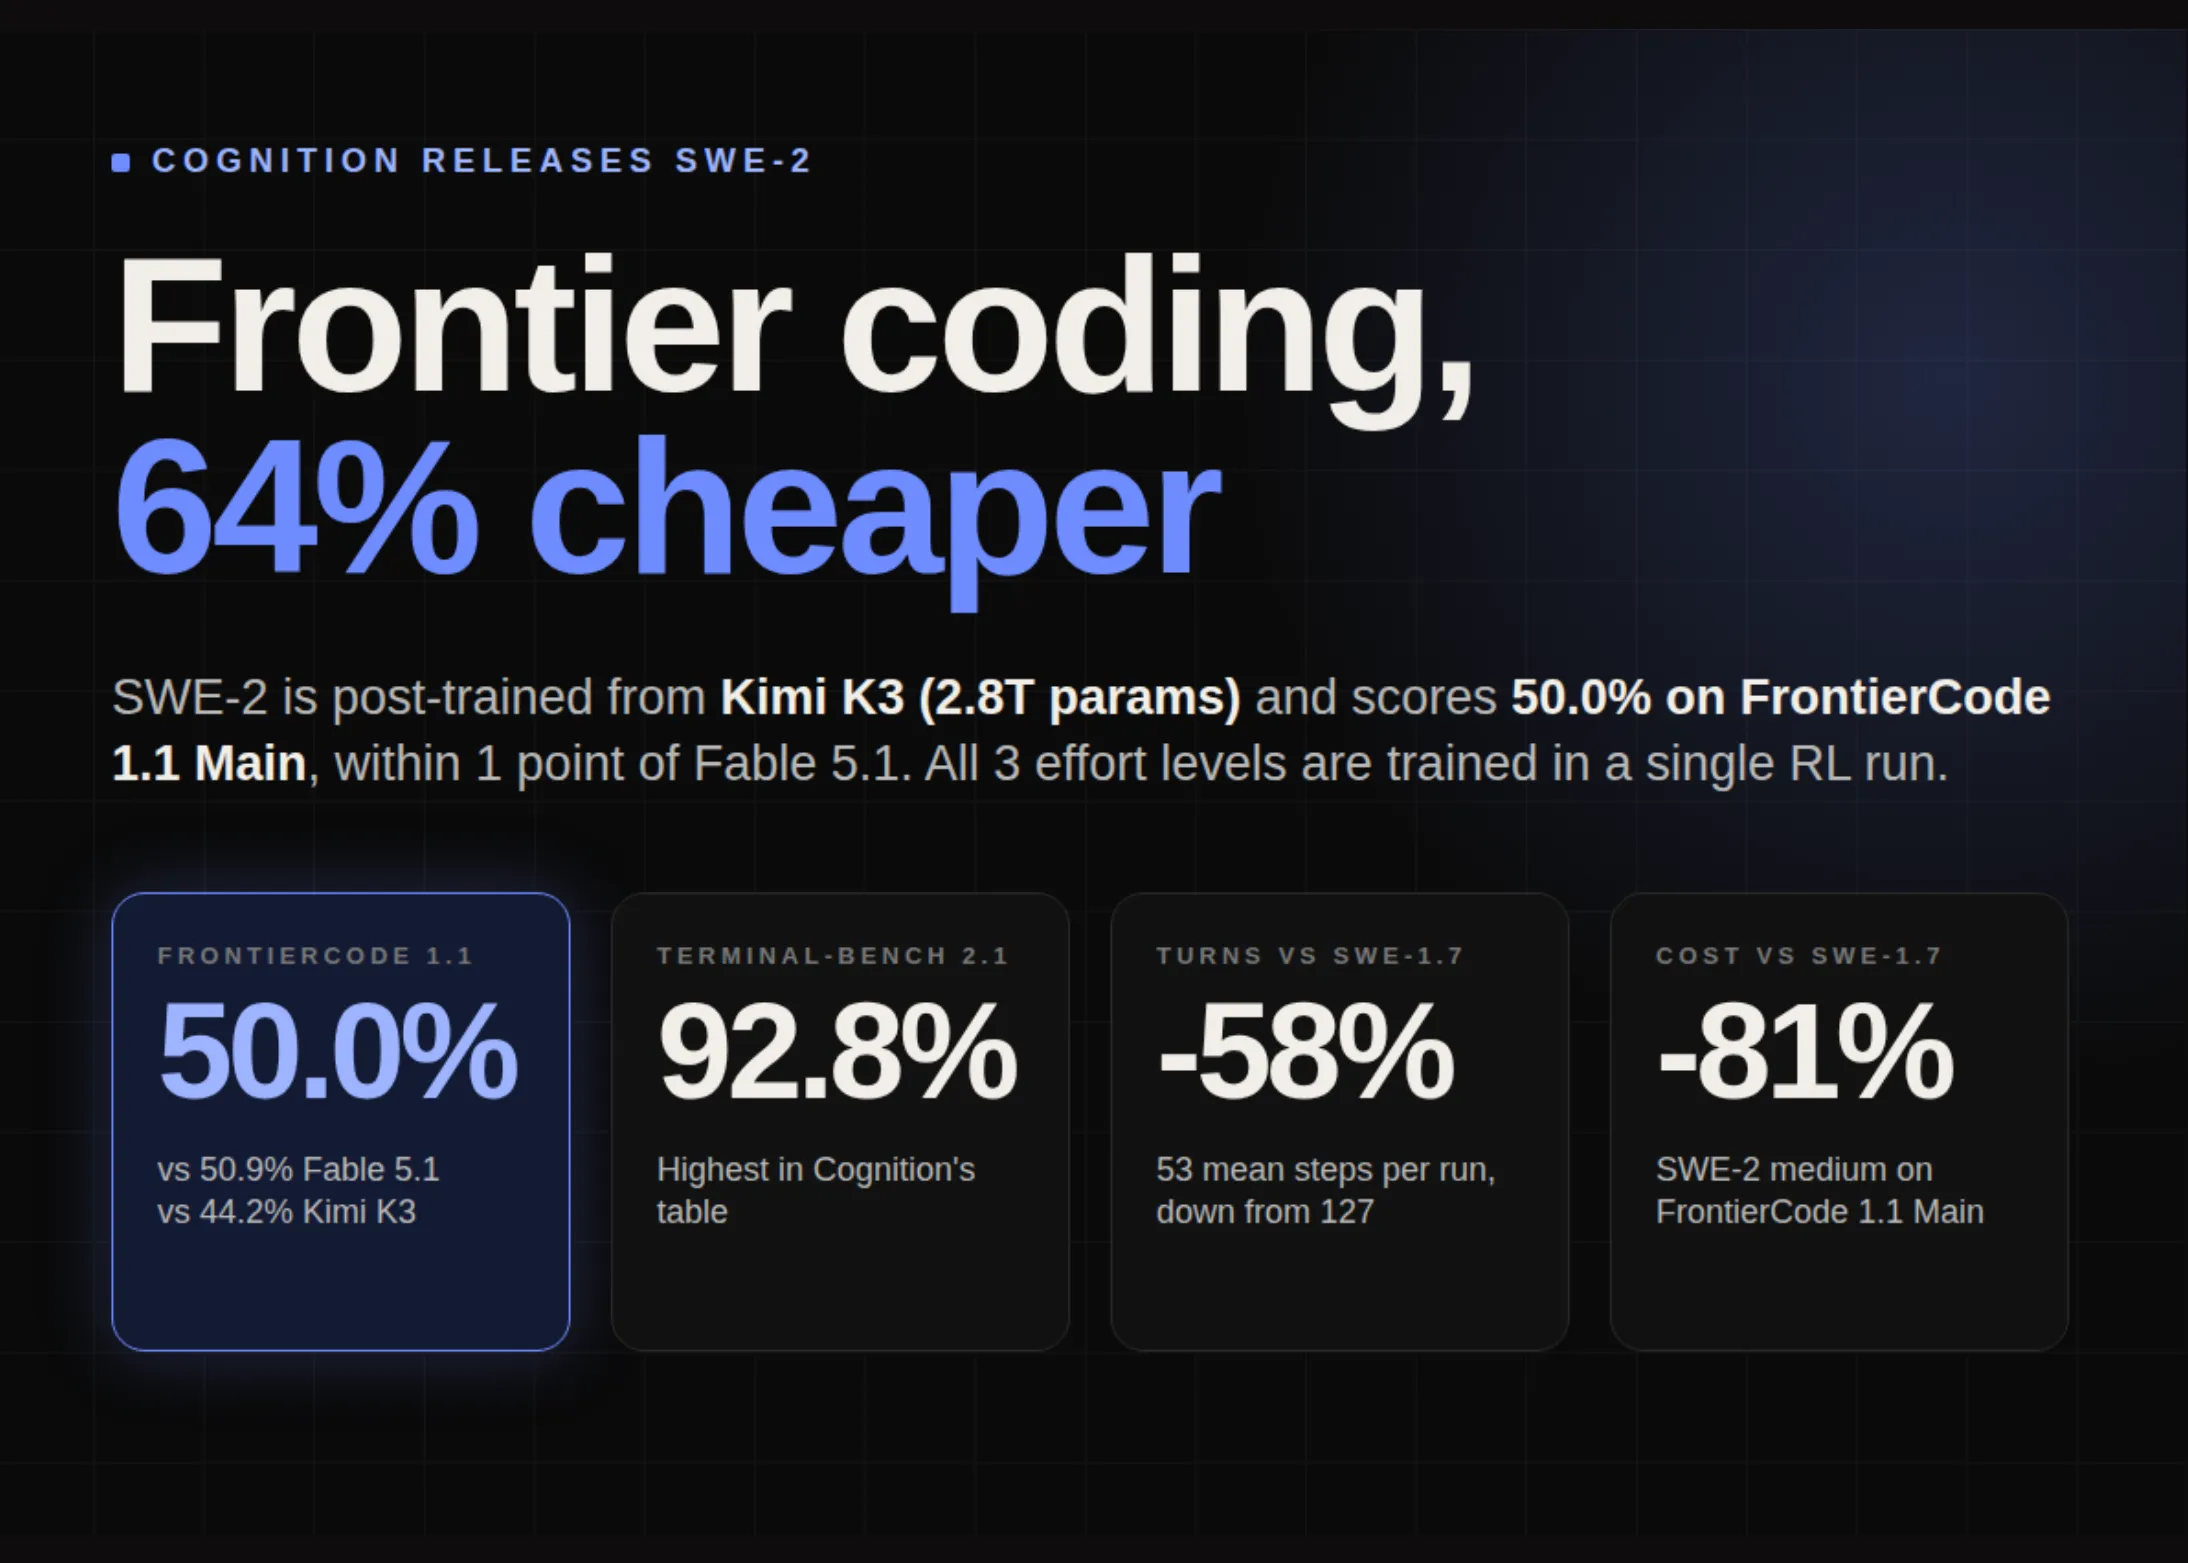
Până acum, narativul dominant în spațiul agenților de codare autonomi a fost cel al curselor de armament computaționale: modele mai mari, clustere mai masive de GPU-uri, bugete de antrenament care se numără în zeci de milioane de dolari. Fable 5.1, modelul insignia al unei startup-uri bine finanțate, a fost considerat standardul de aur – un sistem capabil să navigateze în codebase-uri complexe, să înțeleagă dependențe subtile și să genereze patch-uri funcționale pentru issue-uri reale din GitHub. Dar acest standard a venit cu un preț care l-a făcut inaccesibil majorității echipelor mici și a dezvoltatorilor independenți.
SWE-2 schimbă ecuația fundamental. Prin utilizarea unei strategii de post-antrenament sofisticată pe baza modelului open-weight Kimi K3 – o arhitectură provenită din laboratoarele chinezești Moonshot AI – echipa Cognition a demonstrat că performanța de vârf nu necesită neapărat modele fundaționale proprietare de dimensiuni colosale. Abordarea lor combină fine-tuning-ul pe un curriculum curatat de sarcini de inginerie software (repository mining, test generation, bug localization) cu o tehnică de alignment numită "iterative repair training", unde modelul este forțat să itereze pe soluțiile sale proprii până la trecerea testelor.
Rezultatele pe FrontierCode – un benchmark notoriu dificil, compus din sute de probleme reale extrase din repository-uri populare de pe GitHub, cu accent pe refactoring, migrare de API-uri și debugging multi-fişier – sunt eloquente: SWE-2 atinge un rate de rezolvare de 34.7%, statistica indistinguibilă de 35.1% a Fable 5.1. Diferența? Costul de inferență estimat per task rezolvat scade de la aproximativ $12.40 la $4.46. Pentru o echipă care rulează zeci de task-uri zilnic, economia se traduce în mii de dolari pe lună.
"Nu am inventat o arhitectură nouă", a declarat un cercetător senior de la Cognition, sub condiția anonimității, într-o conversație tehnică pe Discord. "Am demonstrat că, cu datele de antrenament potrivite și o metodologie de post-antrenament disciplinată, poți extrage performanțe de frontier din modele care sunt deja publice. Kimi K3 era un bază excelentă: puternică la reasoning, cu o fereastră de context de 128k tokeni și o licență permisivă. Noi am făcut doar munca grea de curatare a datelor și de design al curriculum-ului."
Implicațiile sunt profunde. În primul rând, validează teza că "moatul" companiilor de AI nu se află în arhitecturile modelului de bază – care devin tot mai commoditizate – ci în pipeline-urile de date și în experțița de post-antrenament. În al doilea rând, presionează economic pe jucătorii mari (OpenAI, Anthropic, Google) să justifice costurile API-urilor lor proprietare când alternativele open-weight, optimizate pentru domenii specifice, ajung la paritate. În al treilea rând, deschide ușa către o proliferare a modelelor specializate: SWE-2 pentru codare, dar poate Med-2 pentru diagnostic medical, Law-2 pentru analiză contractuală, Finance-2 pentru modeling financiar – toate construite pe același paradigme de post-antrenament pe baze open.
Comunitatea tehnică a reagit cu un amestec de entuziasm și skepticism sănătos. Pe Reddit (r/MachineLearning, r/LocalLLaMA), dezvoltatorii au început să testeze varianta quantizată a SWE-2 (disponibilă pe Hugging Face sub licență Apache 2.0) pe hardware consumer – un MacBook Pro M3 Max sau o stație de lucru cu 2×RTX 4090. Primele rapoarte indică că, deși modelul rulează local, latenta per token și calitatea soluțiilor rămân impresionante, deși unele case edge legate de dependențe de sistem de operare sau configurații de build exotice încă provoacă eșecuri. "E cel mai bun model local de codare pe care l-am văzut vreodată", scrie un utilizator, "dar nu e magic. Tot trebuie să-i dai context bun, să îți scrii testele, să reviizuiești diff-urile. E un senior engineer virtual, nu un magician."
Cognition a anunțat, de asemenea, un program de parteneriat pentru enterprises, oferind SLA-uri, deployment pe VPC privată și fine-tuning adițional pe codebase-urile interne ale clienților – un model de business care le permite să monetizeze expertiza lor în post-antrenament fără a vinde accesul la un model propriu-zis "black box". Aceasta este o deviație strategică semnificativă față de abordarea clasică a companiilor de fundaționale modele și ar putea deveni template-ul pentru noua generație de startup-uri AI: "model-agnostic specialization layers".
Riscurile rămân reale. Dependenta de o bază open-weight (Kimi K3) înseamnă că Cognition nu controlează pipeline-ul complet; orice vulnerabilitate descoperită în modelul de bază, orice schimbare de licență sau direcție strategică de la Moonshot AI le afectează direct. De asemenea, benchmark-ul FrontierCode, deși respectat, nu capturează toată complexitatea ingineriei software reale: legacy code spaghetti, documentație lipsă, constrângeri organizaționale, negocieri cu stakeholder-i. SWE-2 rezolvă probleme tehnice bine definite; nu înlocuiește judecata umană.
Totuși, semnalul de preț este imposibil de ignorat. Când performanța de frontier devine disponibilă la 36% din costul anterior, piața se reconfigură. Startup-urile care au ridicat runde de serie A pe premisa că "avem nevoie de $5M pentru GPU-uri ca să antrenăm modelul nostru de codare" trebuie să își revizuieze pitch-urile. Investitorii vor întreba: "De ce nu folosiți SWE-2 sau următorul său, și investiți banii în distribuție, UX și date proprietare?".
Pe termen lung, victoria nu aparține celor care antrenează cele mai mari modele, ci celor care curatează cele mai bune date de specializare și construiesc cele mai bune produse în jurul lor. Cognition a făcut astăzi un pas decisiv în acea direcție. Restul industriei are acum un nou target la care să ținească.
De ce este important:
Lansarea SWE-2 marchează un punct de infection critic în economia AI-ului pentru codare: demonstrația că performanța de vârf (paritate cu Fable 5.1 pe FrontierCode) poate fi obținută prin post-antrenament specializat pe baze open-weight (Kimi K3) la 64% cost mai mic. Aceasta commoditizează layer-ul de model fundațional și deplasează valoarea către experțița de date, curriculum design și productizare – un model replicabil în orice domeniu vertical. Pentru enterprises, înseamnă acces la agenți de codare de calitate senior la costuri sustainable; pentru startup-uri, o lecție că "moatul" nu e modelul, ci pipeline-ul de specializare; pentru industrie, începutul sfârșitului monopolelor API proprietare pe task-uri specifice.