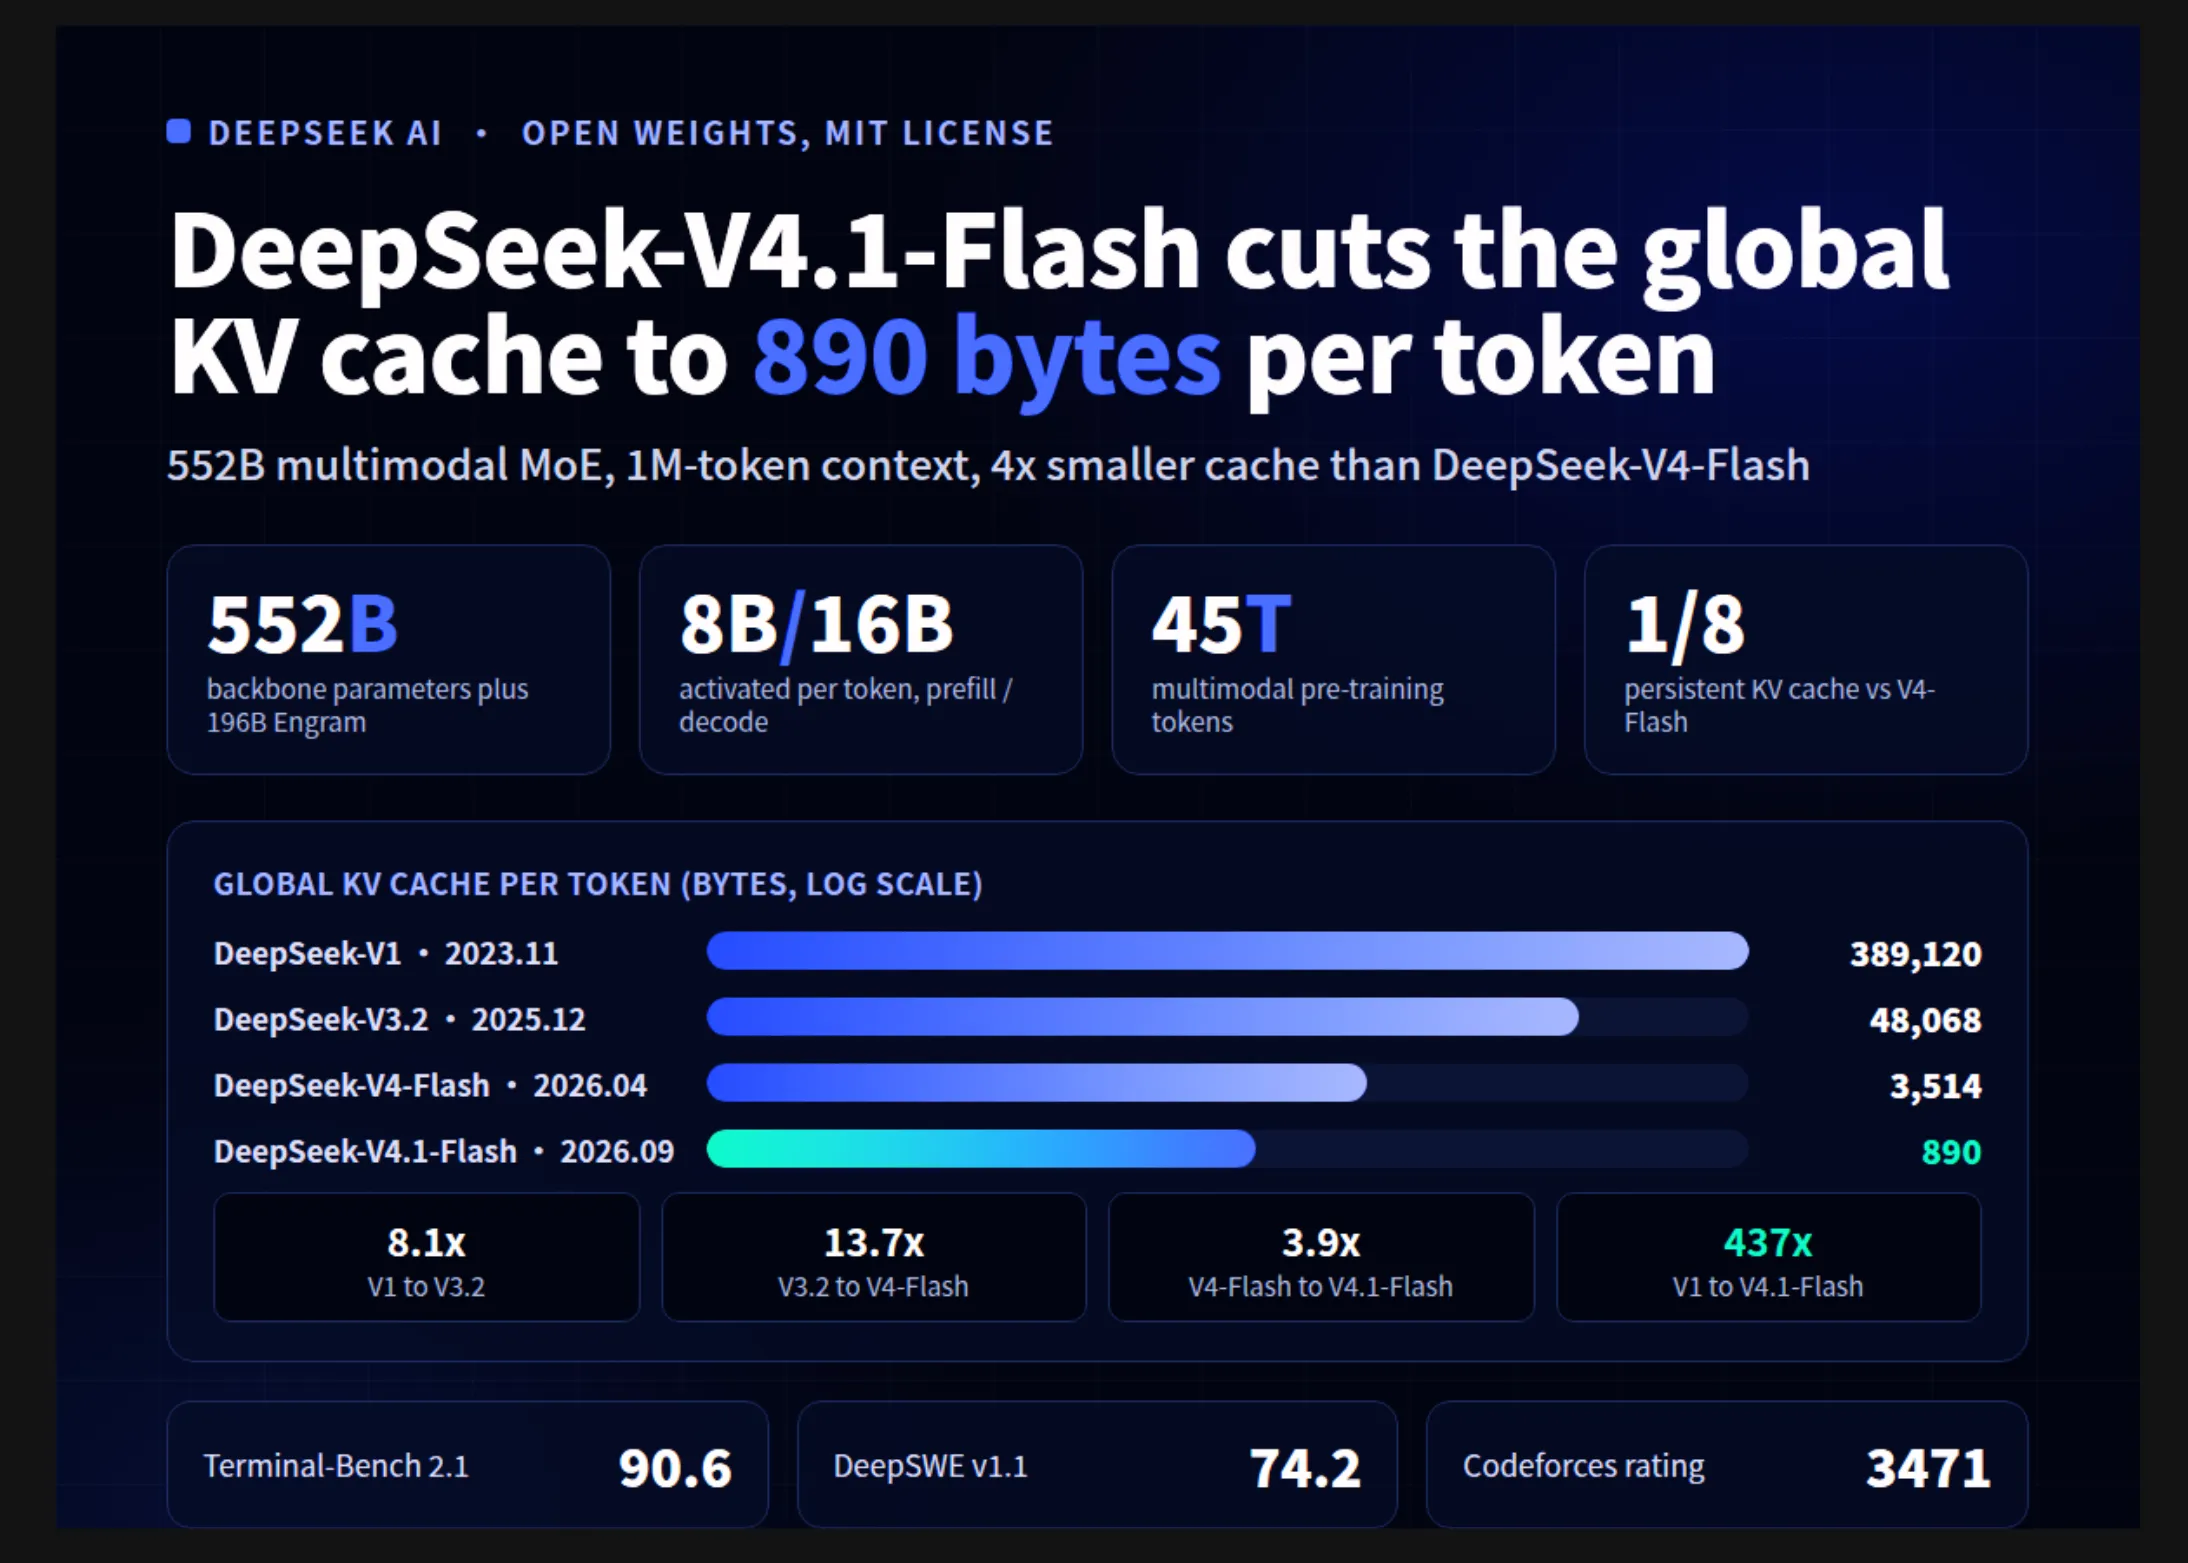
Hai să vorbim pe șleau despre ce înseamnă asta, pentru că dincolo de acronimele pompoase și specificațiile tehnice care îți dau dureri de cap, se ascunde o schimbare fundamentală de paradigmă. Nu e vorba doar de un model mai mare sau mai rapid. E vorba de un model care a învățat să fie eficient într-un mod în care nimeni altcineva nu a îndrăznit să fie până acum.
Contextul de 1 milion de tokeni: când memoria devine superputere
Prima armă din arsenalul lui V4.1-Flash este contextul de 1 milion de tokeni. Ca să înțelegi de ce asta e important, uită-te la cum funcționează creierul uman. Noi nu citim o carte de 500 de pagini ținând minte fiecare virgulă de la început până la sfârșit. Ne amintim esențialul, personajele, firul narativ, dar pierdem detaliile fine. Modelele de limbaj tradiționale erau exact la fel – aveau o fereastră de atenție limitată, dincolo de care informația se evapora.
Cu un context de 1 milion de tokeni, DeepSeek-V4.1-Flash poate procesa simultan echivalentul a trei volume din „Război și Pace” – sau, mai practic, poate analiza un codebase întreg, o documentație tehnică masivă sau o conversație care a durat zile întregi, fără să piardă firul. Asta înseamnă că poți avea conversații cu modelul care se întind pe perioade lungi, iar el își va aminti perfect ce ai spus la început, la mijloc și la final. Pentru dezvoltatori, asta e o schimbare uriașă – înseamnă că poți arunca un proiect software întreg în context și să ceri analize, refactorizări sau debugging fără să mai faci compromisuri.
FP4 KV Cache: eficiența dusă la extrem
Acum, partea tehnică pe care o să o explic fără să te plictisesc. Cache-ul KV (Key-Value) este memoria de lucru a unui model de limbaj. Când procesezi text, modelul stochează chei și valori pentru fiecare token ca să poată face referințe încrucișate. Problema? Memoria asta mănâncă resurse de parcă n-ar fi mâine. Aici intervine FP4 – o formatare pe 4 biți care reduce drastic amprenta de memorie.
Ca să-ți dai seama cât de important e asta, gândește-te la un bibliotecar care trebuie să rețină fiecare carte dintr-o bibliotecă întreagă. Dacă ar folosi un caiet gros pentru fiecare carte, ar rămâne fără spațiu în cinci minute. Dacă ar folosi un card index compact, ar putea gestiona mii de cărți. FP4 e exact asta – cardul index compact care le permite modelelor să proceseze mult mai mult context fără să ceară hardware de milioane de euro. Asta democratizează accesul la AI de ultimă generație, pentru că nu mai ai nevoie de un cluster de GPU-uri cât un apartament ca să rulezi un model performant.
Cross-Layer Attention Reuse: inteligența care nu aruncă nimic la gunoi
Și acum, partea cu adevărat fascinantă. Cross-Layer Attention Reuse – reutilizarea atenției între straturi. În arhitecturile tradiționale, fiecare strat al rețelei neuronale își calculează propria atenție, ignorând complet ce au făcut straturile anterioare. E ca și cum ai avea o echipă de cercetători unde fiecare începe de la zero, fără să se uite la concluziile colegului de dinainte. Ineficient, nu?
DeepSeek a schimbat asta. Modelul reutilizează calculele de atenție dintr-un strat în altul, eliminând munca redundantă. Asta nu doar că accelerează procesarea, dar reduce și cerințele de calcul, ceea ce se traduce în costuri mai mici și timpi de răspuns mai rapizi. E o abordare care arată o maturitate inginerească rar întâlnită – în loc să arunce hardware la problemă, au optimizat software-ul ca să facă mai mult cu mai puțin.
Ce înseamnă asta pentru tine, pentru mine, pentru industrie
Hai să coborâm din turnul de fildeș al teoriei și să vorbim despre impactul practic. Pentru dezvoltatori, V4.1-Flash înseamnă că pot construi aplicații care procesează documente masive, pot crea agenți AI care țin minte tot contextul unei conversații de afaceri care a durat săptămâni, pot analiza baze de cod întregi în timp real. Pentru cercetători, înseamnă că pot procesa literatură științifică vastă fără să piardă conexiuni importante între idei. Pentru business-uri, înseamnă că pot implementa soluții AI care înțeleg cu adevărat istoricul companiei, nu doar ultimele cinci mesaje.
Și aici vine partea interesantă. DeepSeek nu e doar un alt model open-source. E un model care demonstrează că inovația nu vine doar din bugete uriașe și echipe de mii de oameni. Vine din gândire originală, din curajul de a contesta arhitecturile consacrate și din focusul pe eficiență în loc de dimensiune pură. În timp ce alții se întrec în numărul de parametri, DeepSeek a ales să se întreacă în inteligență arhitecturală.
Desigur, nu totul e roz. Un context de 1 milion de tokeni vine cu provocări – latență potențial mai mare, nevoia de a gestiona cu atenție memoria, și întrebarea legitimă dacă modelele chiar folosesc eficient tot acel context sau doar îl ignoră. Dar asta e frumusețea momentului în care trăim – fiecare lansare aduce noi întrebări, noi provocări, noi oportunități de a învăța.
DeepSeek-V4.1-Flash nu e doar un model. E o declarație de intenție. E un semnal că AI-ul open-source nu doar că ține pasul cu giganții comerciali, dar îi și depășește în anumite aspecte cheie. Și asta, dragii mei, e o veste excelentă pentru toți cei care cred că viitorul tehnologiei ar trebui să fie deschis, accesibil și construit pe inteligență, nu pe bani.
De ce este important:
Această lansare nu e doar o actualizare incrementală într-un peisaj deja aglomerat. E un moment de cotitură care demonstrează că eficiența arhitecturală poate înlocui puterea brută de calcul. DeepSeek-V4.1-Flash reușește să aducă performanțe de top într-un pachet accesibil, deschizând uși pentru dezvoltatori independenți, startup-uri și cercetători care nu au bugetele giganților tech. Într-o industrie obsedată de dimensiune, DeepSeek ne amintește că adevărata inteligență stă în design, nu în volum. Pentru oricine lucrează cu AI, asta nu e doar o știre – e un semnal că regulile jocului tocmai s-au schimbat.