Contextul: Criza Evaluării în Era Multimodală
Până recent, evaluarea unui model de parsare a documentului era un haos. Unii dezvoltatori foloseau F1-score pe text extras, alții mAP (mean Average Precision) pe detectarea tabelelor, iar alții încă „vibe checks” vizuale pe câteva PDF-uri grele. Problema majoră? Lipsa unui ground truth unificat și a unui set de date diversificat care să reflecte realitatea haotică a documentelor enterprise.
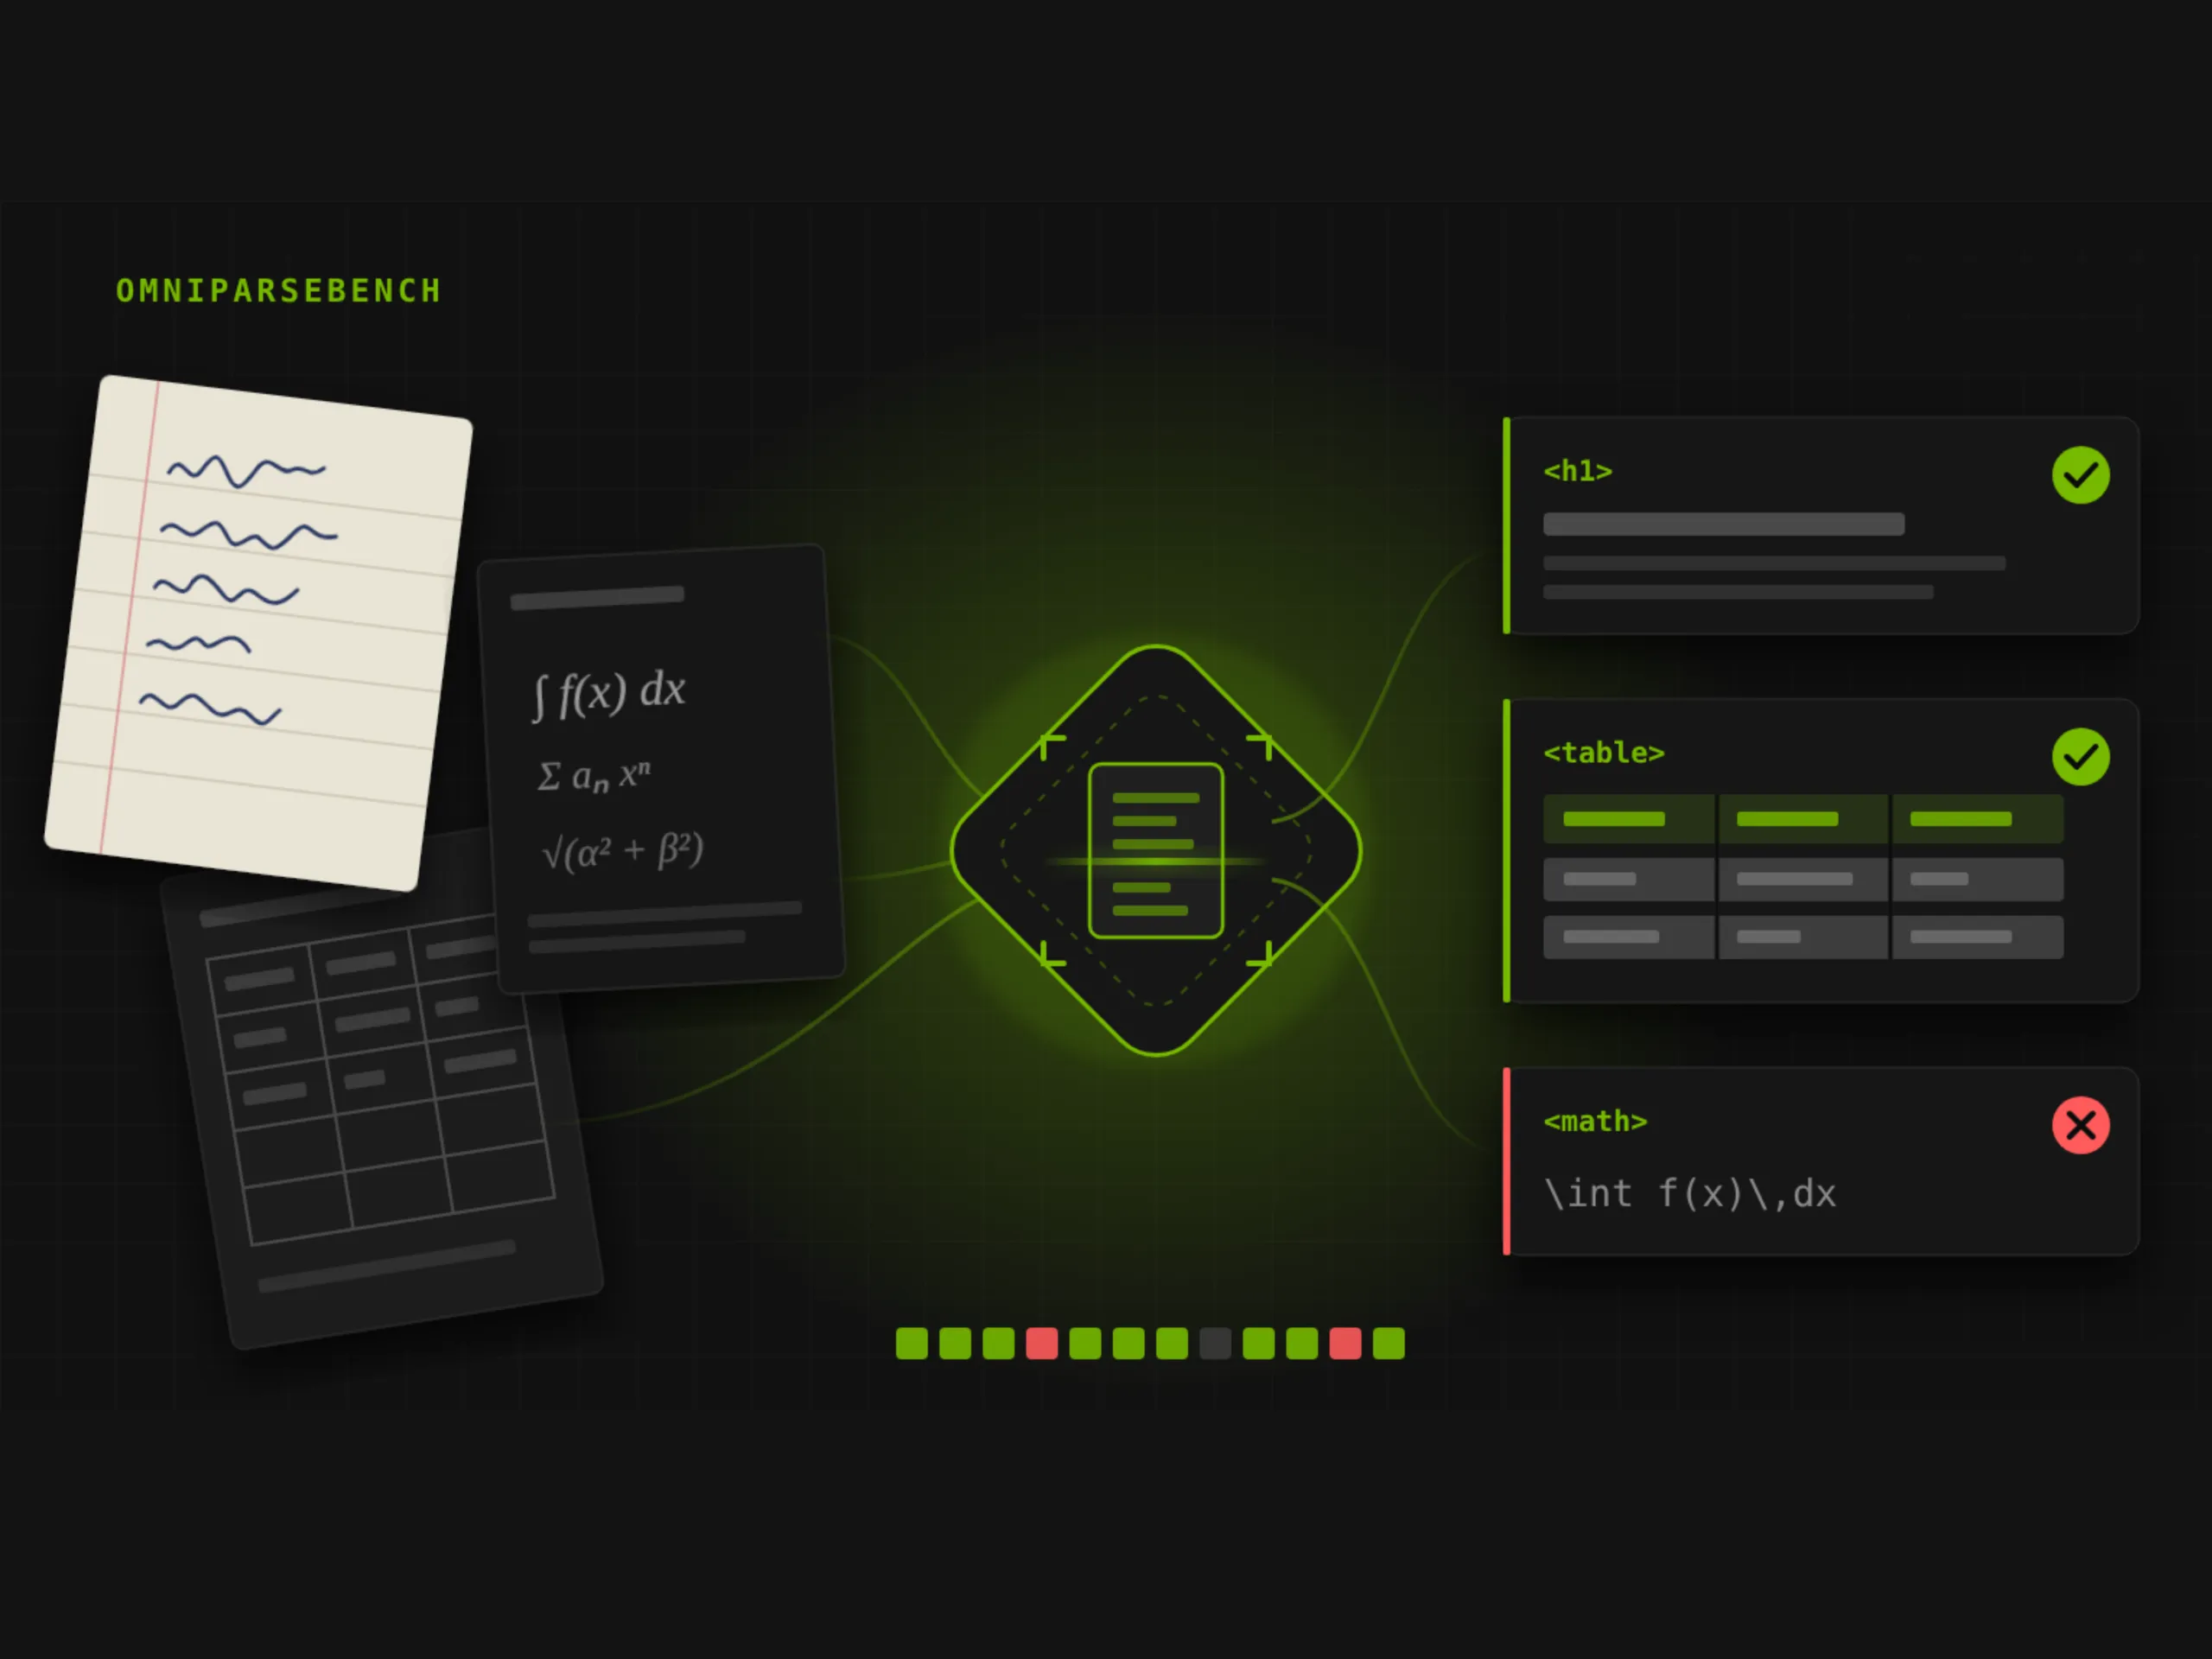
OmniParseBench nu este doar un alt dataset academic. Este o încercare conștientă de a crea un "ImageNet moment" pentru parsarea documentelor. Cuprinde o gamă largă de tipuri de documente: de la facturi scanate cu zgomot de fundal și semnături manuscrise, la contracte juridice complexe cu tabele imbricate și formulare administrative cu câmpuri completate greșit. Pentru noi, dezvoltatorii, acest lucru se traduce într-un singur lucru: comparabilitate. Dacă Modelul A are 92% pe OmniParseBench, iar Modelul B 89%, avem o bază de discuție reală, nu doar marketing.
Anatomia Leaderboard-ului: Ce Măsurăm De Fapt?
Leaderboard-ul public OmniParseBench este structurat pe trei piloni fundamentali, fiecare expunând o slabitudine specifică a modelelor actuale:
#### 1. Text Extraction Fidelity (Fidelitatea Extrăgerii Textului)
Aici nu numără doar caracterele corecte. Metrica penalizează sever ordinea de citire (reading order) – esențială pentru coloane multiple –, menținerea structurii paragrafelor și, crucial, reconstituirea tabelelor în format Markdown sau HTML valid. Am observat că modelele open-source (precum diverse fine-tunes ale Nougat sau Donut) căzu dramatic pe tabelele cu celule unite (merged cells) sau headere pe mai multe rânduri. Modelele proprietare (GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro) domină acest segment, dar costul la token/page rămâne o barieră pentru procesarea la scară largă.
#### 2. Layout Analysis & Element Detection (Analiza Layout-ului)
Acesta este locul unde OCR-ul clasic (Tesseract, PaddleOCR) eșuează complet. OmniParseBench evaluează capacitatea modelului de a clasifica corect zonele: Title, Text, Table, Figure, List, Header, Footer, Footnote. Scorul mAP@0.5:0.95 aici separă modelele care "văd" documentul de cele care doar "citesc" textul. O surpriză plăcută: modelele mici, specializate (sub 1B parametri), antrenate exclusiv pe DocLayout-YOLO sau similar, bat adesea modelele LLM mari pe detectarea elementelor, dar eșuează la OCR-ul propriu-zis din interiorul acelor elemente.
#### 3. Key Information Extraction (KIE) & Structured Output
Ultimul test, și cel mai relevant pentru business, este extragerea câmpurilor cheie (invoice number, total amount, date, line items) și returnarea lor ca JSON valid conform unui schema predefinit. Aici intervine conceptul de "hallucination control". Un model poate citi perfect textul, dar să inventeze un total sau să rateze o linie de factură. Leaderboard-ul penalizează field-level F1 și schema compliance.
Deep Dive: Testarea OCR Reală – Dincolo de Benchmark
Am decis să luăm top 3 modele de pe leaderboard (la momentul scrierii: GPT-4o, Gemini 1.5 Flash, și un model open-source de top, de exemplu InternVL2-8B sau similar) și să le punem la încercare pe un set de date propriu, "curat" de benchmark: facturi românești scanate la 150 DPI, cu ștampile, semnături și fundaluri colorate.
#### Provocarea Limbei Române și Diacritice
Majoritatea modelelor SOTA (State of the Art) sunt antrenate predominant pe engleză, chineză și limbi europene majore. Româna, cu diacriticele sale (ă, â, î, ș, ț), este adesea un "edge case".
#### Problema Tabelelor Nestate și a Coloanelor Ascunse
Benchmark-ul are tabele curate. Realitatea are tabele unde o coloană "Descriere" conține text pe 3 rânduri, iar coloana "Cantitate" are o valoare implicită (1) care nu este scrisă.
Rezultat: Toate modelele halucină structura tabelei la un moment dat. Soluția noastră în producție? Nu ne bazăm pe JSON-ul modelului direct. Folosim modelul pentru a extrage celulele* (coordonate + text), apoi aplicăm o euristică regulată (rule-based) pentru a reconstrui logica tabelei (totaluri, subtotaluri, TVA). Aceasta este singura cale robustă.
#### Latentă și Cost: Realitatea Producției
Pe leaderboard, latenta nu contează. În producție, procesarea a 10.000 de facturi/noapte:
Arhitectura Ideală: Pipeline-ul Hibrid
După luni de bătălii cu benchmark-uri și producție, concluzia mea este că nu există "One Model to Rule Them All". Arhitectura câștigătoare pentru un dezvoltator senior azi arată așa:
1. Router Inteligent: Un model mic (ex. layoutlmv3 sau un YOLO) clasifica documentul: Factură simplă / Contract complex / Scan calitate scăzută / Born digital PDF.
2. Extracție Paralelă:
Born digital PDF* -> `pdfplumber` / `pymupdf` (text nativ, zero cost, 100% acuratețe).
Scanuri curate* -> Model rapid/ieftin (Gemini Flash / GPT-4o-mini / Self-hosted Qwen2-VL).
Scanuri grele / Manuscrise / Tabele complexe* -> Model puternic (GPT-4o / Claude 3.5 Sonnet) sau Human-in-the-loop.
3. Validare & Normalizare: Un strat Pydantic/Zod care impune schema, calculează totaluri (verifică `sum(line_items) == total`), validează CUI/IBAN regex.
4. Feedback Loop: Erorile validate de operatori (sau regulile de business eșuate) merg automat într-un dataset de fine-tuning pentru modelul self-hosted.
De ce este important:
OmniParseBench este un pas uriaș în direcția standardizării, dar un benchmark este o hartă, nu teritoriul. Pentru dezvoltatori, valoarea reală nu sta în a alege modelul #1 de pe leaderboard, ci în a înțelege de ce modelele eșuează pe anumite slice-uri de date (diacritice, tabele implicite, zgomot specific) și a construi sisteme reziliente care combină OCR clasic, VLMs (Vision-Language Models) și logică deterministă. Viitorul nu este "mai mare model", ci "pipeline mai inteligent". Dacă construiști RAG pe documente enterprise azi, ignoră hype-ul leaderboard-ului și investește în evals proprii pe datele tale reale – acolo se ascund banii și riscurile.