
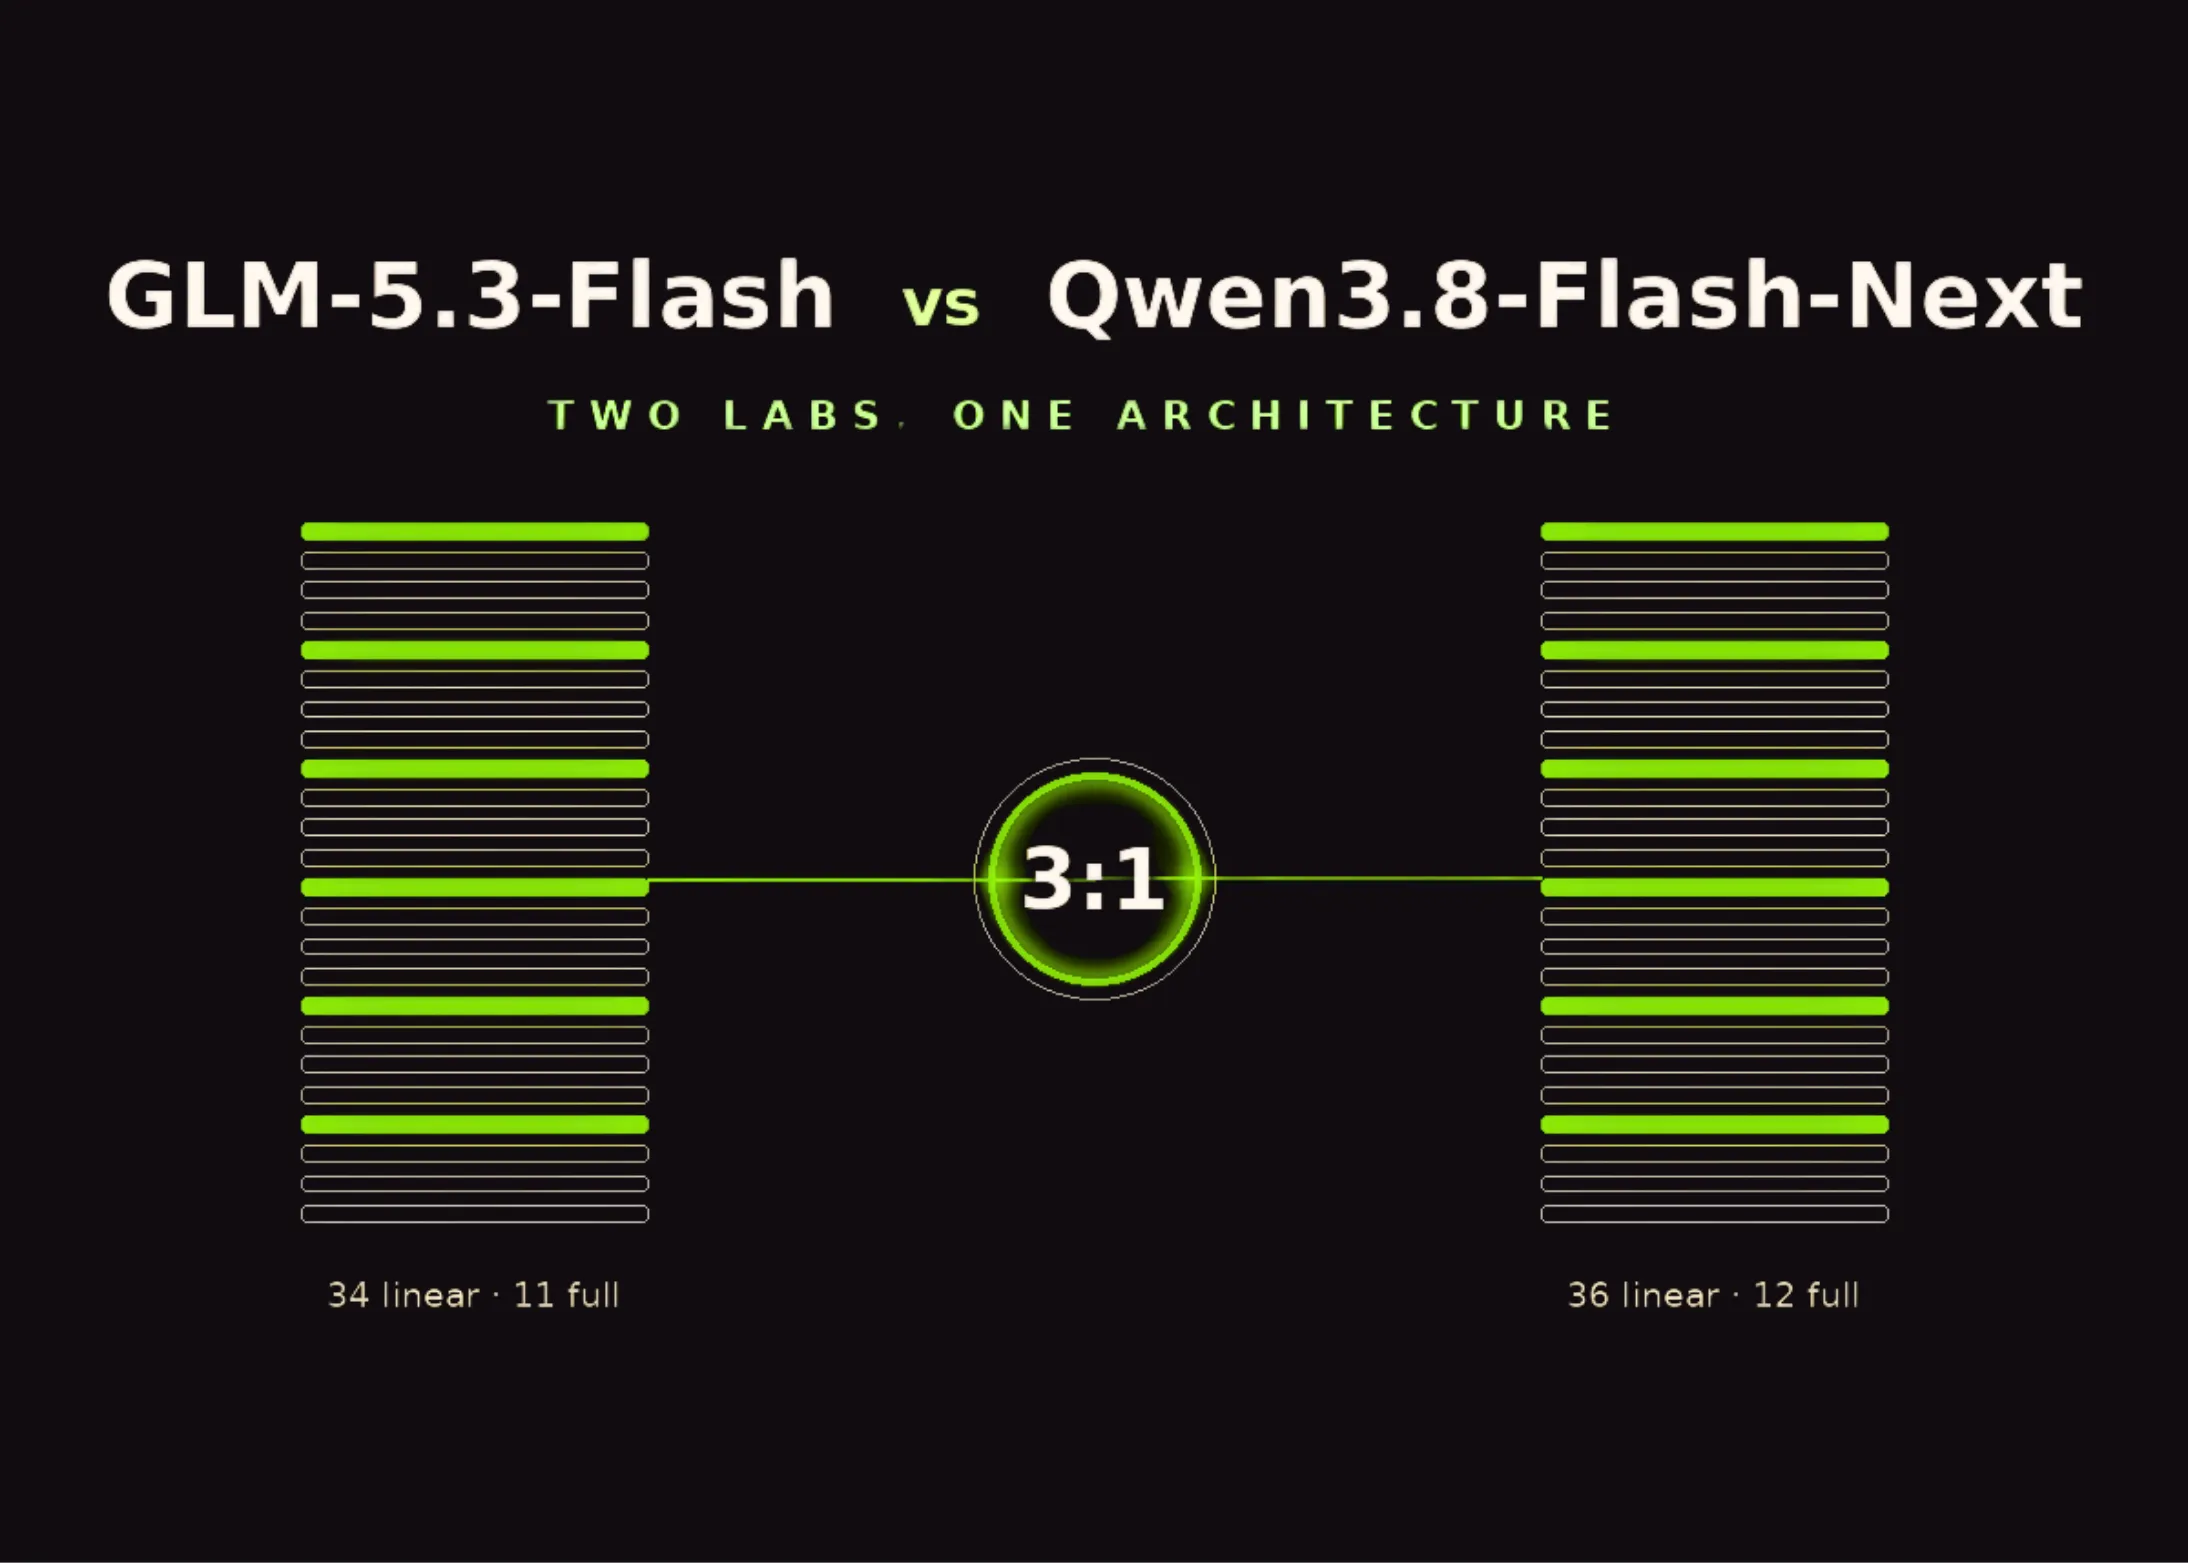
Această convergență nu este doar o simplă coincidență, ci un semnal puternic despre direcția în care se îndreaptă întreaga industrie a AI. Ambele modele au fost proiectate pentru a fi rapide, eficiente și capabile să ruleze pe hardware accesibil, ceea ce le face ideale pentru aplicații în timp real, asistenți virtuali, chatbot-uri și alte soluții care necesită răspunsuri imediate. Dar ce înseamnă, de fapt, această similitudine structurală? Și de ce este importantă pentru viitorul tehnologiei?
Ce sunt GLM-5.3-Flash și Qwen3.8-Flash-Next?
GLM-5.3-Flash este cel mai recent model din seria GLM (General Language Model) dezvoltat de Zhipu AI, unul dintre pionierii AI din China. Modelul este conceput pentru a oferi performanțe ridicate la un cost redus, fiind optimizat pentru inferență rapidă și utilizare pe dispozitive cu resurse limitate. Pe de altă parte, Qwen3.8-Flash-Next vine de la Alibaba, prin divizia sa de cloud și AI, și face parte din familia Qwen, cunoscută pentru versatilitatea și capacitatea de a gestiona sarcini complexe de procesare a limbajului natural.
Ambele modele împărtășesc o arhitectură bazată pe transformatori cu atenție sparse, o tehnică care reduce semnificativ numărul de calcule necesare, păstrând în același timp o acuratețe impresionantă. Această abordare permite modelelor să proceseze texte lungi și să răspundă rapid, fără a necesita servere masive sau GPU-uri de ultimă generație. Este o mișcare strategică, având în vedere că piața cere din ce în ce mai mult soluții de AI care pot fi integrate în produse comerciale fără costuri exorbitante.
De ce au convergit către aceeași arhitectură?
În spatele acestei convergențe se află o combinație de factori tehnici și economici. În primul rând, cercetătorii din ambele echipe au identificat aceleași constrângeri: nevoia de a reduce latența, de a îmbunătăți eficiența energetică și de a face modelele accesibile unui public larg. În al doilea rând, există o presiune competitivă imensă pe piața chineză de AI, unde companiile se luptă să lanseze cele mai bune modele la prețuri cât mai mici. Această presiune a dus la inovații care, în mod natural, au ajuns la soluții similare.
Un alt factor important este schimbul de idei și publicațiile științifice. Deși laboratoarele lucrează independent, ele urmăresc îndeaproape cercetările celorlalți. Lucrările despre atenția sparse, cuantizarea și distilarea modelelor au devenit standarde în industrie, iar ambele echipe au aplicat aceste tehnici în moduri care, în final, au dus la arhitecturi aproape identice. Este un exemplu clar de evoluție convergentă, similar cu modul în care animalele din medii diferite dezvoltă trăsături asemănătoare pentru a supraviețui.
Implicații pentru piața AI
Această convergență are mai multe implicații importante. În primul rând, confirmă faptul că arhitectura bazată pe atenție sparse este una dintre cele mai eficiente soluții pentru modelele de dimensiuni medii. Acest lucru ar putea determina și alte companii să adopte aceeași abordare, accelerând astfel standardizarea în industrie. În al doilea rând, demonstrează că barierele tehnice pentru a construi modele competitive sunt din ce în ce mai mici. Dacă două laboratoare diferite ajung la aceeași soluție, înseamnă că know-how-ul este deja răspândit, iar inovația se mută către alte aspecte, cum ar fi datele de antrenament sau integrarea cu aplicații specifice.
Pentru dezvoltatori și companii, aceasta este o veste excelentă. Au acum la dispoziție două modele puternice, cu performanțe similare, care pot fi folosite ca alternativă unul pentru celălalt. Acest lucru reduce dependența de un singur furnizor și oferă mai multă flexibilitate în alegerea soluției potrivite. De asemenea, prețurile ar putea scădea, deoarece competiția devine mai acerbă, iar ambele companii vor încerca să atragă cât mai mulți clienți.
Ce urmează?
Este de așteptat ca această tendință să continue. Pe măsură ce cercetarea avansează, vom vedea probabil și alte convergențe în arhitecturi, mai ales în domenii precum modelele multimodale sau cele specializate pe sarcini specifice. De asemenea, este posibil ca aceste două laboratoare să colaboreze în viitor, având în vedere că au interese comune în promovarea AI-ului open-source și în stabilirea unor standarde globale.
În concluzie, GLM-5.3-Flash și Qwen3.8-Flash-Next nu sunt doar două modele noi, ci un semnal că industria AI intră într-o fază de maturitate, în care eficiența și accesibilitatea devin la fel de importante ca performanța brută. Convergența lor arată că, atunci când vine vorba de tehnologie, uneori cele mai bune soluții sunt cele care reușesc să îmbine ingeniozitatea cu pragmatismul. Rămâne de văzut cum vor evolua aceste modele și ce alte surprize ne rezervă viitorul.
De ce este important:
Această convergență arhitecturală între două laboratoare independente subliniază o tendință majoră în dezvoltarea AI: optimizarea pentru eficiență și accesibilitate devine prioritară. Pentru companii și dezvoltatori, înseamnă mai multe opțiuni, costuri reduse și o piață mai competitivă. Pentru cercetători, confirmă faptul că anumite tehnici sunt fundamentale și că inovația se mută către alte domenii. În plus, demonstrează că China rămâne un lider în AI, iar modelele sale pot rivaliza cu cele occidentale, oferind alternative viabile la nivel global.