Subiect: #arhitectură AI
Un cercetător de la Princeton propune Transformer-ul Recurent în Buclă (RLT) care transportă starea decodorului la fiecare token, fixând 96 de blocuri per token cu adâncime temporală nelimitată
Un cercetător de la Princeton propune Recurrent Looped Transformer (RLT), o arhitectură care transportă starea decodorului la fiecare token, permițând o adâncime temporală nelimitată. Cu 96 de blocuri per token și fără resetare la granițele de servire, RLT ar putea rezolva problema memoriei pe termen lung în modelele lingvistice, deși nu are încă rezultate empirice.
AI
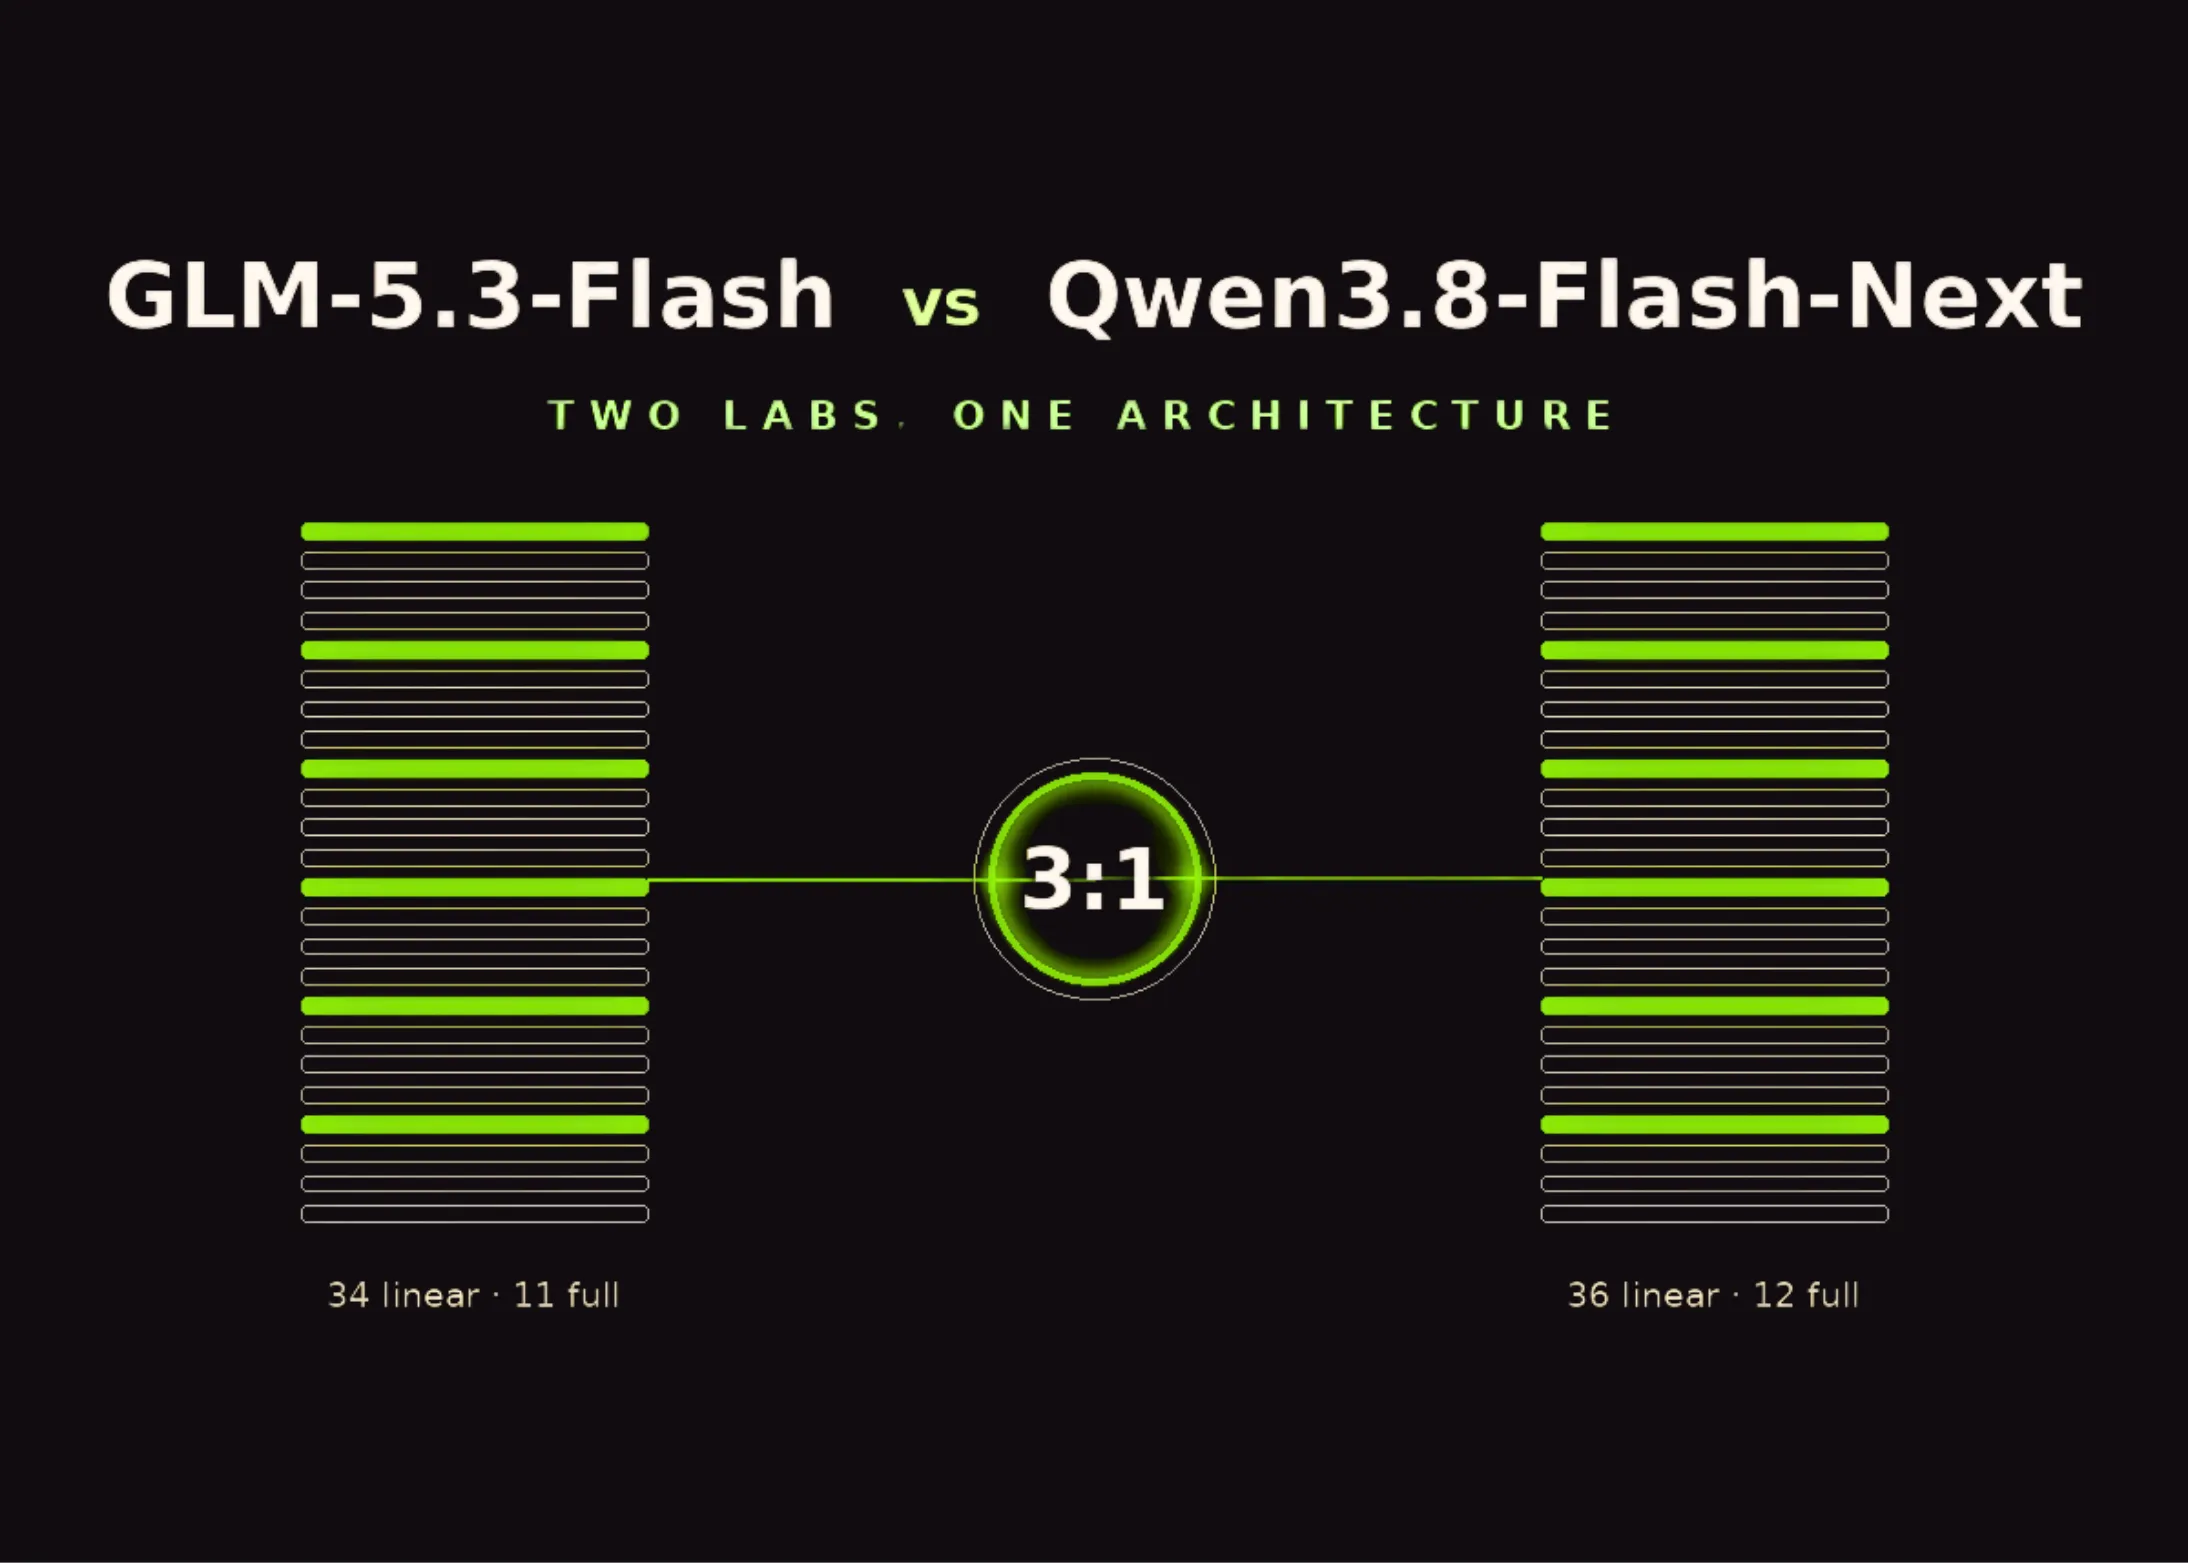
GLM-5.3-Flash vs Qwen3.8-Flash-Next: Două laboratoare chineze de AI converg independent către aceeași arhitectură
GLM-5.3-Flash de la Zhipu AI și Qwen3.8-Flash-Next de la Alibaba au ajuns independent la aceeași arhitectură, semnalând o tendință majoră în eficientizarea modelelor de AI. Descoperă ce înseamnă această convergență pentru piață și viitorul tehnologiei.