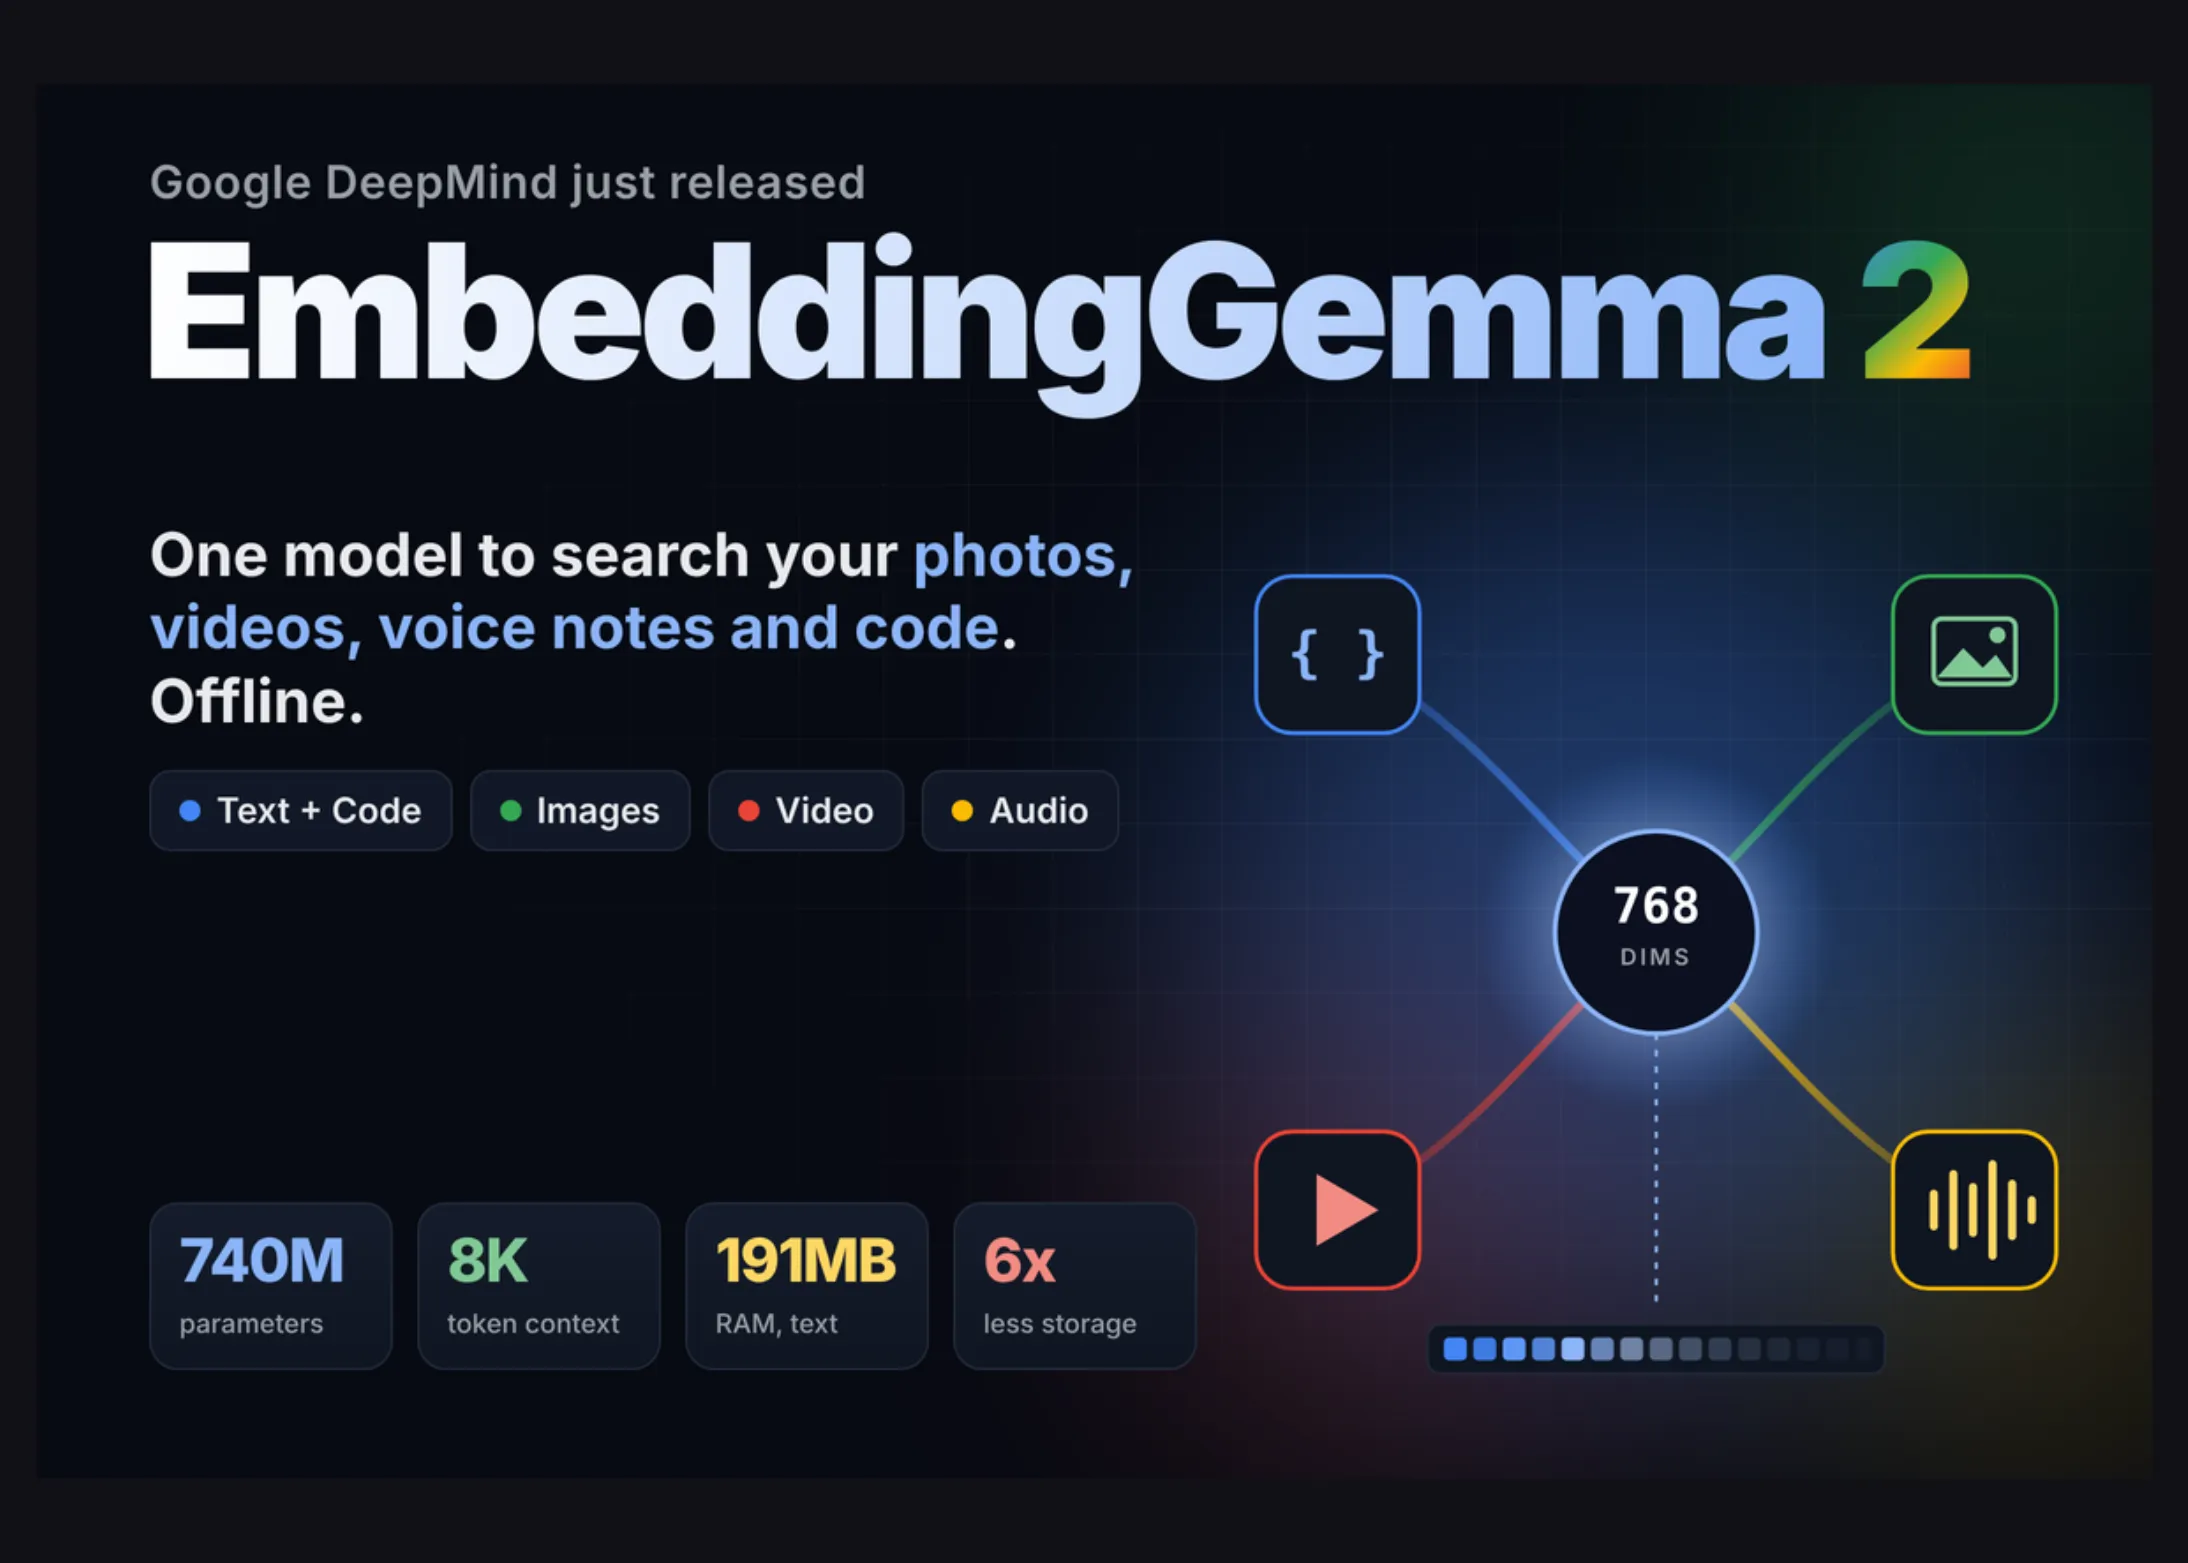
Hai să lămurim mai întâi ce înseamnă, de fapt, un model de embedding. Pe scurt, un astfel de model transformă textul, imaginile sau alte tipuri de date în vectori numerici — niște liste lungi de numere — care capturează sensul semantic al conținutului respectiv. De ce contează asta? Pentru că aceste reprezentări vectoriale stau la baza căutării semantice, a sistemelor de recomandare, a clasificării automate, a detectării duplicatelor și a tot felul de aplicații RAG (Retrieval-Augmented Generation) care au devenit coloana vertebrală a asistenților AI moderni. Fără embedding-uri bune, un chatbot inteligent devine brusc un papagal bine citit, dar incapabil să găsească informația relevantă.
Ce aduce nou EmbeddingGemma 2 față de predecesorul său? În primul rând, multimodalitatea reală. Nu vorbim doar despre text, ci despre capacitatea de a înțelege și imagini, aliniindu-le în același spațiu vectorial. Asta înseamnă că poți căuta o poză folosind o descriere textuală, sau invers — poți găsi textul relevant pornind de la o imagine. Pentru dezvoltatorii care construiesc aplicații de comerț electronic, platforme de conținut sau sisteme de arhivare, această funcționalitate este aur curat.
Al doilea aspect important ține de arhitectura Gemma 4 pe care se bazează. Gemma a fost întotdeauna familia de modele deschise a Google, gândită ca o alternativă accesibilă la giganții proprietari precum GPT sau Claude. Faptul că EmbeddingGemma 2 este construit peste cea mai recentă iterație a acestei familii sugerează că Google DeepMind a învățat lecțiile din versiunile anterioare și a optimizat modelul atât pentru performanță, cât și pentru eficiență computațională.
Și aici ajungem la partea cu adevărat interesantă: dimensiunea. 740 de milioane de parametri este un număr care poate părea mare pentru publicul general, dar în lumea embedding-urilor este aproape elegant. Modelele de embedding tradiționale, precum cele din familia BERT sau variantele mai vechi ale Sentence Transformers, se învârt în jurul a 100-300 de milioane de parametri. Modelele multimodale de embedding, însă, au tendința să explodeze spre miliarde. Faptul că EmbeddingGemma 2 reușește să rămână sub un miliard în timp ce procesează atât text, cât și imagini este o dovadă clară de inginerie rafinată.
De ce contează compactitatea? Din motive foarte practice. Un model de 740 de milioane de parametri poate rula pe hardware mult mai modest decât unul de 7 miliarde sau 70 de miliarde. Vorbim despre GPU-uri de consum, despre edge devices, despre servere fără ferme întregi de A100-uri. Pentru startup-urile care nu au bugete de milioane de dolari pentru infrastructură, pentru cercetătorii academici care lucrează cu resurse limitate, pentru dezvoltatorii independenți care vor să experimenteze — acest model este o gură de oxigen.
Desigur, nu totul este perfect. Trebuie să fim onești: un model de 740 de milioane de parametri nu va bate niciodată, pe toate benchmark-urile, un monstru de 70 de miliarde de parametri antrenat pe cantități astronomice de date. Există un compromis fundamental între dimensiune și capacitate. Întrebarea reală este dacă EmbeddingGemma 2 oferă un raport calitate-preț-care să justifice alegerea sa în detrimentul unor alternative mai mari. Și, judecând după direcția în care merge industria — spre modele mici, specializate, eficiente — răspunsul pare să fie un "da" hotărât.
Un alt aspect pe care merită să-l subliniem este caracterul open. Google DeepMind nu doar că lansează modelul, ci îl face disponibil comunității. Asta înseamnă că oricine poate să-l descarce, să-l inspecteze, să-l modifice și să-l folosească în propriile proiecte. Într-o lume în care cei mai puternici jucători AI păstrează totul în spatele unor API-uri scumpe și opace, această deschidere este nu doar lăudabilă, ci strategică. Google știe că ecosistemele open-source câștigă bătălia pe termen lung, iar EmbeddingGemma 2 este o investiție în acest ecosistem.
Să vorbim puțin și despre aplicațiile concrete. Gândiți-vă la un motor de căutare intern pentru o companie mare, cu mii de documente, prezentări, PDF-uri și imagini. Cu EmbeddingGemma 2, poți construi un sistem care înțelege întrebări în limbaj natural și returnează rezultate relevante din toate aceste surse, indiferent de format. Sau imaginați-vă o platformă de moderare a conținutului care detectează automat imagini similare sau textuale care încalcă regulile comunității. Sau un asistent personal care îți organizează biblioteca de fotografii după criterii semantice, nu doar după data sau locația GPS.
Pentru comunitatea RAG, vestea este și mai bună. Sistemele RAG depind critic de calitatea embedding-urilor pentru a recupera informația corectă din baze de cunoștințe vaste. Un model multimodal înseamnă că poți construi un asistent care răspunde la întrebări pe baza unui manual tehnic plin de diagrame și scheme, nu doar de text. Asta deschide uși către domenii precum ingineria, medicina, dreptul sau educația, unde informația vizuală este esențială.
Desigur, adoptarea nu va fi instantanee. Dezvoltatorii vor avea nevoie de timp să testeze modelul, să-l compare cu alternativele existente și să-l integreze în pipeline-urile lor. Vor exista provocări legate de fine-tuning, de optimizarea inferenței, de gestionarea memoriei. Dar acestea sunt provocări normale pentru orice tehnologie nouă și, cel mai important, sunt provocări pe care comunitatea open-source le va rezolva împreună, prin contribuții colective.
Un lucru este cert: EmbeddingGemma 2 nu este doar un alt model lansat într-o piață saturată. Este un semnal că Google DeepMind continuă să investească serios în AI-ul deschis și accesibil. Este o dovadă că multimodalitatea nu mai este un lux rezervat giganților, ci o funcționalitate care poate ajunge pe laptopul oricărui dezvoltator pasionat. Și, poate cel mai important, este o invitație deschisă către toți cei care vor să construiască următoarea generație de aplicații inteligente.
Rămâne de văzut cum va fi primit modelul de către comunitate în săptămânile și lunile următoare. Vor apărea benchmark-uri independente, comparații detaliate, tutoriale și integrări în framework-uri populare precum LangChain, LlamaIndex sau Haystack. Dacă istoria ne-a învățat ceva, este că modelele open-source bune tind să câștige tracțiune rapid atunci când rezolvă probleme reale pentru oameni reali. Iar EmbeddingGemma 2 pare să facă exact asta.
De ce este important:
EmbeddingGemma 2 marchează un moment semnificativ în democratizarea inteligenței artificiale multimodale. Prin lansarea unui model de embedding de doar 740 de milioane de parametri, capabil să proceseze atât text, cât și imagini, Google DeepMind demonstrează că performanța ridicată nu necesită neapărat resurse computaționale uriașe. Acest lucru are implicații profunde: startup-urile, cercetătorii independenți și dezvoltatorii cu bugete limitate pot acum să construiască aplicații sofisticate de căutare semantică, sisteme RAG multimodale și platforme de recomandare fără a depinde de API-uri scumpe sau de infrastructură de cloud costisitoare. Într-o industrie dominată tot mai mult de câțiva giganți, un astfel de model open-source reprezintă un contrapunct esențial, menținând ecosistemul AI competitiv, transparent și accesibil. Pe termen lung, succesul unor astfel de modele compacte și deschise ar putea redefini modul în care gândim despre scalare în AI — nu mereu mai mare înseamnă mai bun, iar EmbeddingGemma 2 este dovada vie că inteligența poate fi și eficientă, și accesibilă tuturor.