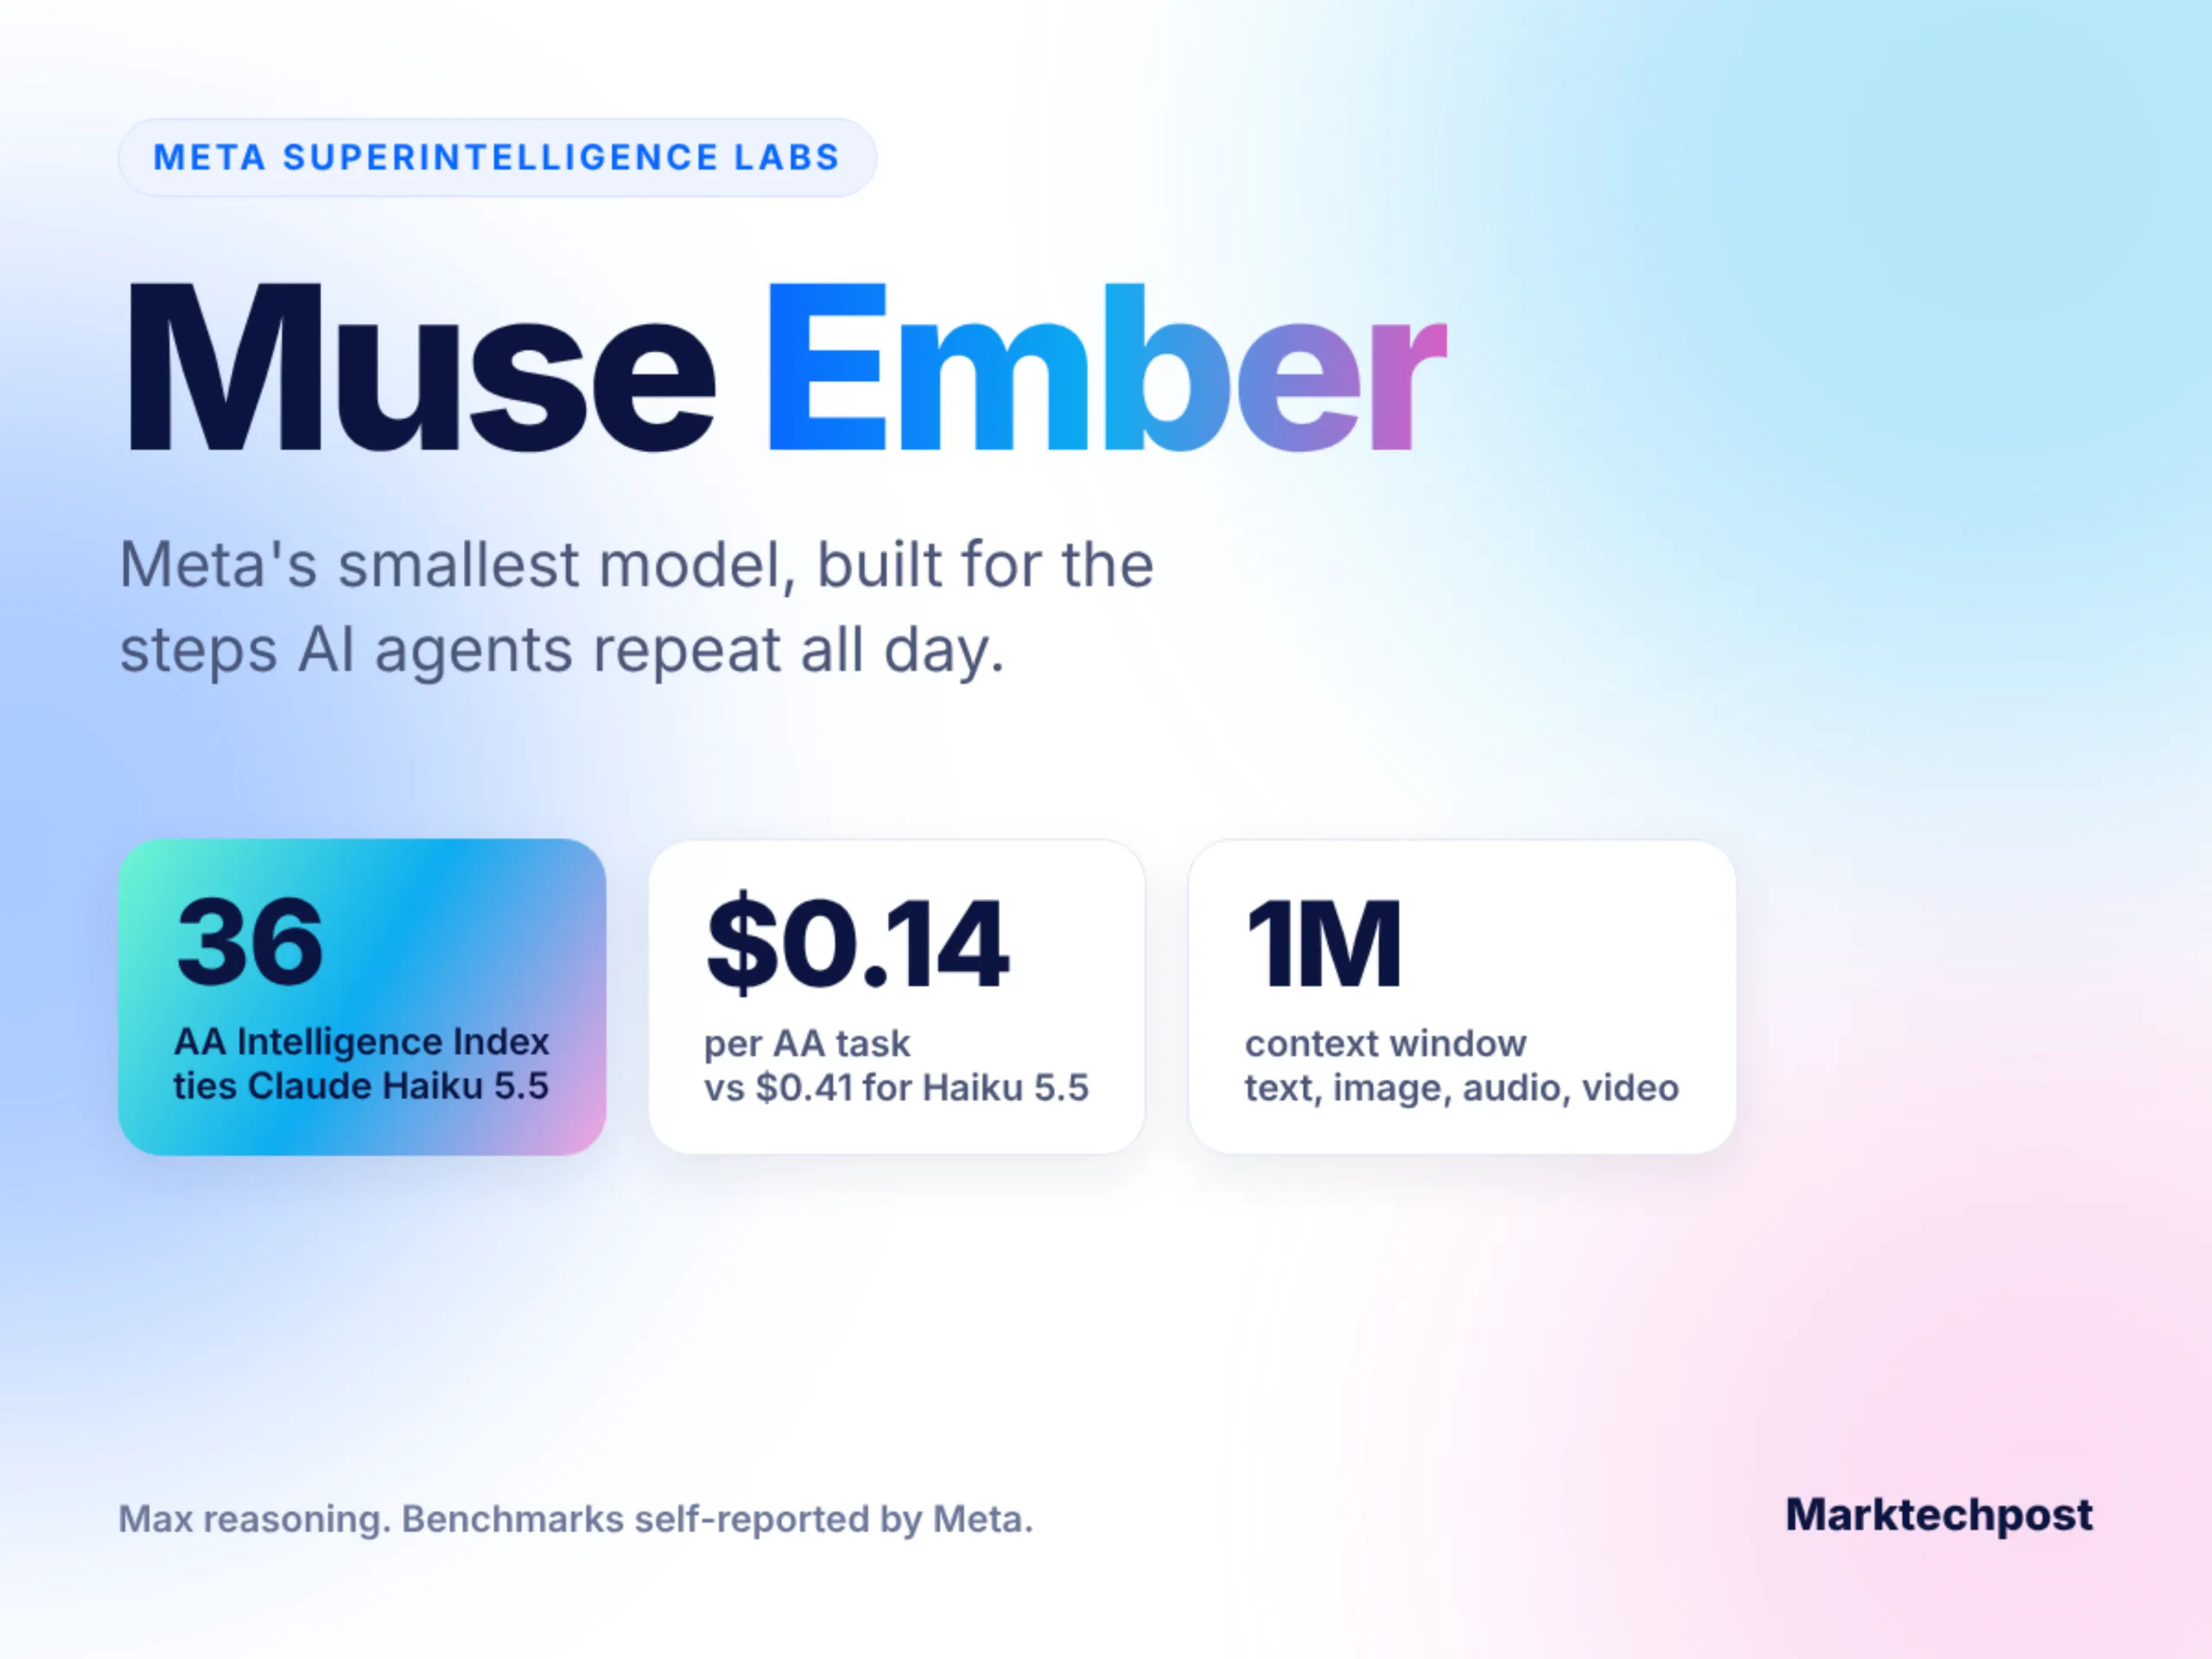
Pentru cei inițiați, numerele vorbesc de la sine. Un context de 1 milion de token-uri înseamnă, în termeni practici, capacitatea de a "citi" și procesa aproximativ 700.000 de cuvinte english într-o singură inferență — echivalentul a câteva romane de dimensiuni medii, sau, mai relevant pentru cazurile de utilizare vizate, istoricul complet al interacțiunilor unui agent pe parcursul săptămânilor sau chiar lunilor, împreună cu documentația tehnică extinsă, log-urile de execuție și bazele de cunoștințe corporative.asta nu este doar o îmbunătățire incrementală; este o schimare de paradigmmă.
"Am observat o problemă fundamentală în arhitectura agenților actuali", a declarat un cercetător senior de la FAIR (Fundamental AI Research) al Meta, în conversații private de la lanșare. "Agenții de astăzi sunt amneziaci. Fiecare sesiune nouă începe de la zero, sau, în cel mai bun caz, se bazează pe RAG (Retrieval-Augmented Generation) care introduce latență, costuri și, cel mai important, pierderi de context semantic. Muse Ember a fost construit pentru a elimina această amnezie."
Arhitectura modelului, deși Meta nu a publicat încă un paper tehnic detaliat (acesta este așteptat la o conferință majoră în toamnă), pare să combine mecanisme de atenție rară (sparse attention) cu o strategie ierarhică de compresie a contextului, permițând modelului să mențină o "memorie de lucru" activă pentru task-urile curente, arhivând informațiile mai vechi într-un format compresat semantic, dar recuperabil. Această abordare rezolvă una dintre cele mai mari provocări ale contextelor lungi: costul quadratic de calcul al atenției standard, care face inferența pe 1M token-uri prohibitiv de scumpă pentru majoritatea organizațiilor.
Implicațiile pentru enterprise sunt profunde. Imaginează-ți un agent de inginerie software care nu doar că scrie cod, dar își amintește de fiecare decizie arhitecturală luată în ultimele șase luni, de fiecare bug raportat și rezolvat, de fiecare conversație Slack relevantă — și poate raționa peste toate acestea pentru a propune o refactorizare coerentă. Sau un agent de analiză financiară care înghite rapoartele anuale complete ale a 50 de companii, transcripturile tuturor conferințelor de rezultate din ultimii cinci ani, și regulamentele SEC actualizate în timp real, producând memo-uri de investiție care reflectă o înțelegere profundă, longitudinală, nu doar un rezumat de ultimă oră.
Comunitatea open-source a reagit cu entuziasm amestecat cu scepticismul sănătos care caracterizează orice lansare majoră. Pe Discord-urile dedicate (în special serverul "LocalLLaMA" și canalul "Long-Context LLMs"), dezvoltatorii au început să testeze modelul pe hardware de consum — rezultatele preliminare indicând că, cu cuantizare 4-bit și offloading parțial pe CPU, Muse Ember rulează pe un MacBook Pro cu 96GB RAM unificat, deși viteza de inferență pentru contextul complet este, prevedibil, măsurată în token-uri pe minut, nu pe secundă. Pe GPU-uri de tip H100 sau A100 (80GB VRAM), performanța este semnificativ mai bună, dar costul rămâne o barieră pentru majoritatea echipelor mici.
"Nu ești nevoit să folosești contextul complet de 1M la fiecare apel", explică Andrei M., un inginer ML din București care a contribuit la evaluarea modelului. "Forța reală e că poți să-l folosești când e cazul. Pentru 90% din task-uri, 32K sau 128K e de ajuns. Dar acel 10% — debugging-ul unui sistem distribuit complex, analiza unui depozit legal masiv, planificarea unui proiect pe ani — acolo e valoarea. Și faptul că e open-weight înseamnă că putem experimenta fără să cerem permisiune corporatistă."
Comparativ cu ofertele proprietare — Gemini 1.5 Pro de la Google (de asemenea 1M context, dar accesibil doar prin API), sau modelele GPT-4o ale OpenAI (128K context) — Muse Ember se distinge prin transparența ponderilor și licența permisivă (o variantă a licenței Llama 3 Community License, adaptată pentru utilizare comercială largă). Aceasta înseamnă că organizațiile pot fine-tuna modelul pe datele lor proprietare, pot distila modele mai mici pentru deployment la edge, și, cel mai important, nu sunt legate de prețurile și politicile de utilizare ale unui furnizor cloud.
Totuși, provocările rămân semnificative. Evaluările inițiale sugerează că, deși performanța pe benchmark-uri standard (Needle-in-a-Haystack, RULER, LongBench) este competitivă, modelul prezintă anumite tendințe de "atenție selectivă" — ignorând informații critice plasate la anumite poziții în contextul masiv, un fenomen cunoscut sub numele de "lost in the middle" dar amplificat la scară de 1M. De asemenea, costul de stocare și transfer al KV-cache-ului pentru contexte lungi rămâne un guleră operativă majoră, deși Meta a inclus în release o implementare optimizată de FlashAttention-3 cu paging pe disc NVMe.
Din perspectivă strategică, lansarea Muse Ember semnifică pariul lui Meta pe viitorul "agentic" al AI — o viziune în care modelele nu sunt doar motoare de completare a textului, ci actori autonomi care acționează în lume (sau în sisteme software) pe orizonte de timp lungi. Aceasta se aliniază cu declarațiile recente ale lui Mark Zuckerberg despre "miliarde de agenți AI" și cu investițiile masive ale companiei în infrastructură de inferență (clusterul de 350.000 H100 anunțat pentru 2024). Open-sourcing-ul unui model optimizat pentru acest scenariu specific este, de multe ori, o mișcare de ecosistem: Meta creează standardul de facto pentru "cum arată un model bun pentru agenți", atrăgând dezvoltatorii să construiască pe stiva lor, ceea ce, la rândul lor, crește cererea pentru hardware-ul și serviciile cloud ale Meta.
Pentru ecosistemul românesc de AI — care a văzut o creștere exponențială a startup-urilor și a centrelor de R&D ale corporațiilor internaționale în ultimii ani — Muse Ember reprezintă o oportunitate concretă. Echipele mici, care nu au bugete pentru API-uri proprietare la scară, pot acum experimenta cu arhitecturi agentice complexe local sau pe cloud-uri europene (GDPR-compliant), fine-tunând modelul pentru limba română, pentru legislația locală, pentru particularitățile pieței noastre. Primele proiecte comunitare — un agent de asistență juridică pentru Codul Muncii și Codul Fiscal, un agent de optimizare a fondurilor europene pentru ONG-uri — sunt deja în discuție pe forumurile locale.
Rămâne de văzut cum va evolua landșapețul în următorii luni. Google, OpenAI, Anthropic, și noul jucător xAI nu vor sta cu brațele încrucișate. Curba de inovație în context lung și arhitecturi agentice este abia la început. Dar Muse Ember a mutat goalpost-ul — și a făcut-o într-un mod care pune puterea în mâinile dezvoltatorilor, nu a gardianilor de gardă corporativi. Și asta, poate, e cea mai importantă poveste din acest lansament.
De ce este important:
Muse Ember nu este doar un alt model mai mare. Este primul model open-weight gândit de la zero pentru realitatea operativă a agenților AI autonomi: nevoia de memorie pe termen foarte lung, raționament peste istorici masive de interacțiuni, și deployabilitate fără dependență de furnizori cloud proprietați. Pentru România și Europa, unde suveranitatea datelor și costurile de inferență sunt barieri majore, acest lansament democratizează accesul la arhitecturi agentice de clasă mondială — permițând inovație locală, compliantă și sustenabilă financiar.