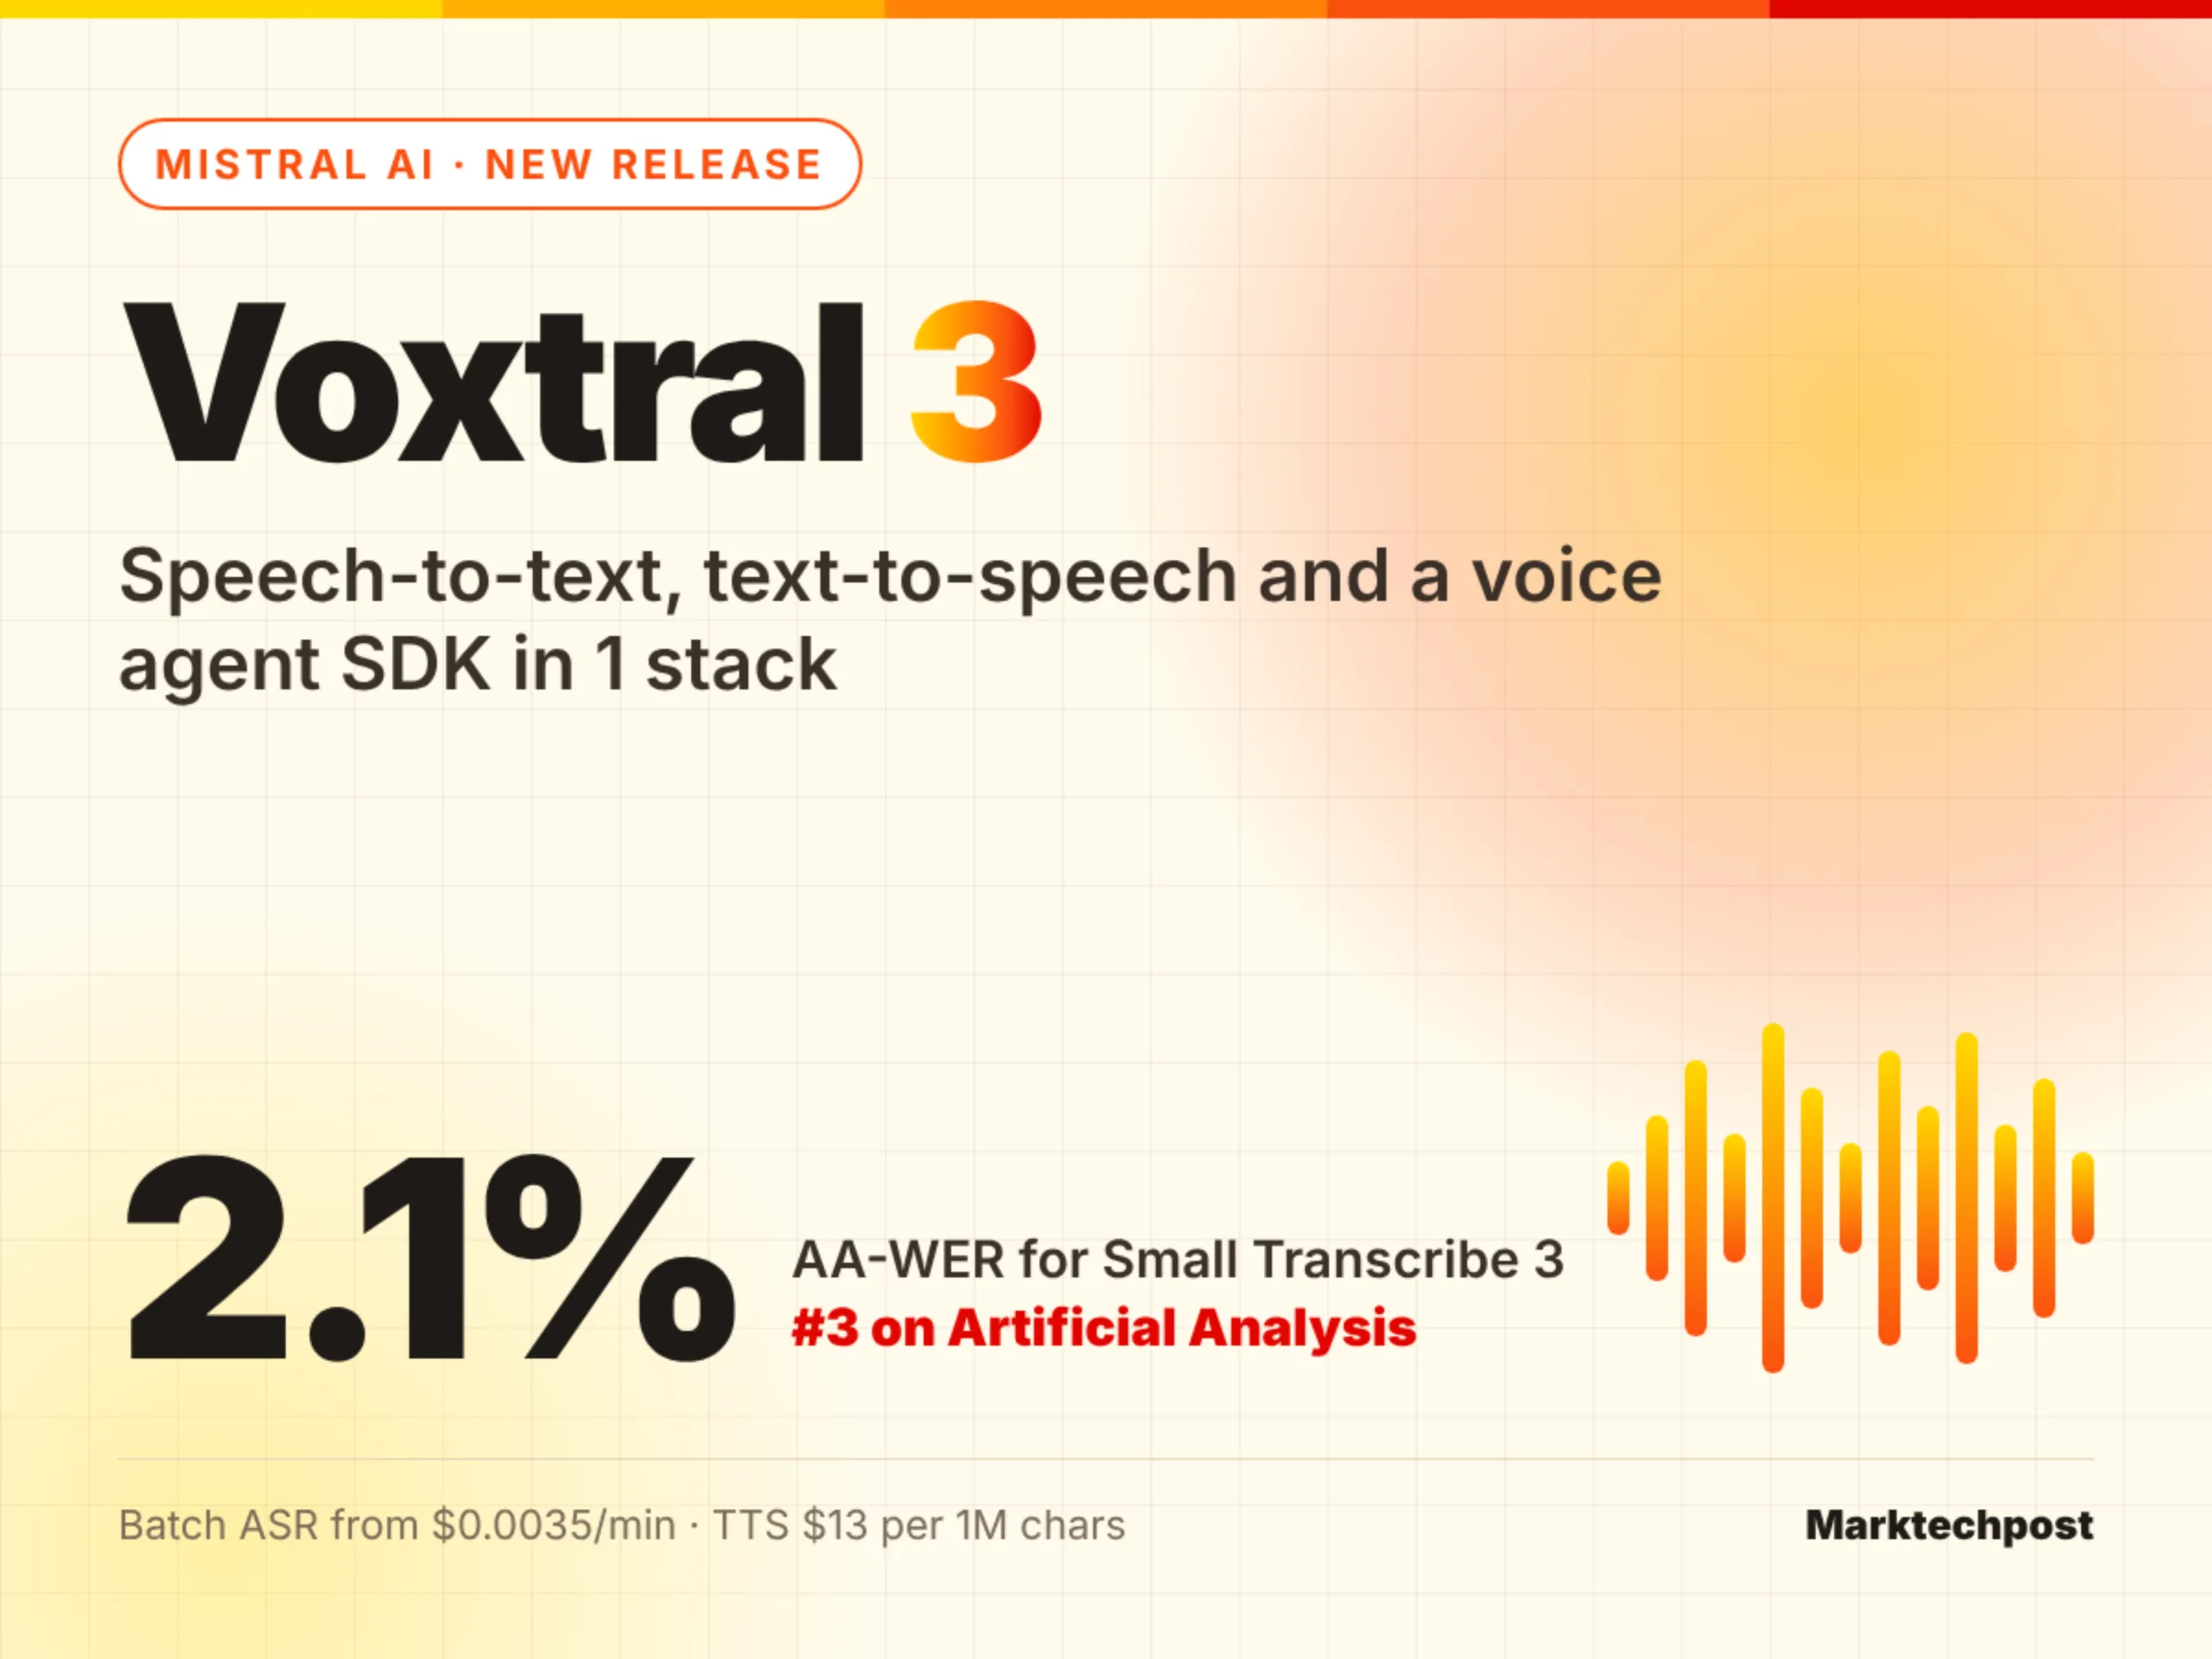
Pentru cei care urmăresc evoluția sectorului, nu este o surpriză că Mistral a decis să intre pe acest segment. După succesul modelor Mistral 7B, Mixtral 8x7B și, mai recent, Mistral Large, compania de la Paris a demonstrat în mod constant că poate livra performanțe de clasă mondială cu resurse computaționale semnificativ mai mici decât competiția. Voxtral 3 nu face excepție — este rezultatul a luni de cercetare concentrată pe o problemă fundamentală: cum facem interacțiunea vocală cu mașinile să fie la fel de naturală, rapidă și accesibilă ca o conversație umană.
Arhitectura tehnică: sub capotă Voxtral 3
Detaliile tehnice publicate până acum sugerează o abordare modulară, dar profund integrată. Componenta de speech-to-text (STT) folosește o arhitectură bazată pe transformer-uri cu atenție multi-cap, optimizată pentru robustețe în condiții de zgomot real — nu doar în laboratoare curate. Modelul a fost antrenat pe o gamă vastă de limbi, accente și dialecte, cu un accent special pe limbi europene adesea neglijate de modelele americane, inclusiv româna, poloneza, cehă și maghiara. Benchmark-urile interne arată un Word Error Rate (WER) sub 3% pe seturi de date standard ca LibriSpeech și Common Voice, plasându-l în zona modelurilor proprietare de top.
Pe partea de text-to-speech (TTS), Mistral a adoptat o abordare difuzivă non-autoregresivă, similară cu cele mai avansate sisteme actuale (ca VoiceBox sau VALL-E), dar cu o inovație cheie: controlul fin al prosodiei, emoției și ritmului prin tokeni speciali inserați în text. Aceasta înseamnă că dezvoltatorii pot specifica nu doar ce se spune, ci cum — susurând, entuziasmat, formal, sceptic — fără a necesita date de antrenament specifice pentru fiecare stil. Modelul susține cloningul vocii cu doar 3-5 secunde de referință, o performanță care ridică barele pentru accesibilitate și personalizare.
Dar poate cea mai importantă componentă este Voice Agent SDK-ul. Nu este simplu un wrapper în jurul STT și TTS, ci un framework complet pentru construirea agenților conversaționali care pot gestiona: turn-taking natural (detecția sfârșitului de replică fără pauze lungi), interruptibilitate (utilizatorul poate opri agentul vorbind), memorie pe termen lung (integrare cu baze de date vectoriale pentru context persistent), și orchestrare multi-modală (combinare voce, text, vizual). SDK-ul vine cu conectori pregătiți pentru LLM-uri populare (inclusiv modelele proprii Mistral, dar și GPT-4, Claude, Llama), cadru de evaluare a calității conversației, și instrumente de deployment pe edge (dispozitive mobile, embedded) și cloud.
Filozofia open-weight: un joc schimbător pentru ecosistem
Ce distinge fundamental Voxtral 3 de ofertele competiției este licențierea. Mistral a confirmat că modelele de bază (STT și TTS) vor fi lansate sub licență Apache 2.0, permițând utilizare comercială neîntreruptă, fine-tuning, și redistribuire. SDK-ul va fi open-source (MIT), în timp ce serviciile gazduite (API-ul gestionat de Mistral) vor urma modelul pay-as-you-go cunoscut. Aceasta este o diferență radicală față de modelele închise ale OpenAI (Whisper API, TTS API) sau ElevenLabs, unde controlul, confidențialitatea datelor și costurile la scară largă rămân puncte de fricțiune majore pentru enterprise-uri și dezvoltatori independenți.
Implicațiile sunt profunde. O companie medicală poate acum construi un asistent vocal pentru pacienți care rulează complet on-premise, fără ca datele audio să părăsească rețeaua internă. O startup din Europa de Est poate lansa un agent vocal în limba maternă fără a plăti royalty-uri per minut sau a depinde de infrastructura unui unicorn american. Comunitatea open-source poate fine-tuna modelele pentru dialecte locale, termeni medicali, juridici sau industriali specifice — ceva imposibil cu API-uri închise.
Cazuri de utilizare reale: de la call center la accesibilitate
Primele demo-uri și programele de acces anticipat (early access) arată aplicații concrete deja în testare:
Provocările și planurile viitoare
Desigur, nu totul este perfect. Comunitatea tehnică a ridicat deja întrebări legitime: latența end-to-end pe modelele mari (versiunile de 7B și 22B parametri) poate fi o problemă pe hardware consumer fără GPU dedicat. Mistral a anunțat versiuni cuantizate (GGUF, AWQ) și modele distilate (1.5B, 3B parametri) pentru edge, dar performanțele rămân de verificat în producție. De asemenea, cloningul vocii ridică probleme etice și de securitate — Mistral a implementat watermarking audio invizibil și politici de utilizare strictă, dar riscul de deepfake-uri vocale rămâne real.
Pe termen mediu, roadmap-ul include: suport nativ pentru conversații multi-participanți (meetings, debate), integrare cu sisteme de traducere automată simultană (speech-to-speech translation), și un marketplace de voci și agenți pre-antrenați pentru domenii specifice (legal, medical, financiar).
Concluzie: un moment charnière pentru Voice AI
Lansarea Voxtral 3 nu este doar un alt release de model — este o declarație de intenții. Mistral AI pariază că viitorul interacțiunii om-mășină este vocal, deschis, și distribuit. Prin a da dezvoltatorilor controlul complet asupra stivei vocale, de la acustică la logică conversațională, compania franceză poate declanșa o explozie de inovație similară cu cea provocată de lansarea Stable Diffusion pentru imagini sau Llama pentru LLM-uri text.
Pentru România și regiunea noastră, mesajul este clar: bariera de intrare pentru a construi produse vocale de clasă mondială în limba noastră a căzut dramatic. Nu mai avem nevoie de bugete de milioane de dolari sau de echipe de cercetare de zeci de oameni. Avem nevoie de vizie, de dezvoltatori talentați, și de curajul să construim. Voxtral 3 pune uneltele pe masă. Restul depinde de noi.
De ce este important:
Voxtral 3 reprezintă democratizarea reală a tehnologiei vocale avansate. Prin combinarea performanței de top cu licențiere open-source (Apache 2.0 pentru modele, MIT pentru SDK), Mistral AI elimină barierile costului, controlului vendor-lock-in și confidențialității care au blocat adopția masivă a agentilor voce în enterprise și inovația locală. Pentru România, acest lucru înseamnă oportunitatea de a dezvolta soluții vocale în limba română — pentru administrație publică, sănătate, educație, servicii financiare — fără dependență de giganți tehnologici străini și cu costuri fracționale. Este momentul în care ecosistemul tehnologic local poate sări o generație de dezvoltare și să creeze produse vocale competitive global, vorbind limba utilizatorilor săi nativ.