Subiect: #Text-to-Speech
Mistral AI lansează Voxtral 3: Revoluția în recunoașterea vocală, sinteza text-vorbire și SDK-ul pentru agenți voce
Mistral AI lansează Voxtral 3, o suită completă open-weight pentru Voice AI: speech-to-text robust multilingv, TTS expresiv cu control de prosodie, și SDK pentru agenți voce conversaționali. Articolul analizează arhitectura, implicațiile pentru dezvoltatori și enterprise, și oportunitățile pentru ecosistemul tehnologic românesc.
Fish Audio lansează Drama 3: modelul TTS cu 35 de miliarde de parametri care zguduie piața de voce artificială
Fish Audio lansează Drama 3, un model TTS cu 35 de miliarde de parametri, arhitectură MoE și greutăți deschise publicului. Calitate de nivel ElevenLabs, suport pentru limba română și oportunități majore pentru dezvoltatorii independenți.
Mati Staniszewski, CEO ElevenLabs: "Vrem să fim primii care trecem testul Turing pentru AI conversațional"
Interviu exclusiv cu Mati Staniszewski, CEO ElevenLabs: despre cursa către testul Turing pentru AI conversațional, strategia de margină zero pentru capturarea pieței, dilemă etică a transparenței și geopolitica modelelor vocale la nivel guvernamental. O analiză profundă a companiei evaluate la 22 miliarde $ cu 600M ARR la 4 ani.
Gradium lansează Voice Design: scrie un prompt și obține o voce sintetică nouă în câteva secunde
Gradium lansează Voice Design, o funcție care permite generarea de voci sintetice personalizate pe baza unui simplu prompt textual. Tehnologia promite să democratizeze crearea de conținut audio, oferind voci realiste în câteva secunde, cu aplicații variate de la podcasturi la jocuri video.

Cartesia lansează Sonic-3.6: modelul TTS streaming care domină ambele arene de vorbire de la Artificial Analysis
Cartesia a lansat Sonic-3.6, un model TTS streaming care a urcat pe primul loc în ambele arene de vorbire de la Artificial Analysis, combinând calitate vocală excepțională cu latență redusă. Descoperă ce înseamnă această performanță pentru industria AI și pentru utilizatori.

Alibaba lansează Qwen-Audio-3.0-TTS: modelul text-to-speech care vorbește 16 limbi, în variante Flash și Plus
Alibaba, prin laboratorul Tongyi, a lansat Qwen-Audio-3.0-TTS, un model text-to-speech găzduit, disponibil în variantele Flash (rapid) și Plus (calitate superioară), care suportă 16 limbi. Articolul analizează caracteristicile, impactul pe piață, beneficiile și limitările acestui sistem avansat de sinteză vocală.
Miso Labs lansează MisoTTS: Un model de sinteză vocală emoțională de 8 miliarde de parametri, cu greutăți deschise
Miso Labs a lansat MisoTTS, un model text-to-speech de 8 miliarde de parametri, capabil să redea emoții autentice, cu greutăți open-source. Articolul analizează tehnologia, aplicațiile și impactul asupra industriei AI.
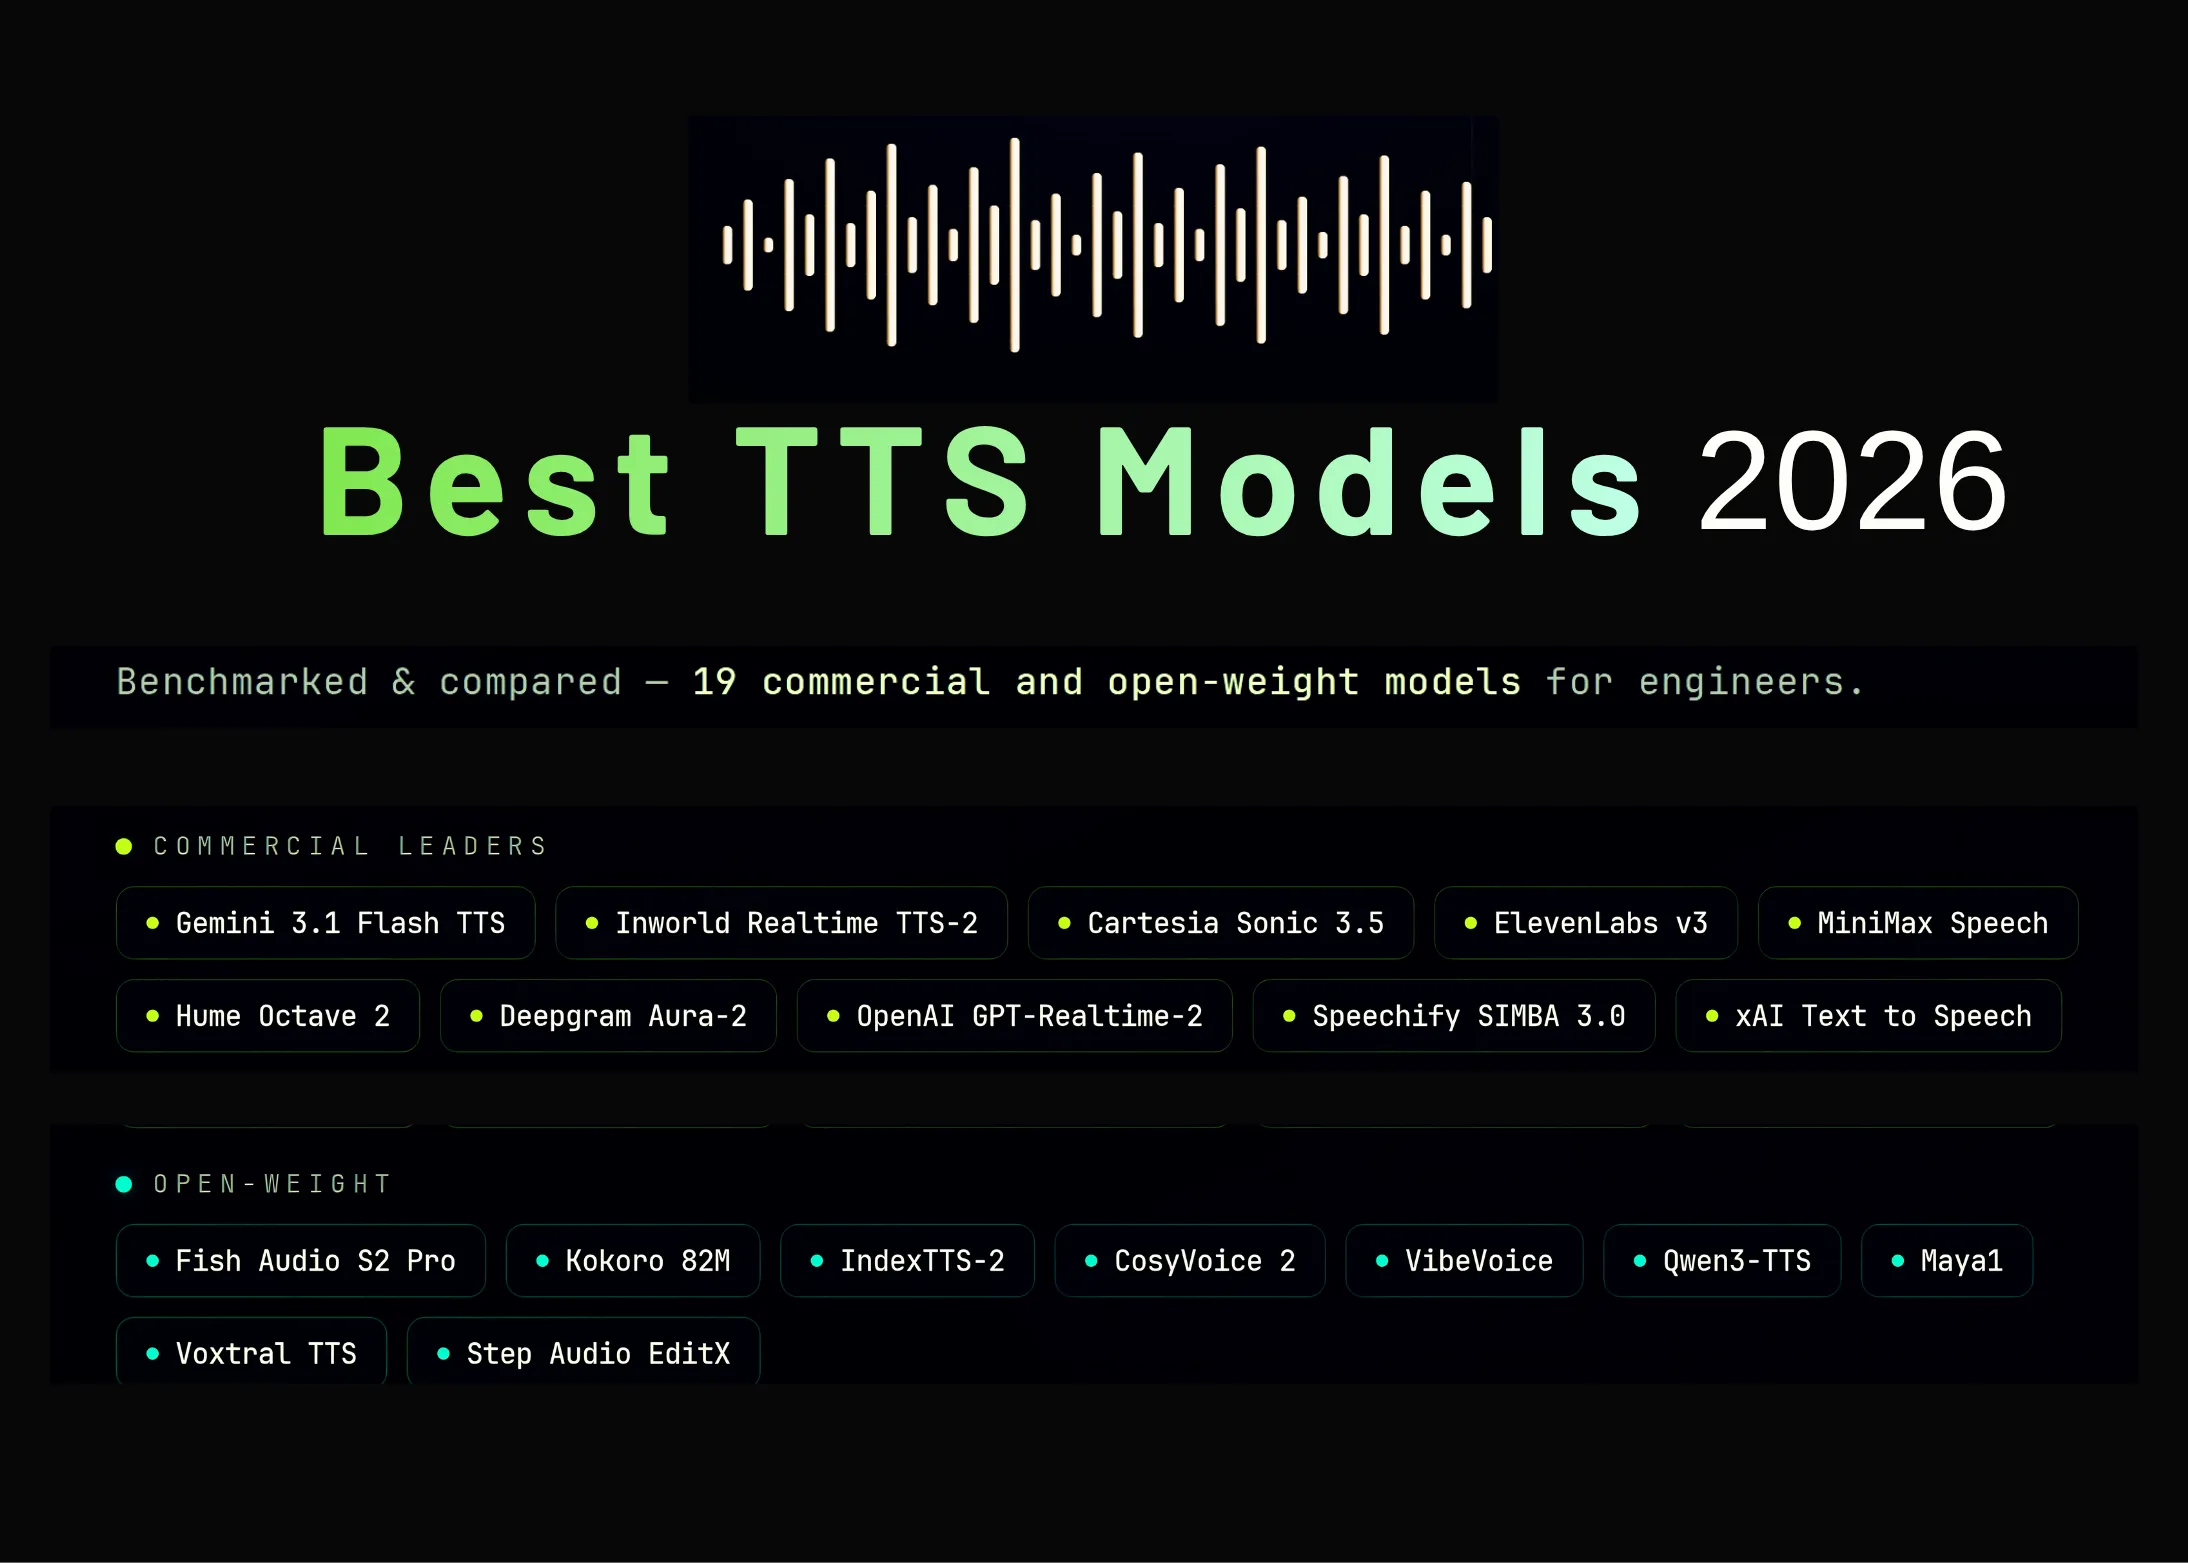
Cele mai bune modele Text-to-Speech (TTS) în 2026: O comparație bazată pe benchmark-uri
Descoperă cele mai bune modele Text-to-Speech din 2026, analizate pe baza benchmark-urilor de naturalete, viteză și suport multilingv. De la ElevenLabs la Google și Microsoft, află care se potrivește nevoilor tale.
Supertone lansează Supertonic v3: model de sinteză vocală pe dispozitiv cu suport pentru 31 de limbi, mai puține erori de citire și etichete de expresie
Supertone lansează Supertonic v3, un model TTS pe dispozitiv care suportă 31 de limbi, reduce erorile de citire și introduce etichete de expresie pentru control emoțional. Articolul analizează caracteristicile, impactul și potențialul acestei inovații în domeniul sintezei vocale.
Implementare practică a SDK-ului Python Deepgram pentru transcriere, sinteză vocală, procesare audio asincronă și inteligență textuală
Un ghid practic pentru utilizarea SDK-ului Python Deepgram în transcrierea audio, sinteză vocală, procesare asincronă și analiză textuală, cu exemple de cod și sfaturi de optimizare.
Mistral AI lansează Voxtral TTS: Un model revoluționar de sinteză vocală, cu greutate deschisă, dedicat streaming-ului în timp real
Mistral AI a prezentat Voxtral TTS, un model inovator de sinteză vocală de 4 miliarde de parametri, optimizat pentru streaming în timp real și latență redusă. Disponibil ca open-weight, modelul multilingv promite să democratizeze tehnologia voce-AI și să îmbunătățească semnificativ interacțiunea cu asistenții virtuali.
Mistral lansează un nou model open-source pentru generarea vorbirii: Voxtral TTS
Mistral AI lansează Voxtral TTS, un model text-to-speech open-source care rulează pe dispozitive edge, suportă nouă limbi și oferă performanțe în timp real, provocând competitori precum ElevenLabs și OpenAI.