Vestea vine într-un context în care lumea AI-ului se confruntă cu o problemă tot mai vizibilă. Modelele de limbaj au devenit extraordinare la sarcini singulare — răspund la o întrebare, rezumă un text, scriu o funcție. Dar când sunt puse să poarte un dialog lung, cu mai multe etape, cu instrumente externe, cu memorie și cu obiective care se schimbă pe parcurs, lucrurile se complică dramatic. Un agent care rezervă o călătorie, care negociază un contract sau care diagnostichează o problemă tehnică pas cu pas are nevoie de ceva ce majoritatea modelelor actuale nu posedă nativ: capacitatea de a-și da seama că a greșit și de a corecta cursul fără să o ia razna.
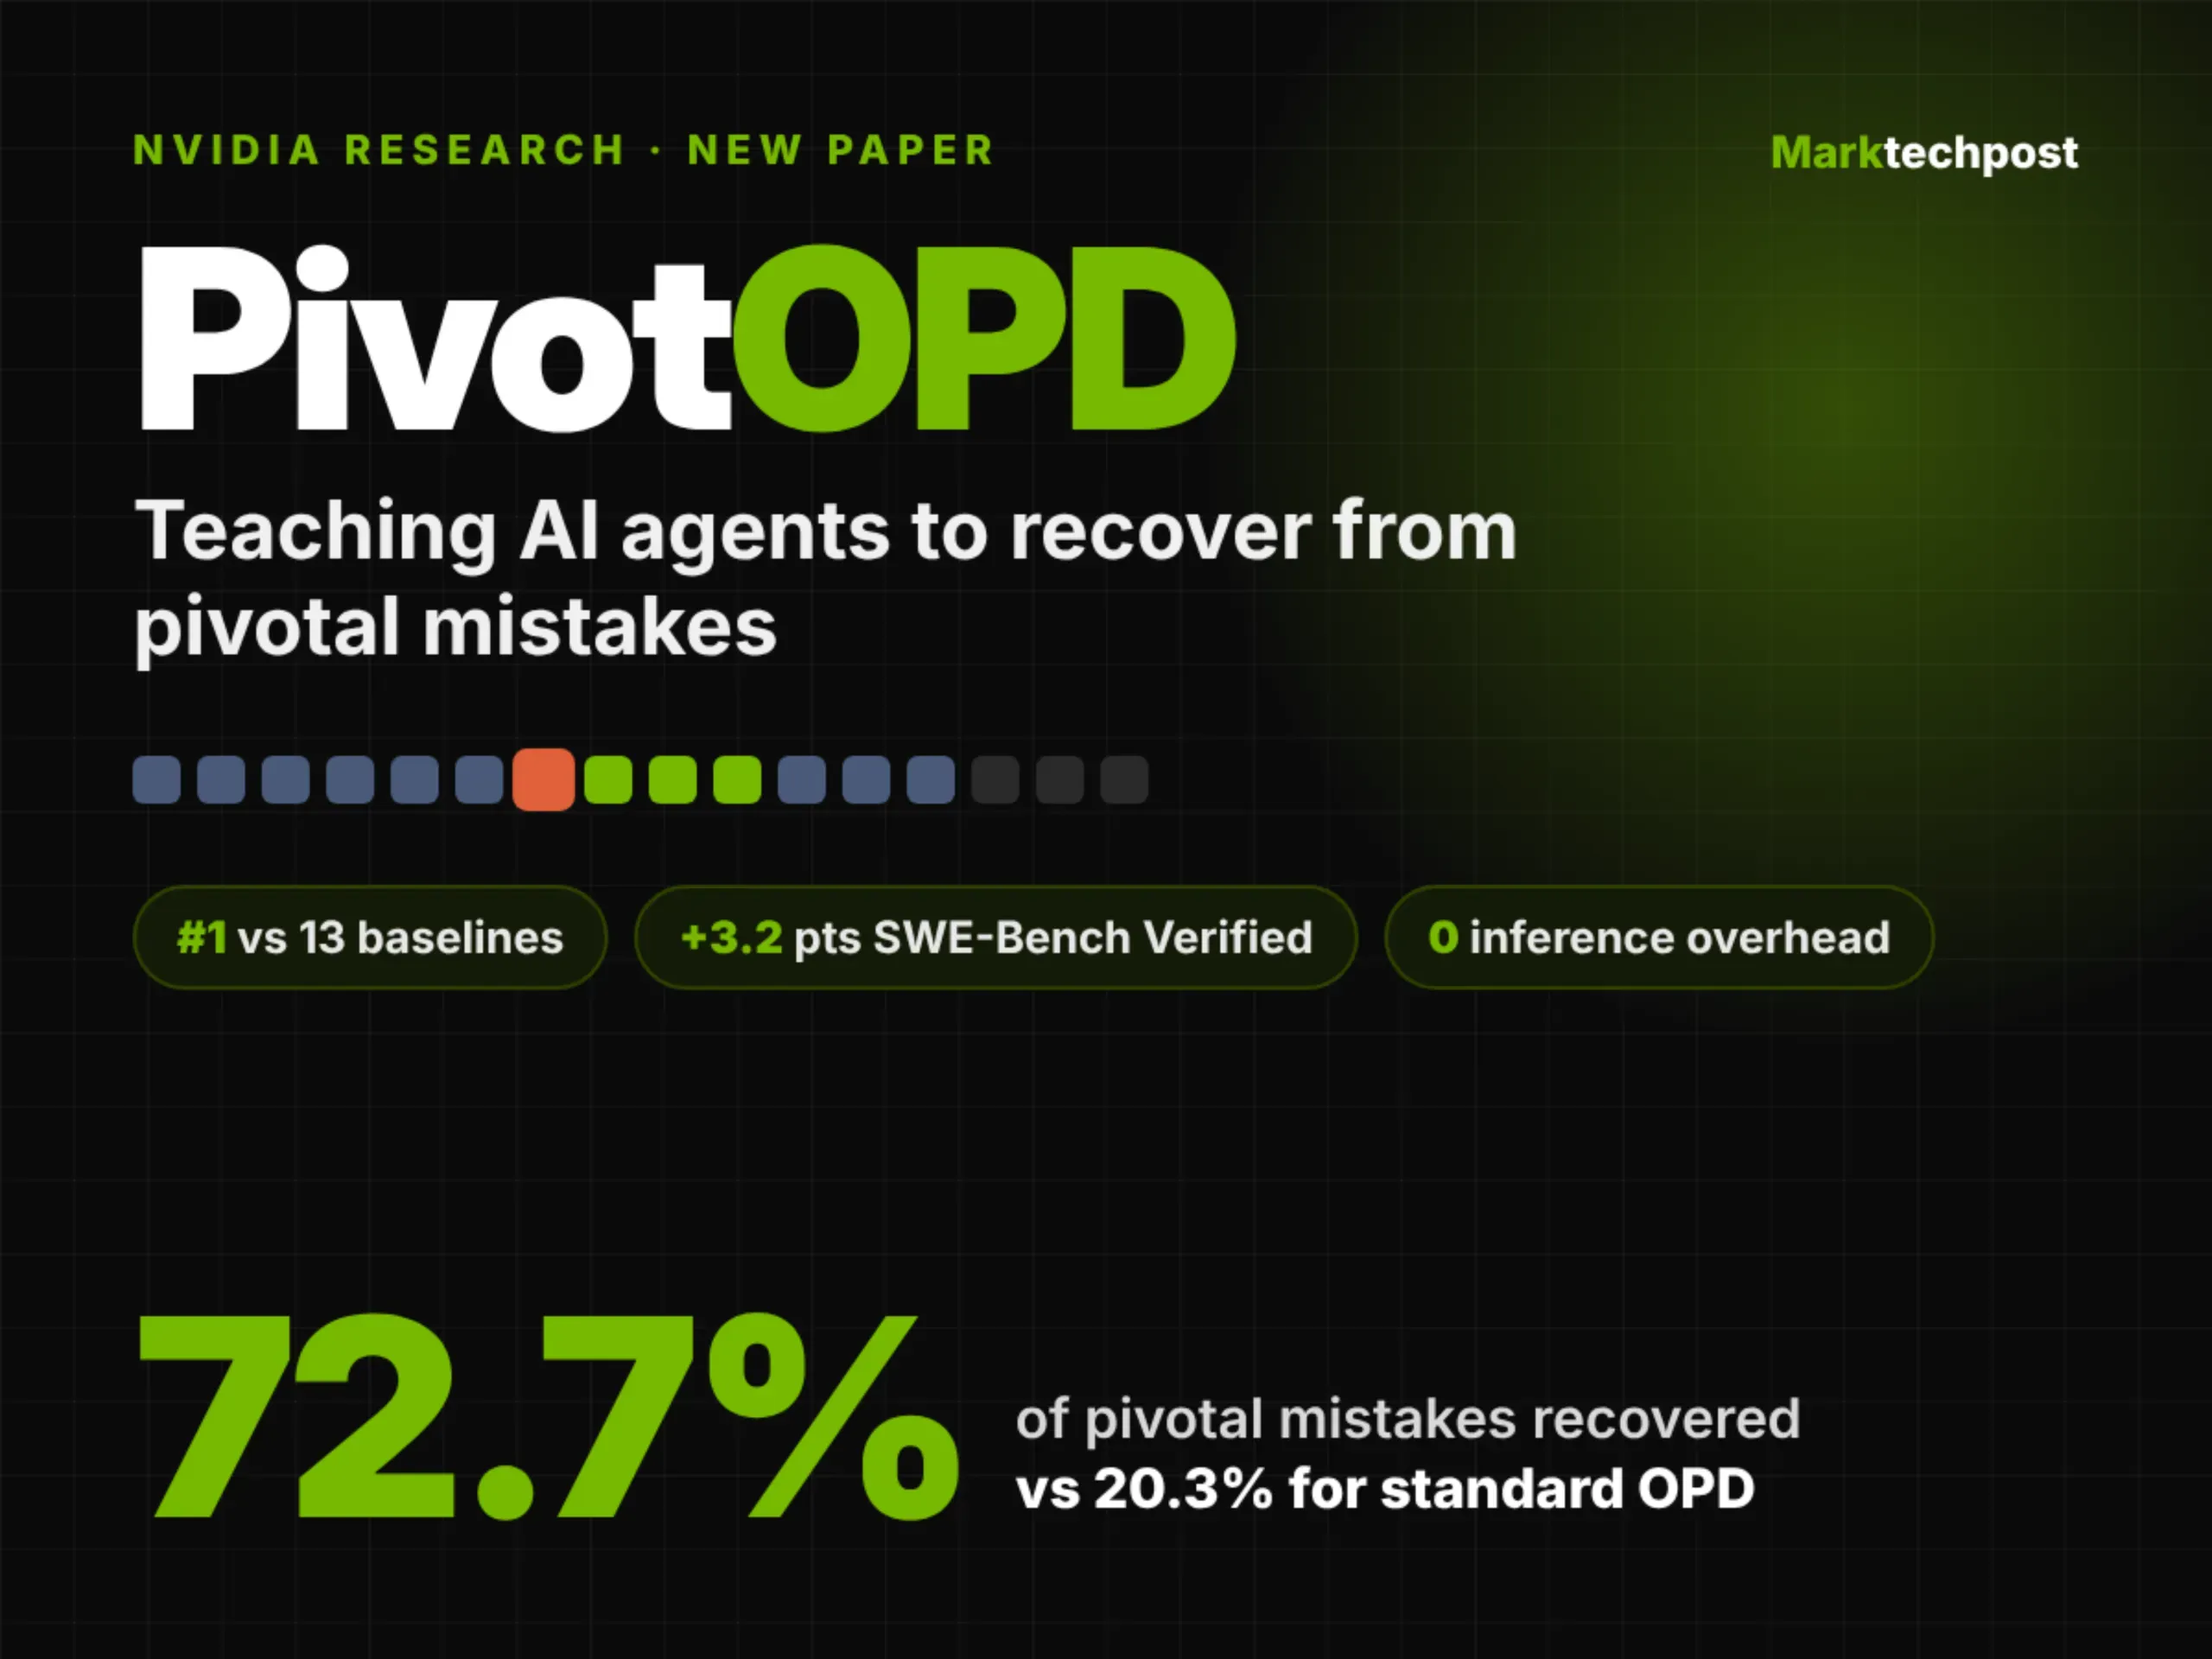
Aici intervine PivotOPD. Numele vine de la „Pivotal On-Policy Distillation" — o tehnică prin care NVIDIA antrenează agenții să identifice acele momente-pivot din conversație, punctele în care o decizie influențează ireversibil restul interacțiunii. Spre deosebire de metodele clasice, care se concentrează pe optimizarea fiecărui pas în parte, PivotOPD pune accentul pe recuperare. Adică pe ceea ce se întâmplă după ce ceva a mers prost.
Gândiți-vă la un agent care trebuie să ajute un client să-și schimbe un zbor. La un moment dat, agentul înțelege greșit data și propune o rerutare complet aiurea. Un model obișnuit, odată ce a intrat pe această traiectorie, va continua să construiască pe ea — va confirma, va emite biletul, va înrăutăți situația. Un agent antrenat cu PivotOPD, în schimb, este învățat să detecteze inconsistența, să revină la ultima stare validă și să reia conversația dintr-un punct sigur. Este diferența dintre un angajat care se blochează când greșește și unul care ridică mâna, spune „am greșit, hai să reluăm" și rezolvă problema.
Din punct de vedere tehnic, abordarea NVIDIA se bazează pe distilare on-policy — adică antrenarea unui model elev pe traiectorii generate chiar de el, nu pe date statice pregătite de oameni. Această alegere este crucială, pentru că erorile reale ale unui agent sunt mult mai variate și mai subtile decât cele pe care le poți inventa manual. Prin distilare on-policy, modelul învață din propriile ratări, exact în momentele în care acestea apar. Iar PivotOPD adaugă un strat suplimentar: identifică punctele critice din aceste traiectorii și le acordă o greutate specială în procesul de învățare. Cu alte cuvinte, agentul nu este pedepsit la fel pentru orice greșeală, ci este învățat să acorde atenție maximă acelor decizii care pot schimba soarta întregii conversații.
Este o schimbare de paradigmă care merită subliniată. Ani de zile, comunitatea AI s-a concentrat pe performanță în sarcini izolate — benchmark-uri, scoruri, acuratețe pe un singur răspuns. Dar agenții reali trăiesc în lumea conversațiilor lungi, a contextului care se acumulează, a instrumentelor care pot da erori, a utilizatorilor care își schimbă cerințele la mijlocul discuției. În această lume, abilitatea de a te recupera valorează mai mult decât abilitatea de a nu greși niciodată — pentru că ultima este, pur și simplu, imposibilă.
NVIDIA nu este singura companie care atacă această problemă. Laboratoare precum Anthropic, Google DeepMind și OpenAI lucrează de ani buni la ceea ce se numește „robustețe conversațională" sau „recuperare după eroare". Dar ceea ce aduce PivotOPD în plus este o metodă sistematică, reproductibilă, care poate fi aplicată pe modele de diferite dimensiuni. Nu este vorba doar despre un truc de antrenament, ci despre o schiță de curriculum: agentul învață mai întâi să recunoască momentele-pivot, apoi să genereze alternative, apoi să aleagă calea cea mai bună pentru a reveni pe făgaș.
Impactul practic al acestei cercetări se va simți în toate zonele unde agenții AI încep să fie folosiți în producție. Asistenții pentru clienți, care trebuie să gestioneze conversații de zeci de minute fără să piardă firul. Agenții de cod, care trebuie să revină după un test picat. Sistemele de planificare, care trebuie să-și recalculeze traseul când un pas eșuează. Toate aceste aplicații depind de capacitatea de a nu se prăbuși la prima eroare semnificativă. Iar PivotOPD promite exact asta: agenți care nu doar că greșesc mai rar, ci care știu ce să facă atunci când greșesc.
Desigur, rămân întrebări deschise. Cât de bine se transferă această metodă de la un domeniu la altul? Cum se comportă în conversații cu adevărat lungi, de sute de ture? Ce se întâmplă când utilizatorul însuși induce eroarea, iar agentul trebuie să navigheze o situație contradictorie? Acestea sunt provocări pe care cercetătorii le vor aborda în lunile și anii următori. Dar direcția este clară: viitorul agenților AI nu este despre perfecțiune, ci despre reziliență.
Poate că cea mai frumoasă lecție pe care ne-o dă NVIDIA cu PivotOPD nu este una tehnică, ci una umană. Nimeni nu este infailibil — nici oamenii, nici mașinile. Ceea ce ne definește, de fapt, este felul în care ne ridicăm după ce cădem. Iar dacă vrem agenți AI care să lucreze cu noi, alături de noi, în lumea reală, atunci trebuie să-i învățăm exact acest lucru: să recunoască momentul în care au greșit și să aibă curajul să o ia de la capăt.
De ce este important:
PivotOPD marchează o schimbare fundamentală în felul în care gândim antrenarea agenților AI. Până acum, industria s-a concentrat aproape exclusiv pe performanță în sarcini izolate, ignorând faptul că agenții reali trăiesc în conversații lungi, pline de incertitudine și erori. Capacitatea de a te recupera după o greșeală critică este mult mai valoroasă decât iluzia perfecțiunii, pentru că agenții care nu știu să revină dintr-o eroare devin periculoși în producție — pot confirma rezervări greșite, pot emite cod defect, pot înrăutăți o situație de criză. Metoda NVIDIA oferă o cale sistematică de a antrena această reziliență, ceea ce va accelera adoptarea agenților autonomi în domenii sensibile precum sănătatea, finanțele sau asistența clienților. Mai mult, PivotOPD ne reamintește că inteligența autentică nu înseamnă absența erorii, ci capacitatea de a învăța din ea — un principiu care se aplică la fel de bine mașinilor și oamenilor.