Să o luăm de la început. Când vorbim despre modele lingvistice precum GPT, Claude, Gemini sau Llama, ne imaginăm de obicei doar partea vizibilă: promptul pe care îl scriem și răspunsul care apare în câteva secunde. În spate, însă, se află o infrastructură gigantică de centre de date, mii de plăci grafice scumpe, sisteme de răcire, cabluri, transformatoare și facturi de energie care se măsoară în milioane de dolari pe lună. Fiecare interogare pe care o trimitem consumă o fracțiune de secundă dintr-un GPU. Iar problema fundamentală este că această capacitate este distribuită extrem de inegal: uneori stă degeaba, alteori este supraîncărcată până la refuz.
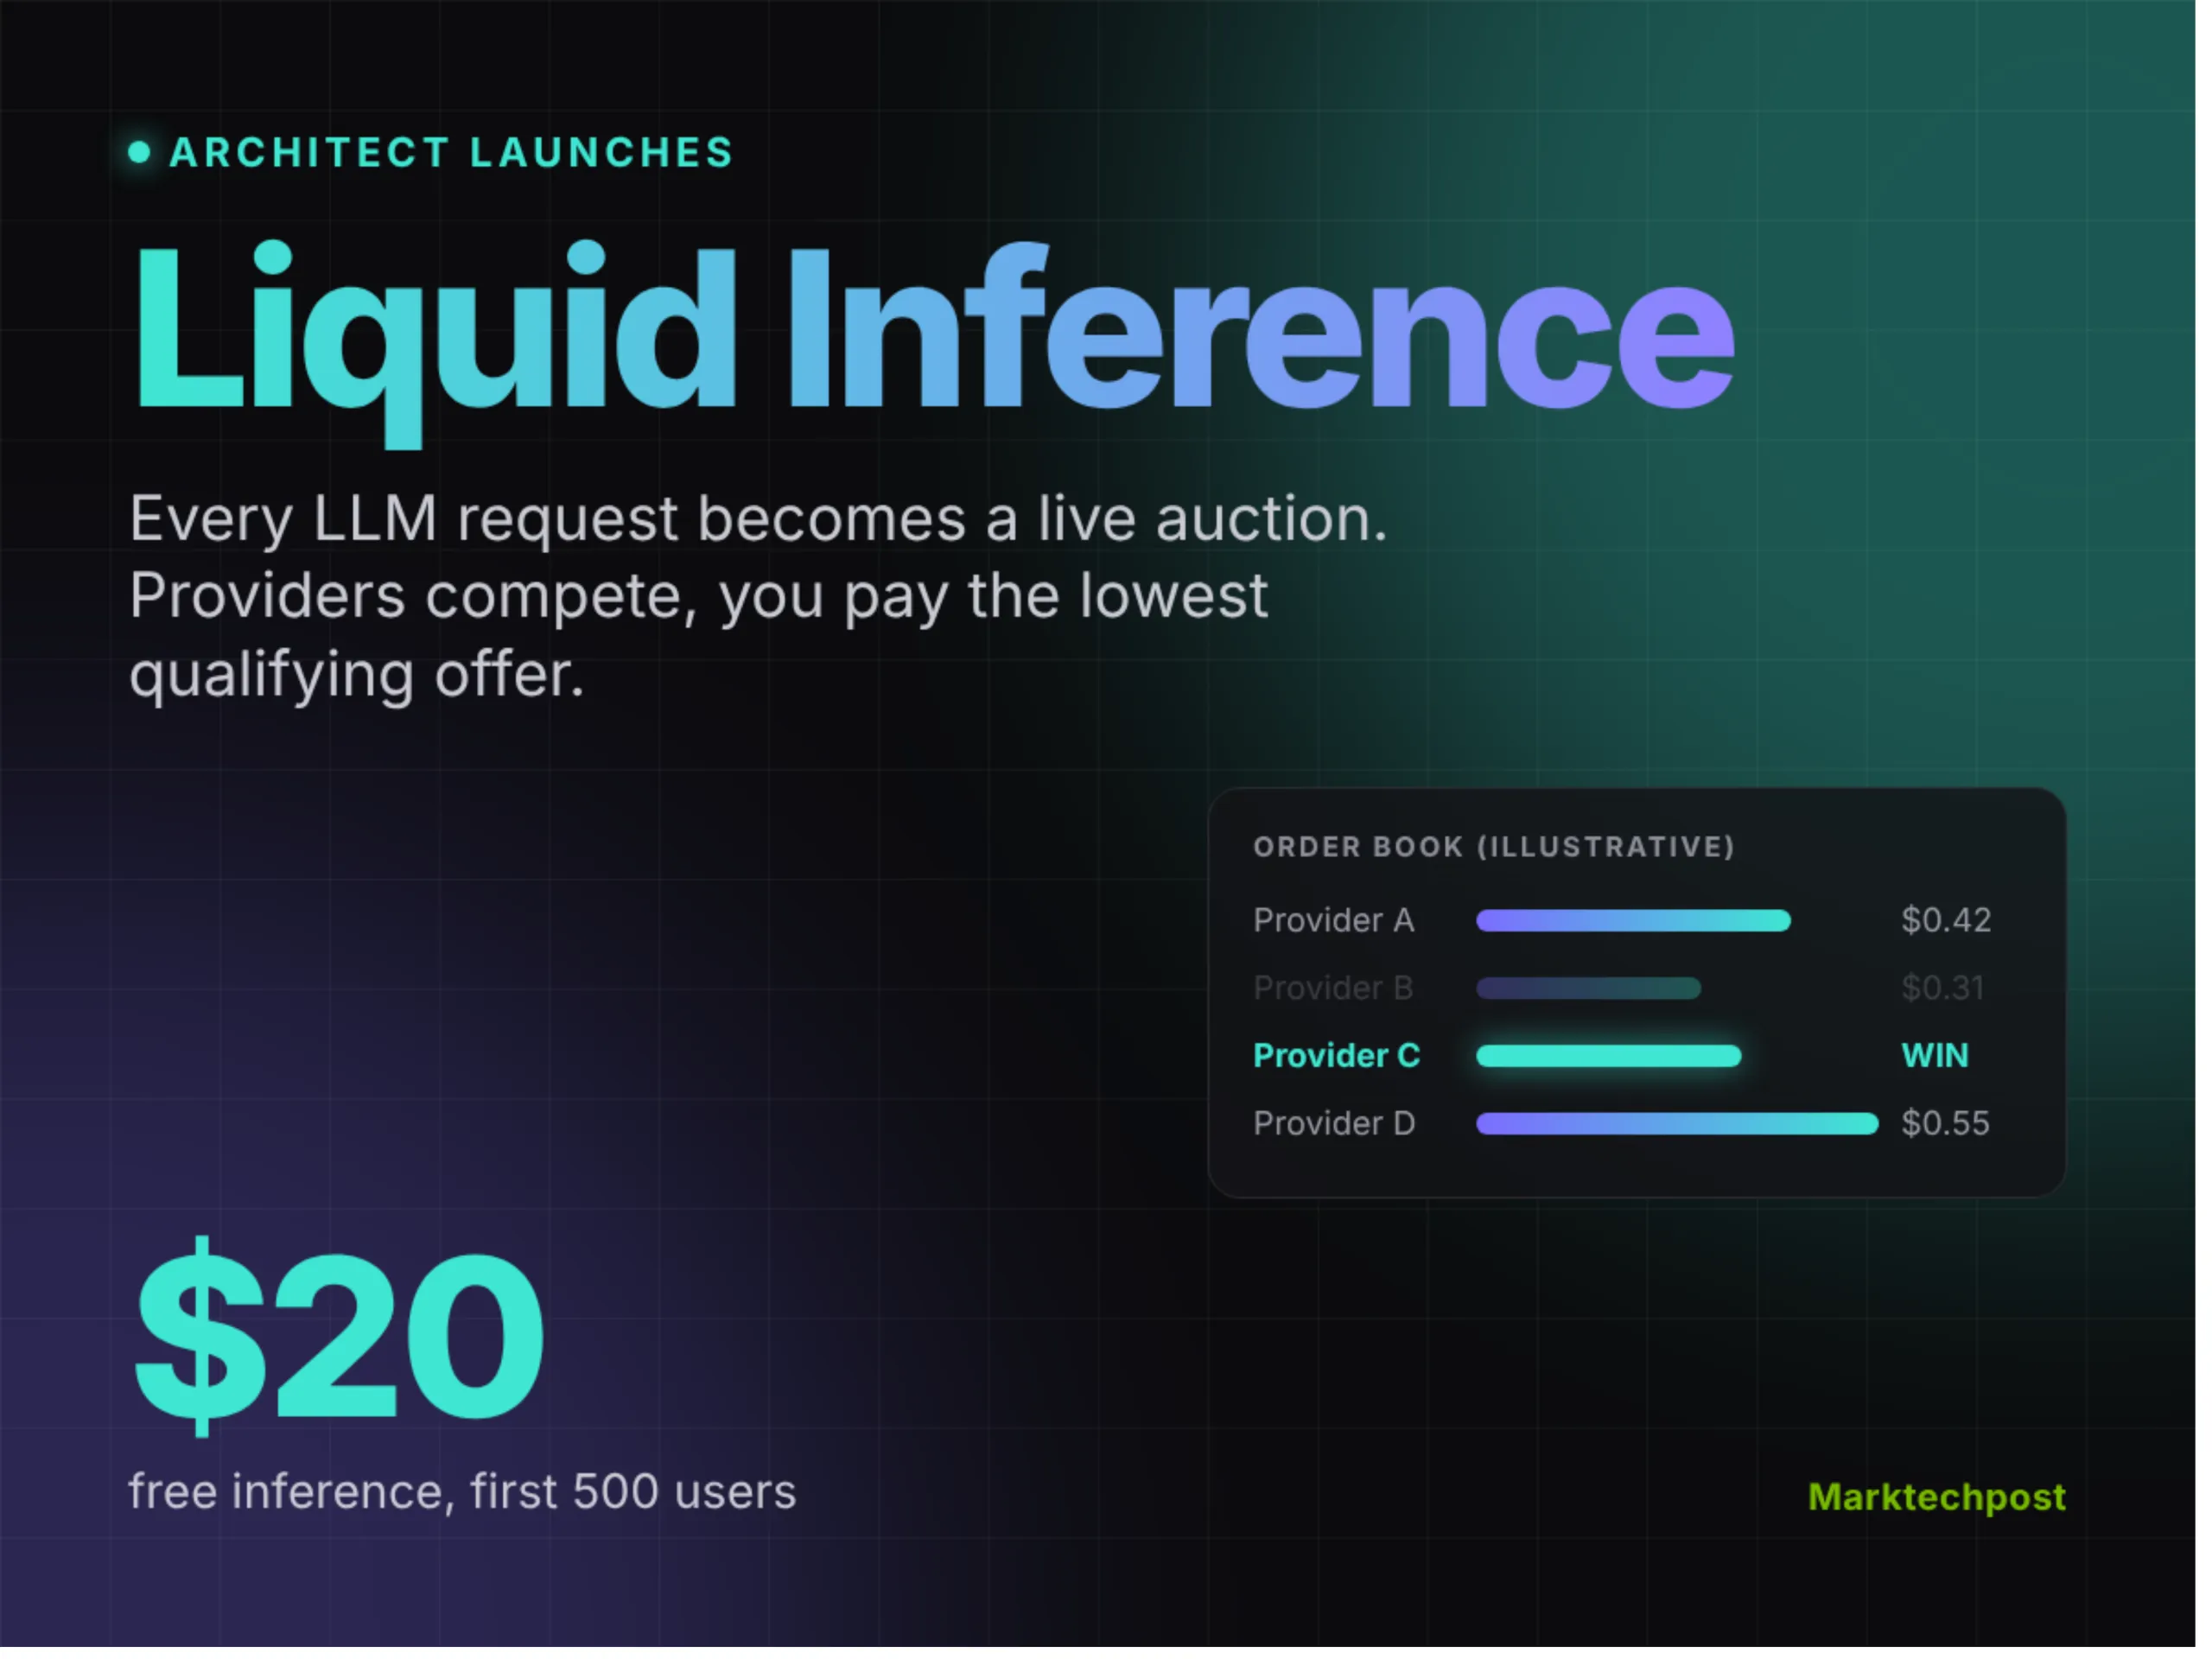
Aici intervine Architect. Compania, cunoscută în cercurile de infrastructură AI pentru abordările sale neconvenționale, a decis să atace exact acest dezechilibru. Liquid Inference nu este un simplu serviciu de cloud. Este, în esență, o piață. O bursă. Un loc unde cererea și oferta de inferență se întâlnesc în timp real, iar prețul se formează la fel cum se formează prețul petrolului sau al acțiunilor: prin licitație continuă.
Cum funcționează, mai exact? Să presupunem că o companie are nevoie urgentă să ruleze un model mare pentru un chatbot care trebuie să răspundă în mai puțin de o secundă. În același timp, un alt client are un batch de documente de procesat peste noapte, fără nicio presiune de timp. În modelul clasic, ambele plătesc același tarif pe oră de GPU, deși nevoile lor sunt radical diferite. În modelul Liquid Inference, primul client licitează agresiv pentru latență minimă, în timp ce al doilea acceptă să aștepte și plătește mult mai puțin. Furnizorii de capacitate — de la hyperscaleri până la operatori mici cu câteva rack-uri — își listează resursele disponibile, iar algoritmul potrivește cererea cu oferta în fracțiuni de secundă.
Este o idee care a mai fost încercată, dar niciodată la această scară și cu această ambiție. Piața spot pentru GPU există deja la furnizori precum AWS sau Lambda, dar acolo vorbim despre închirieri pe ore sau pe zile. Liquid Inference merge mult mai jos, la nivel de milisecunde și de tokeni generați. Practic, fiecare cerere de inferență devine un mic contract negociat automat, cu un preț care reflectă urgența, disponibilitatea și complexitatea modelului.
De ce contează asta? Pentru că economia inteligenței artificiale se confruntă cu o contradicție uriașă. Pe de o parte, cererea explodează. Fiecare startup, fiecare bancă, fiecare spital, fiecare agenție guvernamentală vrea să integreze AI. Pe de altă parte, oferta de GPU-uri de top este limitată de lanțuri de aprovizionare fragile, de capacitatea de producție a Nvidia și de constrângeri energetice tot mai severe. În acest context, fiecare procent de utilizare câștigat contează. Iar studiile arată că, în medie, centrele de date AI funcționează la 30-50% din capacitate. Restul este risipă pură.
Liquid Inference promite să reducă această risipă. Dacă un GPU stă degeaba pentru 200 de milisecunde între două cereri, piața îl poate vinde imediat altcuiva care are nevoie de el. Dacă o companie are un vârf brusc de trafic, nu mai trebuie să închirieze un server întreg pentru o oră — poate cumpăra exact ceea ce are nevoie, exact atunci când are nevoie. Este principiul cloud computing-ului dus la extremă: elasticitate absolută, la nivel de milisecundă.
Desigur, nu totul este roz. O astfel de piață ridică probleme serioase de guvernanță. Cine stabilește regulile licitației? Cum se protejează datele sensibile care trec prin aceste GPU-uri partajate? Ce se întâmplă când un client mare decide să cumpere agresiv toată capacitatea disponibilă, sufocând concurența? Și, poate cel mai important, cum se asigură calitatea și consistența răspunsurilor atunci când inferența este fragmentată între zeci de furnizori diferiți?
Architect spune că a construit mecanisme de izolare strictă, criptare end-to-end și garanții de nivel de serviciu (SLA) care se aplică indiferent de cine furnizează capacitatea. Compania susține, de asemenea, că algoritmul său de licitație este proiectat să prevină monopolizarea și să favorizeze diversitatea furnizorilor. Rămâne de văzut cât de bine funcționează aceste promisiuni în practică, mai ales când vor apărea primii clienți mari cu interese comerciale agresive.
Un alt aspect fascinant este implicația geopolitică. Astăzi, accesul la puterea de calcul AI este concentrat în câteva țări și câteva companii. O piață lichidă, globală, ar putea democratiza accesul: un startup din Nairobi sau din București ar putea licita pentru aceleași resurse ca o corporație din Silicon Valley, plătind doar pentru ceea ce consumă. Desigur, în practică, diferențele de capital și de infrastructură locală rămân enorme. Dar direcția este interesantă.
Nu în ultimul rând, Liquid Inference ridică întrebări filozofice despre natura inteligenței artificiale ca utilitate publică. Dacă inferența devine o marfă tranzacționată la bursă, cu prețuri care fluctuează în funcție de cerere, atunci cine va avea acces la AI în momentele de vârf? Vor exista „ore de vârf” în care doar companiile bogate își permit să gândească? Sau piața va face exact invers, coborând prețurile prin eficiență?
Răspunsul nu este încă clar. Cert este că Architect a aruncat o mănușă pe masa industriei. Dacă Liquid Inference funcționează, vom vedea în curând imitatori. Dacă nu, vom învăța ceva important despre limitele piețelor în infrastructura critică. Într-un fel sau altul, modul în care gândim despre puterea de calcul se schimbă. Iar schimbarea, ca întotdeauna în tehnologie, vine mai repede decât ne așteptăm.
De ce este important:
Liquid Inference nu este doar un produs nou, ci un experiment radical despre cum ar trebui organizată economia inteligenței artificiale. Astăzi, cea mai mare parte a capacității de calcul pentru AI este irosită sau blocată în contracte rigide, în timp ce cererea explodează. O piață în timp real ar putea reduce costurile, ar putea democratiza accesul la modele puternice și ar putea accelera inovația în domenii care nu își permit astăzi GPU-uri scumpe. În același timp, ridică întrebări serioase despre guvernanță, securitate și echitate. Dacă reușește, Architect nu va schimba doar modul în care cumpărăm inferență — va schimba modul în care gândim despre inteligență ca resursă economică. Iar asta, într-o lume care se digitalizează accelerat, este o schimbare pe care nimeni nu și-o poate permite să o ignore.