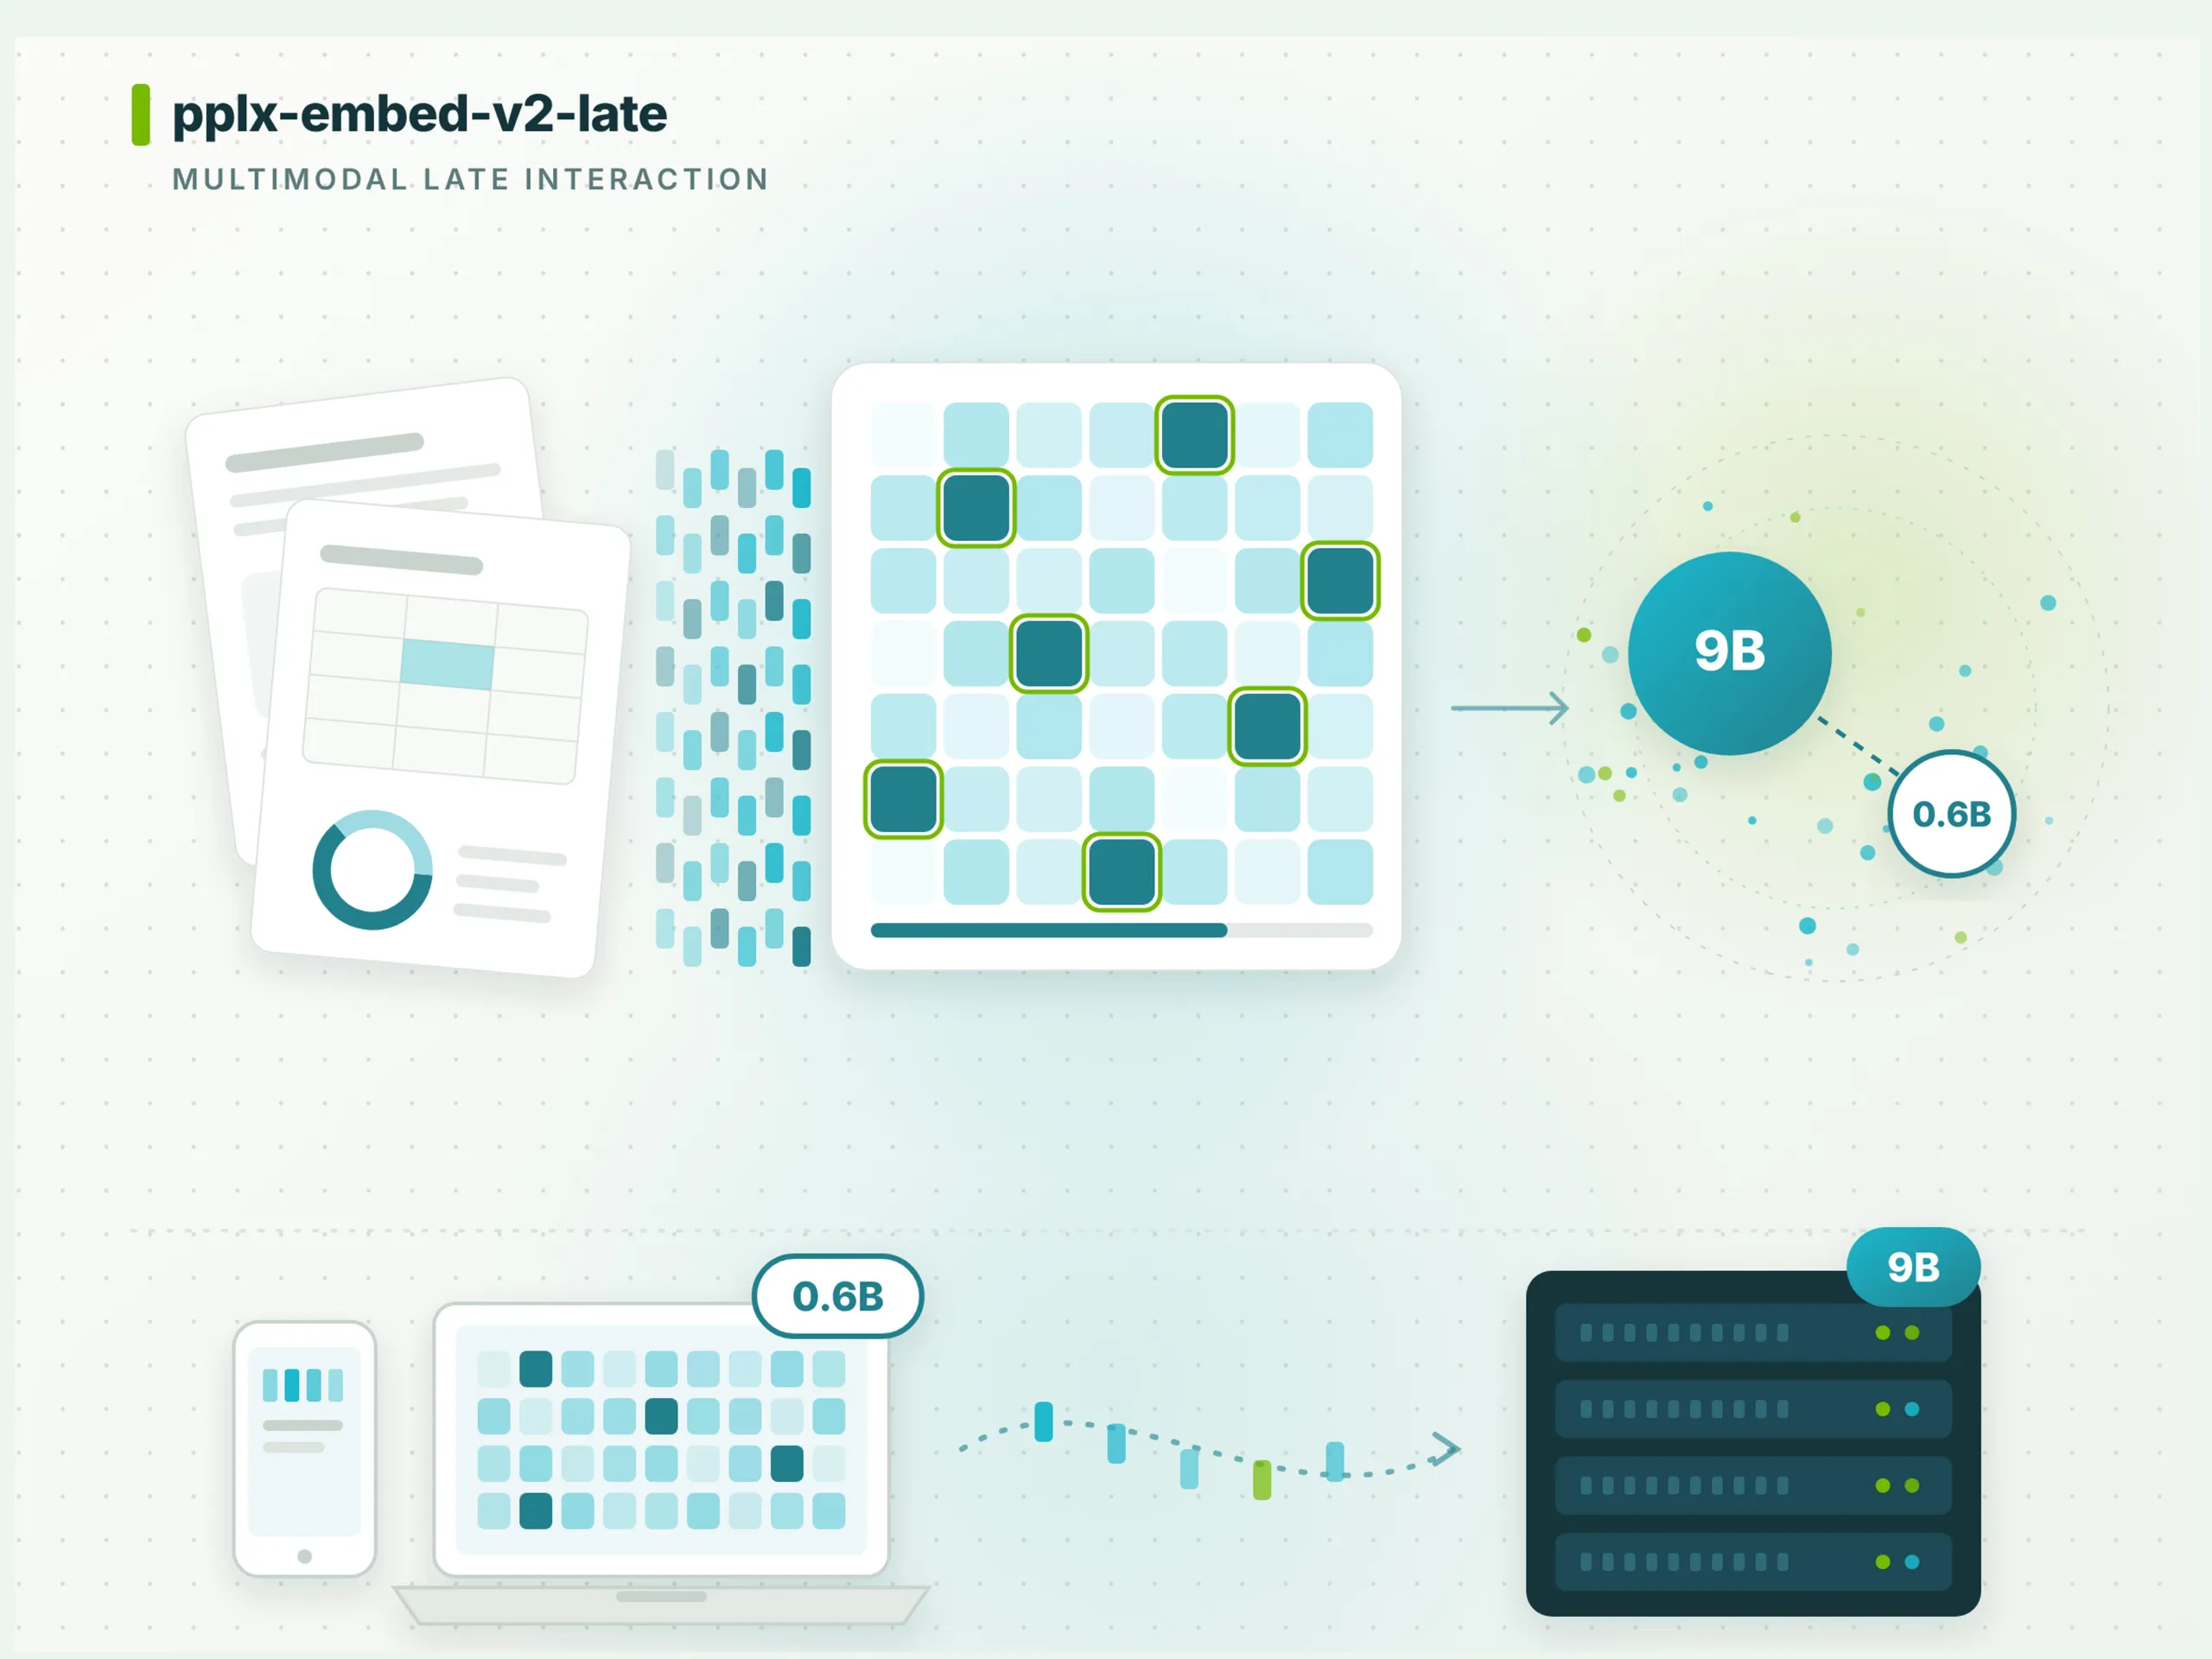
Vorbim despre două modele care vin în tandem. Pe de o parte, un model compact de doar 0,6 miliarde de parametri, gândit să ruleze la marginea rețelei — pe telefoane, laptopuri, dispozitive IoT sau chiar în browser. Pe de altă parte, un model masiv de 9 miliarde de parametri, care a reușit să atingă pragul de 92,4% pe MADQA, un benchmark care devine tot mai relevant în lumea sistemelor de retrieval augmentat (RAG).
Pentru cine nu e familiarizat cu termenii, să lămurim rapid: un model de embedding este acea componentă discretă, dar esențială, care transformă textul în vectori numerici. Practic, ia o propoziție, un paragraf sau un document întreg și îl mapează într-un spațiu matematic unde sensul devine distanță. Două texte cu înțeles apropiat ajung aproape unul de altul în acel spațiu; două texte fără legătură ajung departe. Sună banal, dar fără această operațiune, niciun sistem modern de căutare semantică, niciun chatbot cu memorie, niciun asistent care îți găsește documentul potrivit din mii de fișiere nu ar funcționa.
De ce contează atât de mult lansarea Perplexity? Pentru că până acum, modelele bune de embedding erau fie uriașe și scumpe de rulat, fie mici și slabe. Rar găseai un echilibru. Iar Perplexity vine și spune: uite, avem ambele capete ale spectrului, iar cel mare e aproape de vârful absolut al performanței.
Să ne oprim puțin la modelul de 0,6B. E greu să subestimezi cât de mult contează un astfel de model pentru ecosistemul AI. Gândește-te la aplicațiile care trebuie să funcționeze offline, la dispozitivele cu resurse limitate, la scenariile în care trimiți date sensibile către un server extern și preferi să le procesezi local. Un embedding de 0,6B parametri poate rula pe un telefon modern fără să topească bateria, poate fi integrat în extensii de browser, în aplicații de notițe, în sisteme de căutare personală. E genul de model care democratizează accesul la AI semantic de calitate, fără să ceri utilizatorului un GPU de data center.
Apoi e monstrul de 9B. Aici discutăm de performanță pură. Scorul de 92,4% pe MADQA nu e un număr aruncat acolo ca marketing. MADQA — prescurtare de la Multilingual Adaptive Document Question Answering — testează capacitatea unui sistem de a înțelege documente complexe, de a extrage informația relevantă și de a răspunde corect la întrebări care necesită context extins. E un benchmark dur, care combină retrieval-ul cu raționamentul, și care nu iartă modelele slabe. Să treci de 90% înseamnă că modelul tău chiar știe să găsească acul în carul cu fân, indiferent de limbă sau de formatul documentului.
Interesant e că Perplexity a ales să lanseze ambele modele simultan, sub aceeași umbrelă pplx-embed-v2-late. E o strategie clară: acoperă atât piața enterprise, unde companiile vor precizie maximă și au infrastructură să ruleze modele mari, cât și piața consumer și edge, unde eficiența și confidențialitatea primează. Nu e o coincidență că numele sugerează o versiune „late” — probabil o iterație maturizată a unei arhitecturi anterioare, rafinată până la aceste rezultate.
Ce înseamnă asta pentru restul industriei? În primul rând, presiune pe OpenAI, Cohere, Voyage AI și alți jucători din spațiul embedding-urilor. Până acum, mulți dezvoltatori foloseau modele de embedding de la OpenAI sau open-source precum BGE sau E5. Apariția unui model Perplexity cu 92,4% pe MADQA schimbă calculele, mai ales dacă vine cu prețuri competitive sau cu acces prin API-ul lor existent. În al doilea rând, consolidează ideea că embedding-urile nu mai sunt un detaliu tehnic plictisitor, ci un câmp de bătălie strategic. Cine controlează embedding-urile bune controlează calitatea RAG-ului, iar RAG-ul e coloana vertebrală a aplicațiilor AI enterprise din 2025 încoace.
Există și o dimensiune mai subtilă, dar importantă: suveranitatea datelor. Un model de 0,6B care rulează local înseamnă că o companie europeană, de exemplu, poate construi un sistem de căutare semantică peste documentele interne fără să trimită nimic în afara infrastructurii proprii. Pentru sectoarele reglementate — sănătate, juridic, financiar — asta e mană cerească. Iar Perplexity, prin această lansare, se poziționează ca un furnizor care înțelege aceste nevoi, nu doar ca un startup care vinde vise.
Desigur, rămân întrebări. Cât de bine se comportă modelul de 0,6B pe limbi mai puțin reprezentate, cum ar fi româna? Cât de ușor e de integrat în framework-uri populare precum LangChain, LlamaIndex sau Haystack? Care sunt costurile reale la scară? Și, poate cel mai important, cât de deschisă e Perplexity la a publica greutățile modelului, având în vedere că titlul menționează „Open Source/Weights” ca una dintre categoriile site-ului. Dacă greutățile sunt disponibile, atunci impactul va fi și mai mare — comunitatea va putea face fine-tuning, va putea adapta modelul pentru nișe specifice, va putea construi deasupra lui.
Un alt aspect demn de remarcat e viteza cu care Perplexity își extinde portofoliul. Acum un an, compania era cunoscută mai ales pentru motorul său de răspunsuri cu citate. Acum are modele de embedding, are agenți AI, are integrare cu voice, are parteneriate. E o transformare de la produs unic la platformă, iar asta e exact traseul pe care l-au urmat și alții — OpenAI, Anthropic, Google — dar Perplexity o face cu o agilitate care îi surprinde pe mulți.
În final, ce rămâne de urmărit? Dacă modelul de 9B chiar livrează 92,4% pe MADQA în condiții reale, nu doar în laborator, atunci avem un nou standard pentru retrieval de înaltă precizie. Iar dacă modelul de 0,6B reușește să păstreze o calitate decentă pe dispozitive edge, atunci avem un instrument care poate schimba felul în care gândim aplicațiile AI locale. Perplexity tocmai a aruncat o mănușă serioasă în ring. Rămâne de văzut cine o ridică.
De ce este important:
Lansarea pplx-embed-v2-late nu e doar o veste tehnică pentru specialiști. E un semnal că piața embedding-urilor — infrastructura invizibilă care stă la baza aproape tuturor aplicațiilor AI moderne — intră într-o fază de maturizare accelerată. Un model de 9B care atinge 92,4% pe MADQA ridică ștacheta pentru întreaga industrie și forțează competitorii să vină cu soluții mai bune sau mai ieftine. Iar un model de 0,6B care poate rula la marginea rețelei deschide ușa către aplicații AI care respectă confidențialitatea, funcționează offline și nu depind de cloud. Pentru dezvoltatori, asta înseamnă mai multe opțiuni și mai multă libertate. Pentru companii, înseamnă posibilitatea de a construi sisteme RAG mai precise fără a-și ipoteca datele. Pentru utilizatorii obișnuiți, înseamnă că asistenții digitali vor înțelege mai bine ce caută, indiferent de limbă sau de dispozitiv. Pe scurt: Perplexity nu doar că își extinde portofoliul, ci contribuie la rescrierea regulilor jocului în zona cea mai puțin vizibilă, dar cea mai importantă, a AI-ului contemporan.