
Pentru ani de zile, paradigma dominantă a fost "Knowledge Distillation" (Distilarea Cunoștințelor): iei un GPT-4 sau un Llama-3-405B, generezi date, și antrenezi un model de 7B sau 1B parametri să predea distribuția de ieșire. Funcționează, dar are un defect fundamental, pe care orice inginer ML senior îl cunoaște: elevul devine o caricatură a profesorului. Învață să zică "da" când profesorul zice "da", dar nu învață de ce sau cum să razoneze când profesorul greșește sau când se află în teritoriul necunoscut. JOLT vine să spargă acest ciclu vicios.
Anatomia unei revoluții silencioase: Cum funcționează JOLT pe de fapt
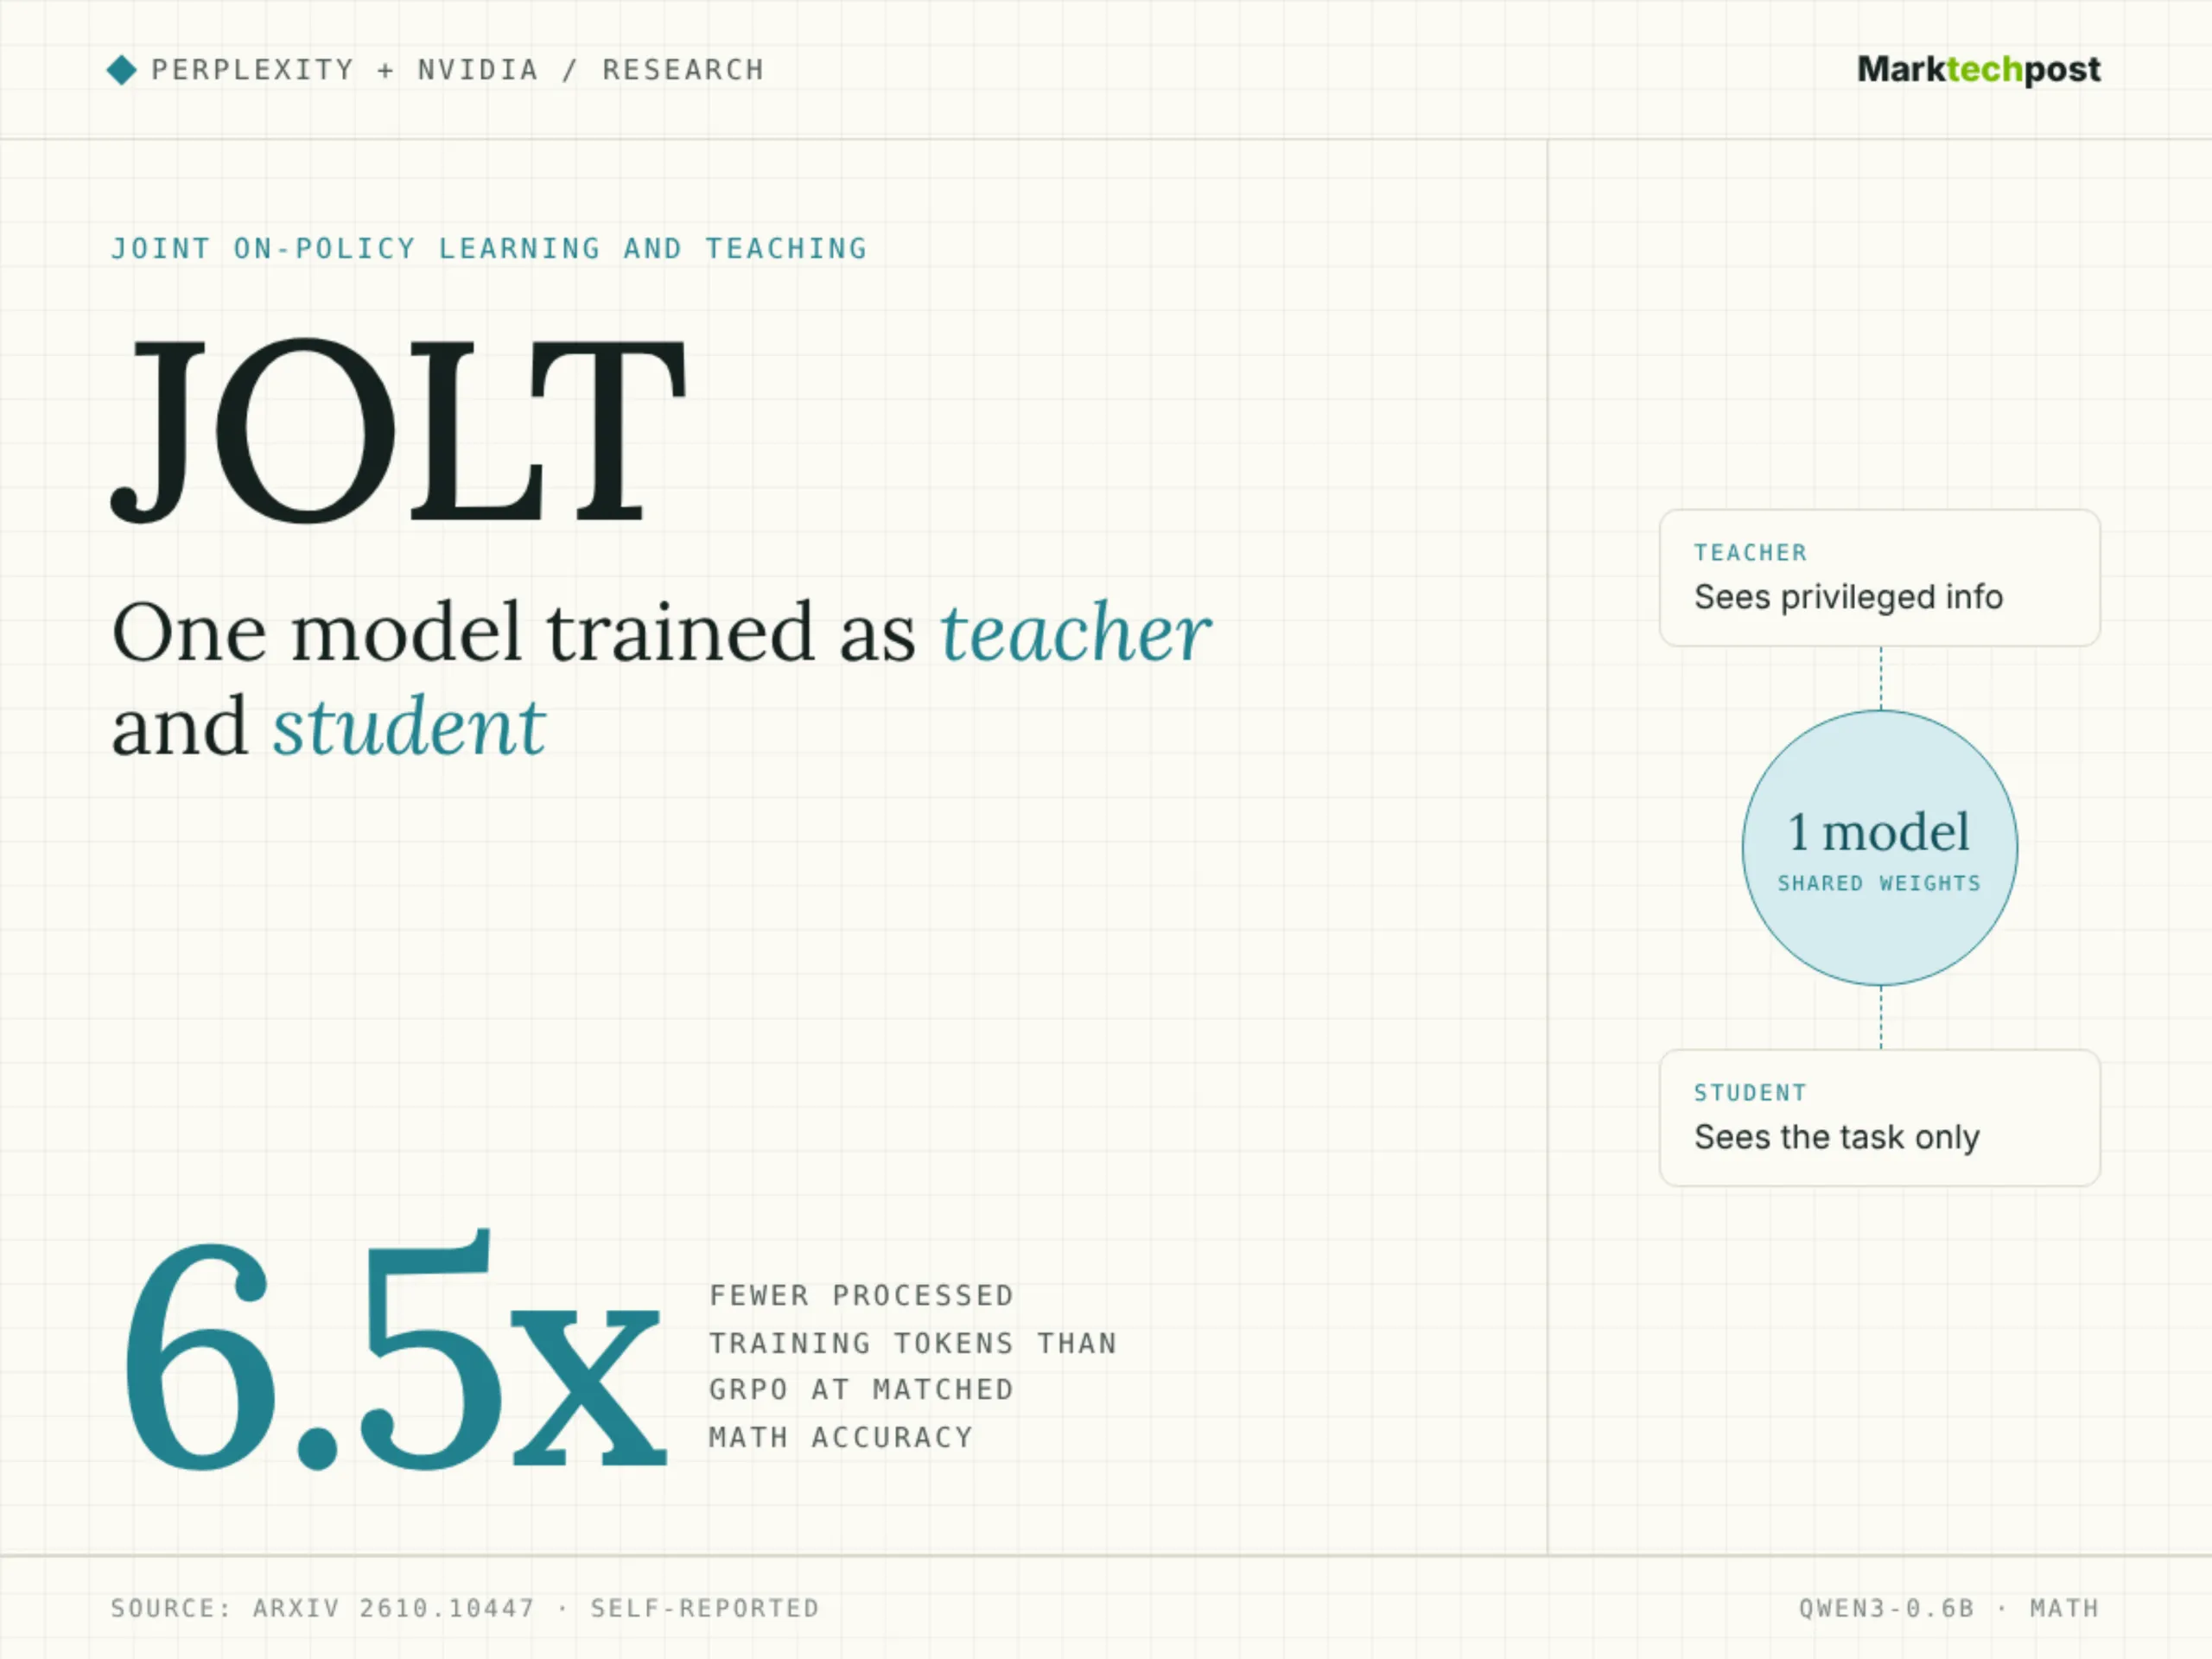
Numele "Joint Teacher-Student Reinforcement Learning" nu este doar marketing. Metoda introduce un buclă de retroacțiune bidirecțională (bidirectional feedback loop) în care profesorul nu este o entitate statică, congelată în timp (frozen weights), ci un agent activ care își actualizează strategia de predare bazându-se pe performanțele elevului. Este, dacă vrem să facem o analogie umană, diferența dintre un profesor care citește din curs pe powerpoint și un mentor care își ajustează explicația în timp real văzând expresia de pe fața elevului.
Tehnic, JOLT optimizează o funcție obiectiv comună. De obicei, în RLHF (Reinforcement Learning from Human Feedback), avem un model de recompensă (Reward Model) antrenat pe preferințe umane. Aici, inovația constă în faptul că semnalul de recompensă este co-generat. Modelul elev explorează spațiul soluțiilor, iar modelul profesor, printr-un mecanism de optimizare a politicii (policy optimization), învațe să ofere督导 (guidance) mai bun – fie prin generarea de raționamente intermediare (chain-of-thought) mai clare, fie prin selectarea unor exemple de antrenament (training samples) mai informative.
Colaborarea cu NVIDIA nu este întâmplătoare. Implementarea eficientă a unui astfel de algoritm necesită nu doar idei bune, ci și o inginerie de sistem de top. Antrenarea simultană a două modele mari (chiar dacă elevul e mic, profesorul e uriaș) cu gradient flow între ele este un capcană de memorie VRAM și de comunicare inter-GPU (NVLink/InfiniBand). Echipa NVIDIA a adus la masă optimizări la nivel de kernel fusion, gradient checkpointing selectiv și, probabil, utilizarea intensă a bibliotecilor Megatron-LM sau NeMo Aligner pentru a face acest lucru scalabil pe clustere de H100. Fără acest layer de inginerie hardware-software, JOLT ar fi rămâne o curiositate de laborator inaccesibilă majorității laboratoarelor.
De ce Perplexity? De ce acum?
Perplexity nu este o companie clasică de "foundation models" ca OpenAI sau Anthropic. Ei sunt un motor de răspuns (answer engine). Business-ul lor depinde de latentă, cost per query și acuratețe factuală. Ele nu au nevoie de un model de 400B parametri care costă o avere pe query; au nevoie de un model de 8B sau 14B care rulează pe un singur H100 (sau chiar pe A10G-uri mai vechi) și care razonează aproape la fel de bine pentru task-uri specifice: sumarizare, extracție de citate, reasoning multi-hop pe web.
JOLT este, în esență, moștenirea directă a nevoii lor de a "comprima" inteligența unui model frontier într-un pachet deployabil la scară industrială. Dar, spre deosebire de distilarea clasică (care degrada capacitățile de reasoning complex), JOLT păstrează procesul de gândire. Elevul nu memorizează răspunsurile; învață algoritmul de gândire a profesorului, deoarece profesorul este forțat să facă acest algoritm explicit și verificabil în cadrul buclei JOLT.
Implicații pentru Open Source și Comunitatea de Dezvoltatori
Acesta este punctul cel mai excitant pentru noi, cei care construim pe open weights. Dacă Perplexity și NVIDIA deschid codul (sau chiar doar weight-urile modelului elev antrenat cu JOLT), avem un blueprint pentru: "Cum să îți antrenezi propriul model de reasoning de top, folosind un model frontier ca profesor activ, pe hardware-ul tău".
Imaginează-ți scenariul: Ai acces la Llama-3.1-405B (profesorul) pe un cluster în cloud. Vrei un model de 8B specializat în analiză juridică română (elevul). Astăzi, faci distilare pe date sintetice. Mâine, cu JOLT, poți rula o buclă RL unde modelul de 8B încearcă să rezolve cazuri juridice complexe, profesorul de 405B îi notează pașii de raționament, își ajustează ghidajul, elevul își ajustează politica, și așa de câteva iterații. Rezultatul? Un model de 8B care nu doar "știe legea", ci razonează ca un jurist senior, dar costă 1/50 la inferență.
Riscurile? Sunt reale. Alignment tax (taxa de aliniere) poate crește: dacă profesorul are bias-uri subtile (și toate au), JOLT le poate amplifica prin bucla de retroacțiune. De asemenea, instabilitatea antrenamentului RL (reward hacking, mode collapse) este dublată aici de instabilitatea sistemului cu doi agenți. NVIDIA știe asta; de aceea paper-ul (sau raportul tehnic) va fi citit la microscop pentru detalii despre KL divergence constraints, PPO vs GRPO choices și teacher learning rate scheduling.
Verdictul: Un punct de cotitură pentru "Small Language Models"
Nu exagerăm dacă spunem că JOLT marchează trecerea de la era "Scale is all you need" la era "Alignment & Data Quality is all you need, facilitated by smart Teacher-Student dynamics". NVIDIA vinde GPU-uri, dar vinde și utilizare eficientă a GPU-urilor. Perplexity vinde răspunsuri rapide. Amândouă converg către același punct: modelele mici, antrenate inteligent, sunt motorul economic al AI-ului viitor.
Dacă JOLT ține promisiunile – și pedigree-ul autorilor sugerează că da –, vom vedea o explozie de modele "distilate activ" (actively distilled) pe Hugging Face în următoarele 6-12 luni. Comunitatea open source va fork-ui, va adapta pentru DPO/ORPO/KTO, va combina cu RLAIF (RL from AI Feedback).
Pentru mine, ca om care a văzut sute de paper-e care promit "SOTA pe benchmark-uri" și apoi eșuează în producție pe date reale, zgomotul făcut de JOLT sună diferit. Sună a inginerie, nu doar a științei. Sună a problemei reale: "Cum fac să rulez reasoning de calitate frontier pe un singur GPU?". Și răspunsul – o dansă sincronizată între un gigant și un pitic – este una pe care o voi urmări cu mare atenție, și pe care o recomand tuturor echipelor mele să o studieze profund.
De ce este important:
JOLT nu este doar o optimizare incrementala; este o schimbare de paradigma in antrenamentul modelelor mici (SLMs). Prin transformarea profesorului dintr-o entitate statica intr-un mentor activ care invata sa predea, Perplexity si NVIDIA adreseaza talpa de Achiles a distilarii clasice: pierderea capacitatilor de reasoning complex. Pentru industrie, asta inseamna drastica reducere a costurilor de inferenta fara compromitere a calitatii, democratizand accesul la AI avansat. Pentru dezvoltatori, ofera un cadru tehnic replicabil pentru a crea modele specializate de inalta performanta pe hardware accesibil. Este momentul in care "modelul mic" devine viabil comercial nu prin compromis, ci prin arhitectura superioara a procesului de invatare.