Diferența fundamentală dintre antrenament și inferență
Tradițional, conversațiile despre infrastructură AI s-au centrat pe procesul intensiv de calcul al antrenării unui model. Antrenamentul este finit: o rulare începe, consumă resurse de calcul și se termină. Dar inferența rulează continuu, de fiecare dată când un model răspunde la un prompt. Pentru planificarea infrastructurii, această diferență este crucială: o rulare de antrenament este un proiect pe care îl poți bugeta și închizi. Inferența nu se retrage niciodată; fiecare cerere de inferență lasă ceva în urmă.
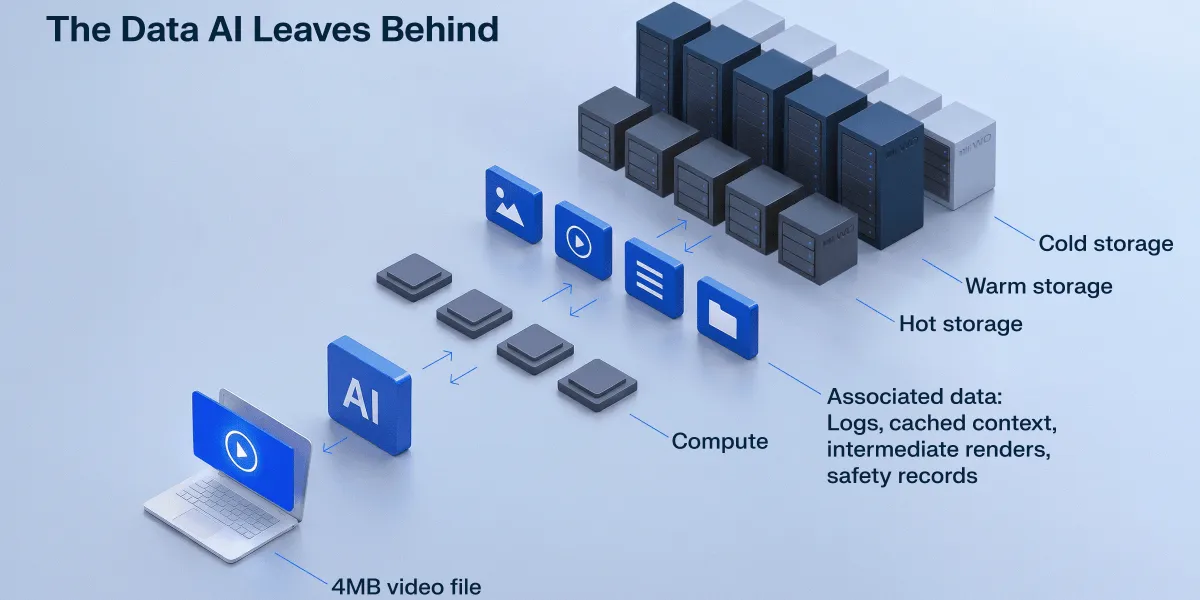
Luăm exemplul videoclipurilor generate de AI. În acest tip de sarcină, cheltuielile pe back-end pot fi semnificative. Conform măsurărilor interne efectuate de Western Digital (WD), un clip de 8 secunde (returnat utilizatorului ca un fișier de 3,97 MB la 720p) lăsa în urmă mai mult de 500 MB de date asociate pe back-end, inclusiv log-uri, context în cache, redări intermediare, backup-uri și înregistrări de siguranță. Aceasta înseamnă o creștere de 130 de ori față de dimensiunea fișierului de ieșire pe care utilizatorul îl vede. Scalând acest lucru la o întreprindere care generează videoclipuri mai lungi, la rezoluții mai înalte, amprenta pe back-end crește la sute de gigaocteți per clip.
Și această amprentă crește accelerat. McKinsey proiectează că cererea de inferență AI va crește la un ritm anual compus (CAGR) de 35% până în 2030, versus 22% pentru antrenament, ajutând să reprezinte mai mult de 40% din cererea totală a centrelor de date până la sfârșitul deceniului. Un studiu global IDC, sponsorizat de WD, care a sondat 763 de decisori IT și de business, a revelat că aproape 95% din respondenți au raportat o creștere a volumului datelor din cauza AI-ului generativ în ultimii 12 luni, iar aproximativ 61% au raportat o creștere de 25% sau mai mult.
"Poți gândi stocarea suplimentară ca o optimizare pentru a menține GPU-urile ocupate", a declarat un manager senior de produs al unui furnizor major de cloud, citat în raport. "Cea mai mare provocare este să te asiguri că GPU-urile nu stau inactive, așteptând date — ore de timp inactiv al GPU-urilor devine foarte scump, foarte repede."
Economia ascunsă: Stocarea vs. Calculul
Tradus în termeni financiari: dacă cheltuielile cu stocarea cresc 25% an de an, în timp ce bugetul de calcul crește într-un mod ciclic și mai predictibil, stocarea ajunge să depășească linia bugetară care primește cea mai multă atenție. Cererea de calcul crește și scade cu ciclurile de antrenament, lansările de produse și reîmprospătarea hardware-ului. Dar volumul datelor reținute nu scade când cererea de calcul încetinește. Log-urile modelelor, ieșirile sintetice, rezultatele inferenței și multe altele continuă să se acumuleze, iar organizațiile țin minte volume tot mai mari de date, pentru perioade tot mai lungi.
Acest lucru schimbă rolul datelor reținute. Informațiile care odată migrau în arhive și rar refăceau suprafața pot deveni acum intrări pentru viitoare sarcini AI. Pe măsură ce se rețin, recuperează și reutilizează mai multe date, stocarea trebuie să susțină nu doar capacitate crescută, ci și acces dinamic tot mai intens. Același sondaj WD-IDC a găsit că 96% din respondenți anticipează nevoia de recuperare mai rapidă a arhivelor pentru a susține inferența sau generarea augmentată prin recuperare (RAG).
Sarcinile AI necesită atât performanță, cât și capacitate, cu tehnologii diferite care servesc nevoi diferite în ciclul de viață al datelor. Și pentru volumele uriașe de date care trebuie reținute și revizuite, HDD-urile (hard disk drives) oferă o fundație de capacitate mare, cost-eficientă, cu un avantaj semnificativ al costului per teraoctet.
Ce înseamnă asta pentru bugetarea AI-ului
Pentru un CFO sau CIO, acest lucru înseamnă că "cheltuielile de infrastructură AI" pot fi definite prea îngust pe calcul. Un model care stă inactiv în timp ce datele se încarcă costă cam la fel ca unul care stă inactiv din lipsa unui GPU. Dar strangularea stocării rămâne ascunsă până devine deja o problemă, suprafațând în costuri operaționale și întârzieri la recuperare, nu într-o linie CapEx lângă acceleratoare.
Considerați un retailer care generează videoclipuri AI de produse pentru catalog, sau un asigurător care procesează documente de sinistre printr-un pipeline RAG pentru susținere mai rapidă. În ambele cazuri, costul de calcul este o cantitate cunoscută, bugetată: o rată per generație sau per interogare pe care finanțele o pot previziona. Costul stocării este diferit: se compune cu fiecare videoclip generat și fiecare dosar procesat, pentru că niciuna dintre acele date de back-end nu dispare odată terminată sarcina.
O echipă care bugetează AI ca pe "calcul plus o eroare de rotunjire pentru stocare" poate descoperi, în 12-18 luni, că eroarea de rotunjire a devenit o fracție semnificativă a costului total al programului — tocmai în momentul în care conducerea decide dacă se extinde sau nu.
Adresarea acestei provocări începe cu arhitectura. Strategia de stocare tinde să fie proiectată pentru performanța costisitoare a tier-ului "cald" (pentru date accesate instantaneu și constant), în timp ce majoritatea datelor AI, ca volum, se acumulează în tier-urile "calde", "reci" și "înghețate" de din spate. Ce au nevoie întreprinderile este capacitate economic scalabilă: Infrastructură proiectată pentru întregul ciclu de viață al datelor AI, echilibrând performanța cu capacitatea, puterea, fiabilitatea și costul total de deținere (TCO) pe măsură ce datele persistă, se compun și sunt din ce în ce mai mult reutilizate.
Aceasta înseamnă a trata arhivele care odată stăteau netăiate ca active active pentru RAG și inferență, și a seta politici de reținere bazate pe valoarea strategică crescută a datelor, nu pe costul lor original de stocare. Înseamnă, de asemenea, a recunoaște că deciziile despre stocare se joacă la nivel de flote, nu de unități individuale. O astfel de infrastructură necesită tier-uri de stocare, unde consumul de putere individualizat, fiabilitatea, densitatea și eficiența operațională determină toate dacă sistemul rămâne economic sustenabil pe măsură ce capacitatea se scalează.
Există trei întrebări critice pe care organizația ta trebuie să le adreseze în bugetul de infrastructură AI:
1. Știm exact câte date de back-end generează fiecare workload de inferență (log-uri, cache, versiuni intermediare, date de siguranță) și cum crește acest raport față de output-ul final?
2. Avem o strategie de tiering care mută datele automat pe HDD-uri de capacitate mare pentru arhivare activă, eliberând SSD-urile costisitoare doar pentru datele "calde" de inferență în timp real?
3. Modelul nostru de cost total de deținere (TCO) include costul de oportunitate al GPU-urilor inacte din cauza latentei stocării, sau doar prețul de achiziție al discurilor?
Majoritatea organizațiilor nu pot răspunde cu încredere la toate cele trei. Acesta este golul care merită închis înainte de următorul ciclu bugetar, nu după.
De ce este important:
În cursa de a cumpăra GPU-uri, companiile uită că inferența e un motor care nu se oprește niciodată, iar exhaust-ul său — datele de back-end — se acumulează exponențial. Ignorarea costului real al stocării (nu doar $/TB, ci $/GPU-hour pierdut așteptând date) transformă un proiect AI din investiție strategică într-un grop financiar necontrolat. Viitorul nu apartine celor cu cele mai multe GPU-uri, ci celor care au arhitectura de date care le hrănește continuu, ieftin și rapid. HDD-urile nu sunt "tehnologie veche"; sunt fundamentul economic al AI-ului la scară.