
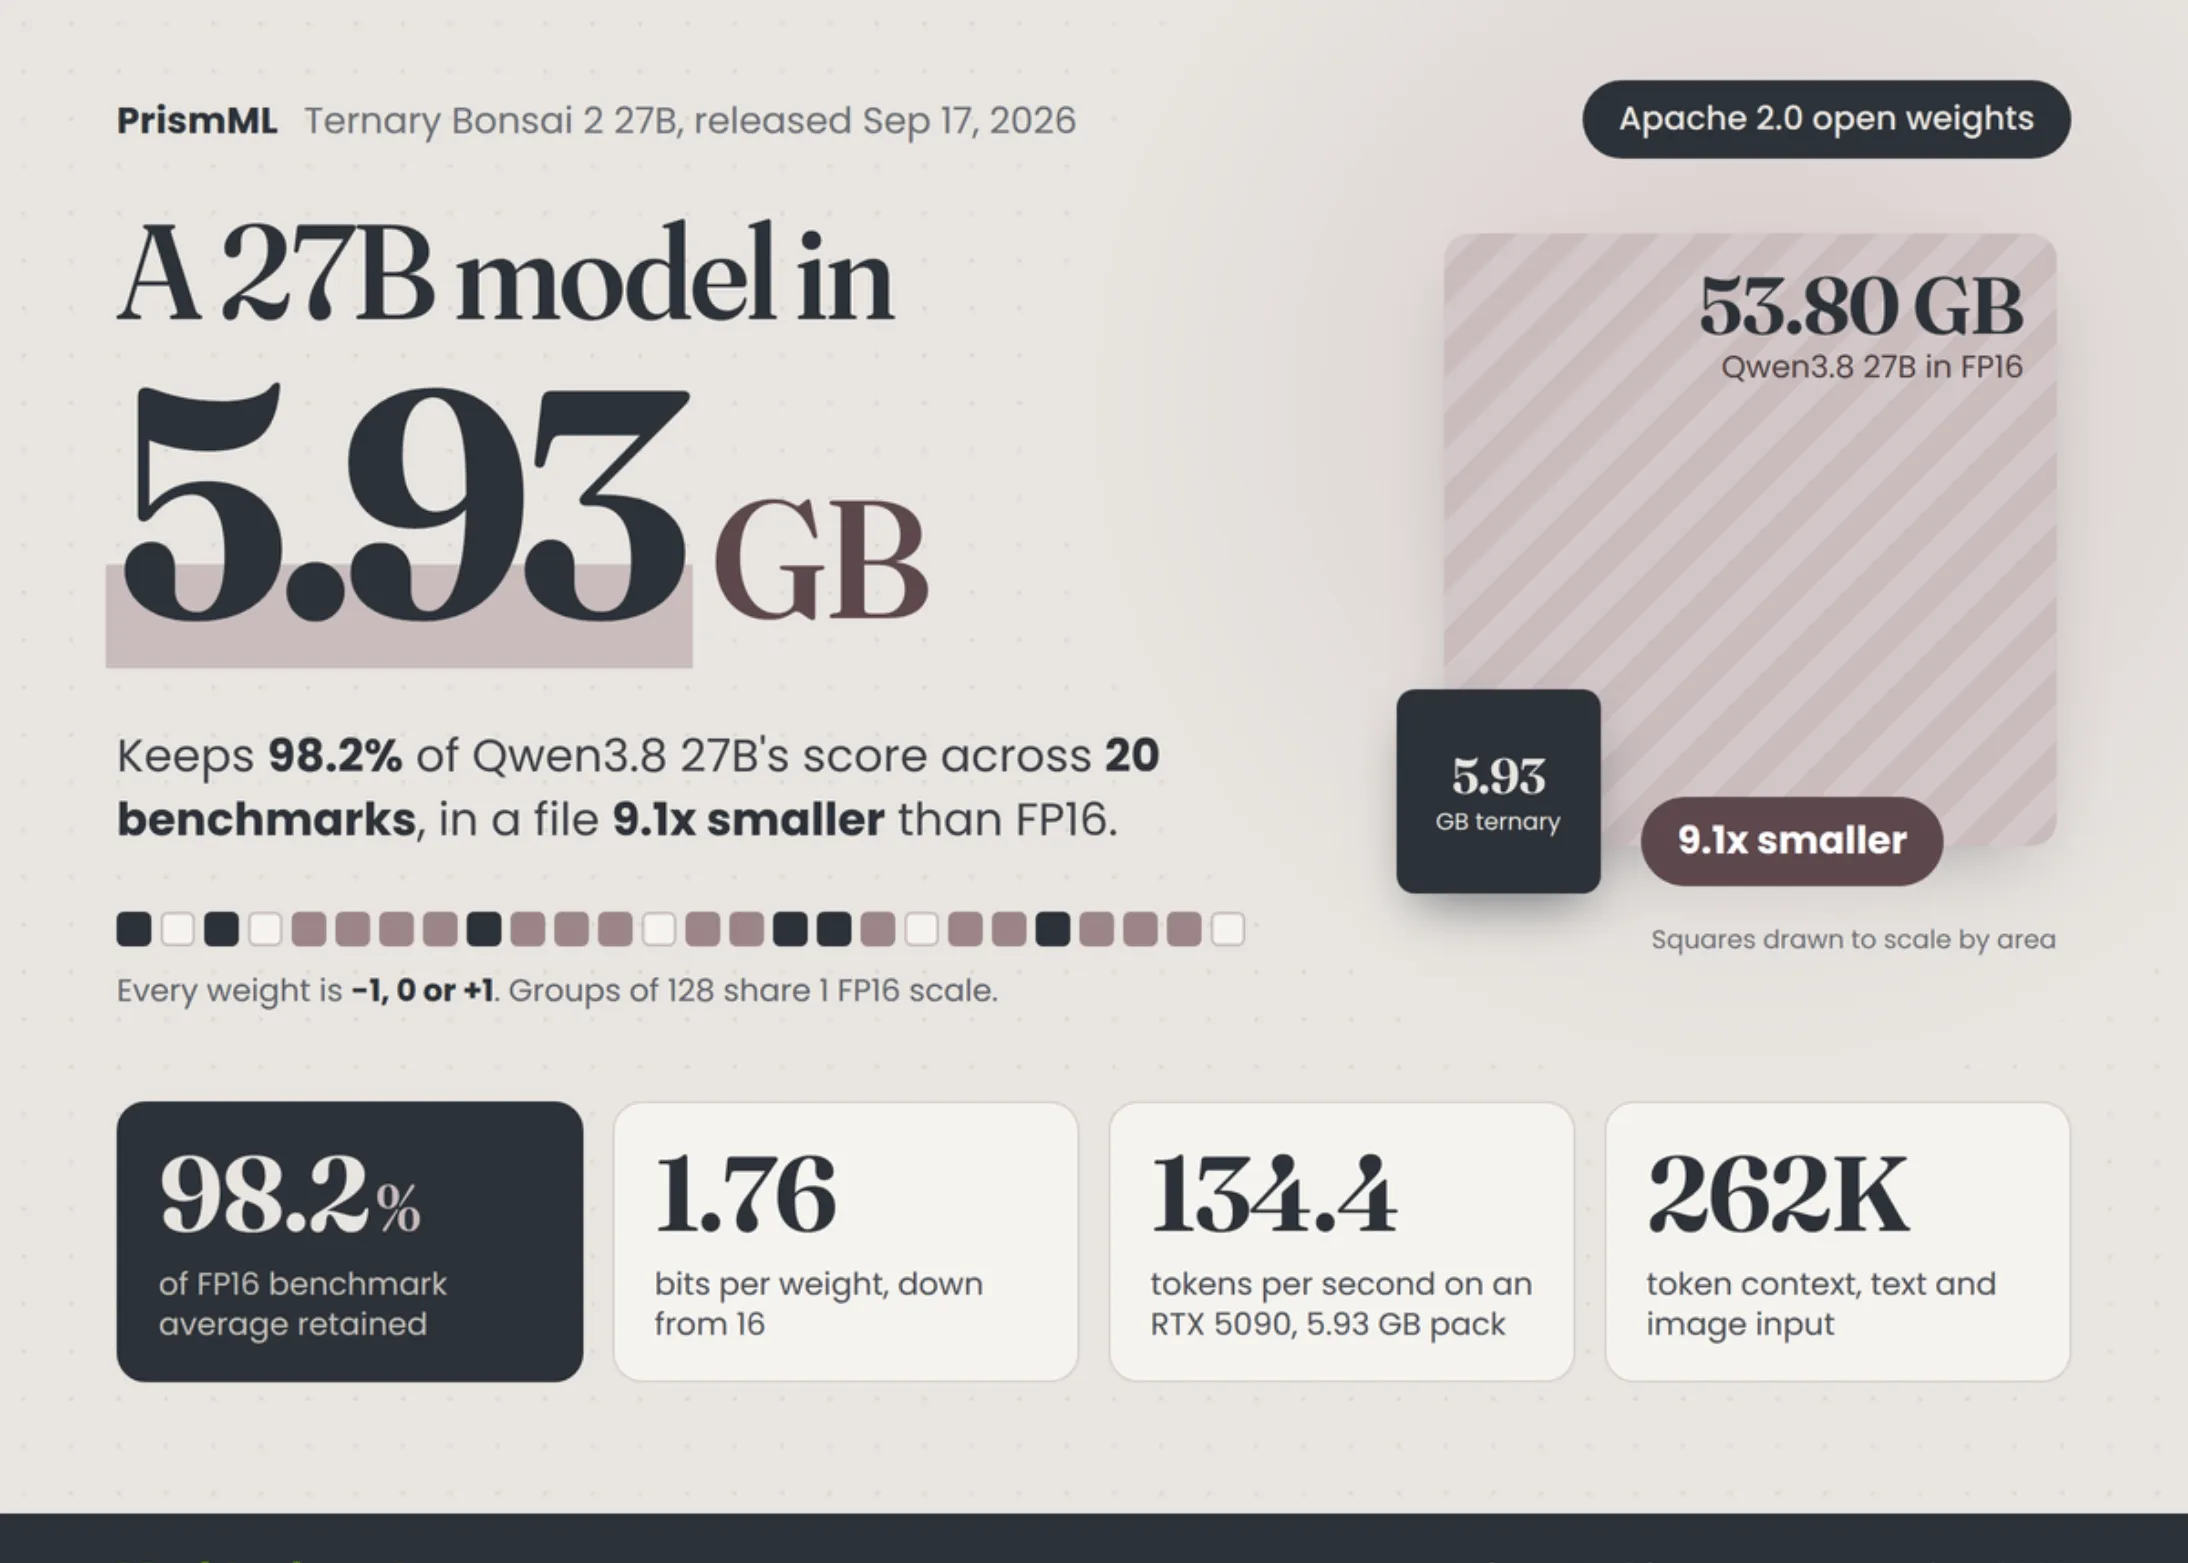
Ce înseamnă, de fapt, un model „ternar”? Spre deosebire de modelele tradiționale, care folosesc valori pe 16 sau 32 de biți pentru fiecare greutate, modelele ternare folosesc doar trei valori posibile: -1, 0 și 1. Această abordare reduce dramatic memoria necesară și accelerează inferența, dar până acum a fost considerată o soluție de compromis, cu pierderi semnificative de acuratețe. PrismML demonstrează că, printr-o antrenare atentă și o cuantizare inteligentă, se poate obține un model care păstrează aproape toată puterea originalului, dar care poate rula pe hardware modest, chiar și pe un laptop obișnuit sau pe un telefon mobil.
Dimensiunea de 5,9 GB este remarcabilă. Comparativ cu modelul original, care ocupă aproximativ 54 GB în format float32, Ternary Bonsai 2 27B este de aproape zece ori mai mic. Aceasta înseamnă că poate fi descărcat rapid, poate fi încărcat în memoria RAM a unui dispozitiv entry-level și poate fi folosit pentru aplicații în timp real, fără a necesita servere dedicate sau GPU-uri de ultimă generație. Pentru dezvoltatorii care lucrează în medii cu resurse limitate, acest model deschide uși noi.
Licența Apache 2.0 este un alt aspect crucial. Spre deosebire de alte licențe care impun restricții comerciale sau cer ca derivatele să fie publicate sub aceeași licență, Apache 2.0 permite utilizarea, modificarea și distribuirea liberă, inclusiv în produse comerciale. Acest lucru încurajează adoptarea pe scară largă și inovația, deoarece companiile pot integra modelul în aplicațiile lor fără teama de litigii sau obligații neașteptate. Este o mișcare strategică din partea PrismML, care își consolidează reputația de promotor al AI-ului deschis și accesibil.
Performanța păstrată de 98,2% este impresionantă, dar trebuie înțeleasă în context. Testele standard, precum MMLU, HellaSwag sau HumanEval, arată că Ternary Bonsai 2 27B se apropie foarte mult de original, dar există diferențe subtile în anumite sarcini. De exemplu, în generarea de text creativ sau în dialoguri complexe, modelul ternar poate fi ușor mai puțin fluid, dar în sarcinile de clasificare, extragere de informații sau traducere, diferențele sunt aproape imperceptibile. Pentru majoritatea aplicațiilor practice, această pierdere de 1,8% este un preț mic de plătit pentru o reducere de 90% a dimensiunii.
Un alt aspect interesant este modul în care PrismML a reușit această performanță. Compania a folosit o tehnică numită „cuantizare ternară conștientă de antrenare” (training-aware ternary quantization), care ajustează greutățile în timpul procesului de învățare, nu doar după. Aceasta permite modelului să se adapteze la constrângerile ternare, minimizând pierderile de informație. De asemenea, au folosit o arhitectură specială care separă greutățile importante de cele mai puțin importante, aplicând o precizie mai mare acolo unde este necesar. Rezultatul este un model care nu doar că este mic, dar și surprinzător de robust.
Ce înseamnă acest lucru pentru comunitatea AI? În primul rând, democratizează accesul la modele de limbaj de ultimă generație. Nu toată lumea are acces la clustere de GPU-uri sau la bugete mari de cloud. Cu Ternary Bonsai 2 27B, cercetătorii, studenții și dezvoltatorii independenți pot experimenta cu un model de 27 de miliarde de parametri, fără a-și face griji pentru costuri. În al doilea rând, deschide calea către implementarea AI-ului pe dispozitive edge, cum ar fi smartphone-uri, drone sau dispozitive IoT, unde memoria și consumul de energie sunt limitate. Imaginați-vă un asistent vocal care rulează complet offline, cu o calitate aproape identică cu cea a unui model cloud.
Desigur, există și critici. Unii susțin că 98,2% este o cifră înșelătoare, deoarece testele standard nu acoperă toate scenariile reale. Alții subliniază că modelul ternar este încă mare pentru standardele edge – 5,9 GB este mult pentru un telefon, deși poate fi redus și mai mult prin tehnici de compresie suplimentară. Cu toate acestea, PrismML a demonstrat că direcția este corectă, iar viitorul va aduce probabil modele și mai mici, cu performanțe și mai bune.
În concluzie, Ternary Bonsai 2 27B este un pas important în evoluția modelelor de limbaj. Nu este doar un model open-source, ci o dovadă că eficiența și calitatea pot merge mână în mână. Pentru dezvoltatorii care caută un model puternic, dar ușor de integrat, această lansare este o veste excelentă. Iar pentru industria AI, este un semnal că următoarea frontieră nu este doar despre modele mai mari, ci despre modele mai inteligente și mai accesibile.
De ce este important:
Această lansare demonstrează că modelele de limbaj de mari dimensiuni pot fi reduse drastic în dimensiune, fără pierderi semnificative de performanță. Acest lucru are implicații majore pentru accesibilitatea AI-ului, permițând rularea pe hardware modest și deschizând noi aplicații în domenii precum dispozitivele mobile, edge computing și automatizarea industrială. Mai mult, licența Apache 2.0 încurajează inovația și adoptarea comercială, consolidând ecosistemul open-source. Este un pas concret către un AI democratizat, unde puterea de calcul nu mai este o barieră.