Subiect: #Model de limbaj
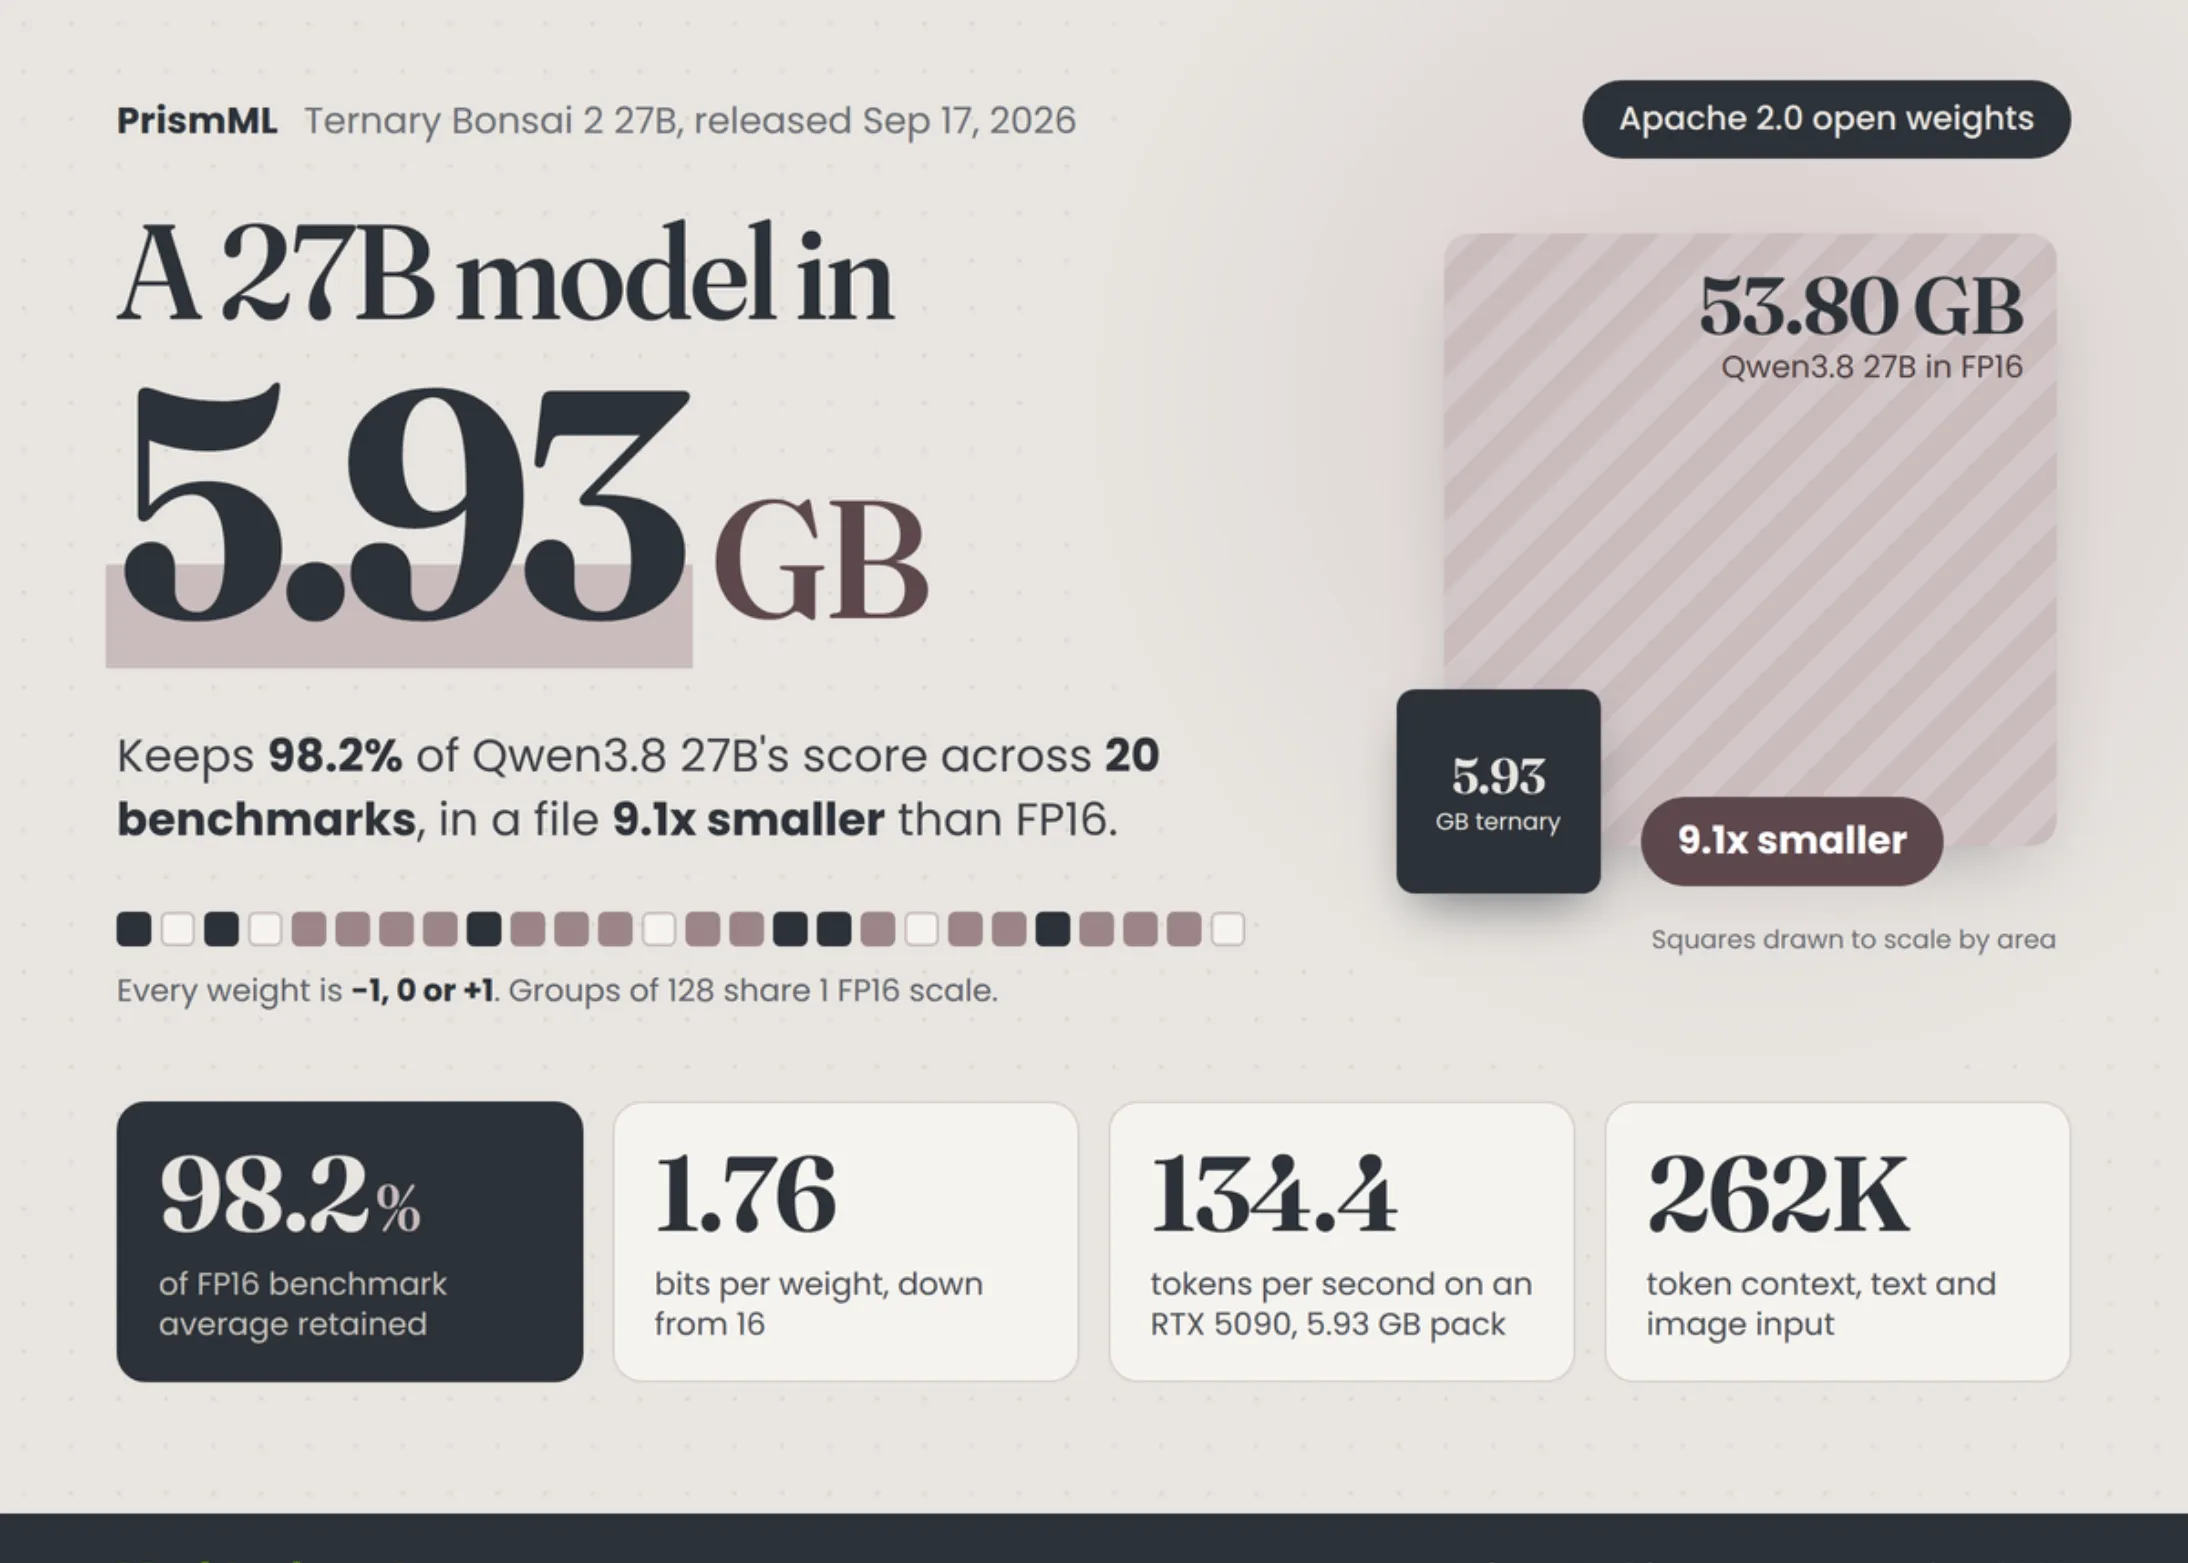
PrismML lansează Ternary Bonsai 2 27B: un model Apache 2.0 de doar 5,9 GB care păstrează 98,2% din performanța Qwen3.8 27B
PrismML a lansat Ternary Bonsai 2 27B, un model de limbaj de doar 5,9 GB, cu licență Apache 2.0, care păstrează 98,2% din performanța Qwen3.8 27B. Această inovație demonstrează că modelele ternare pot fi atât eficiente, cât și precise, deschizând calea către AI accesibil pe dispozitive cu resurse limitate.
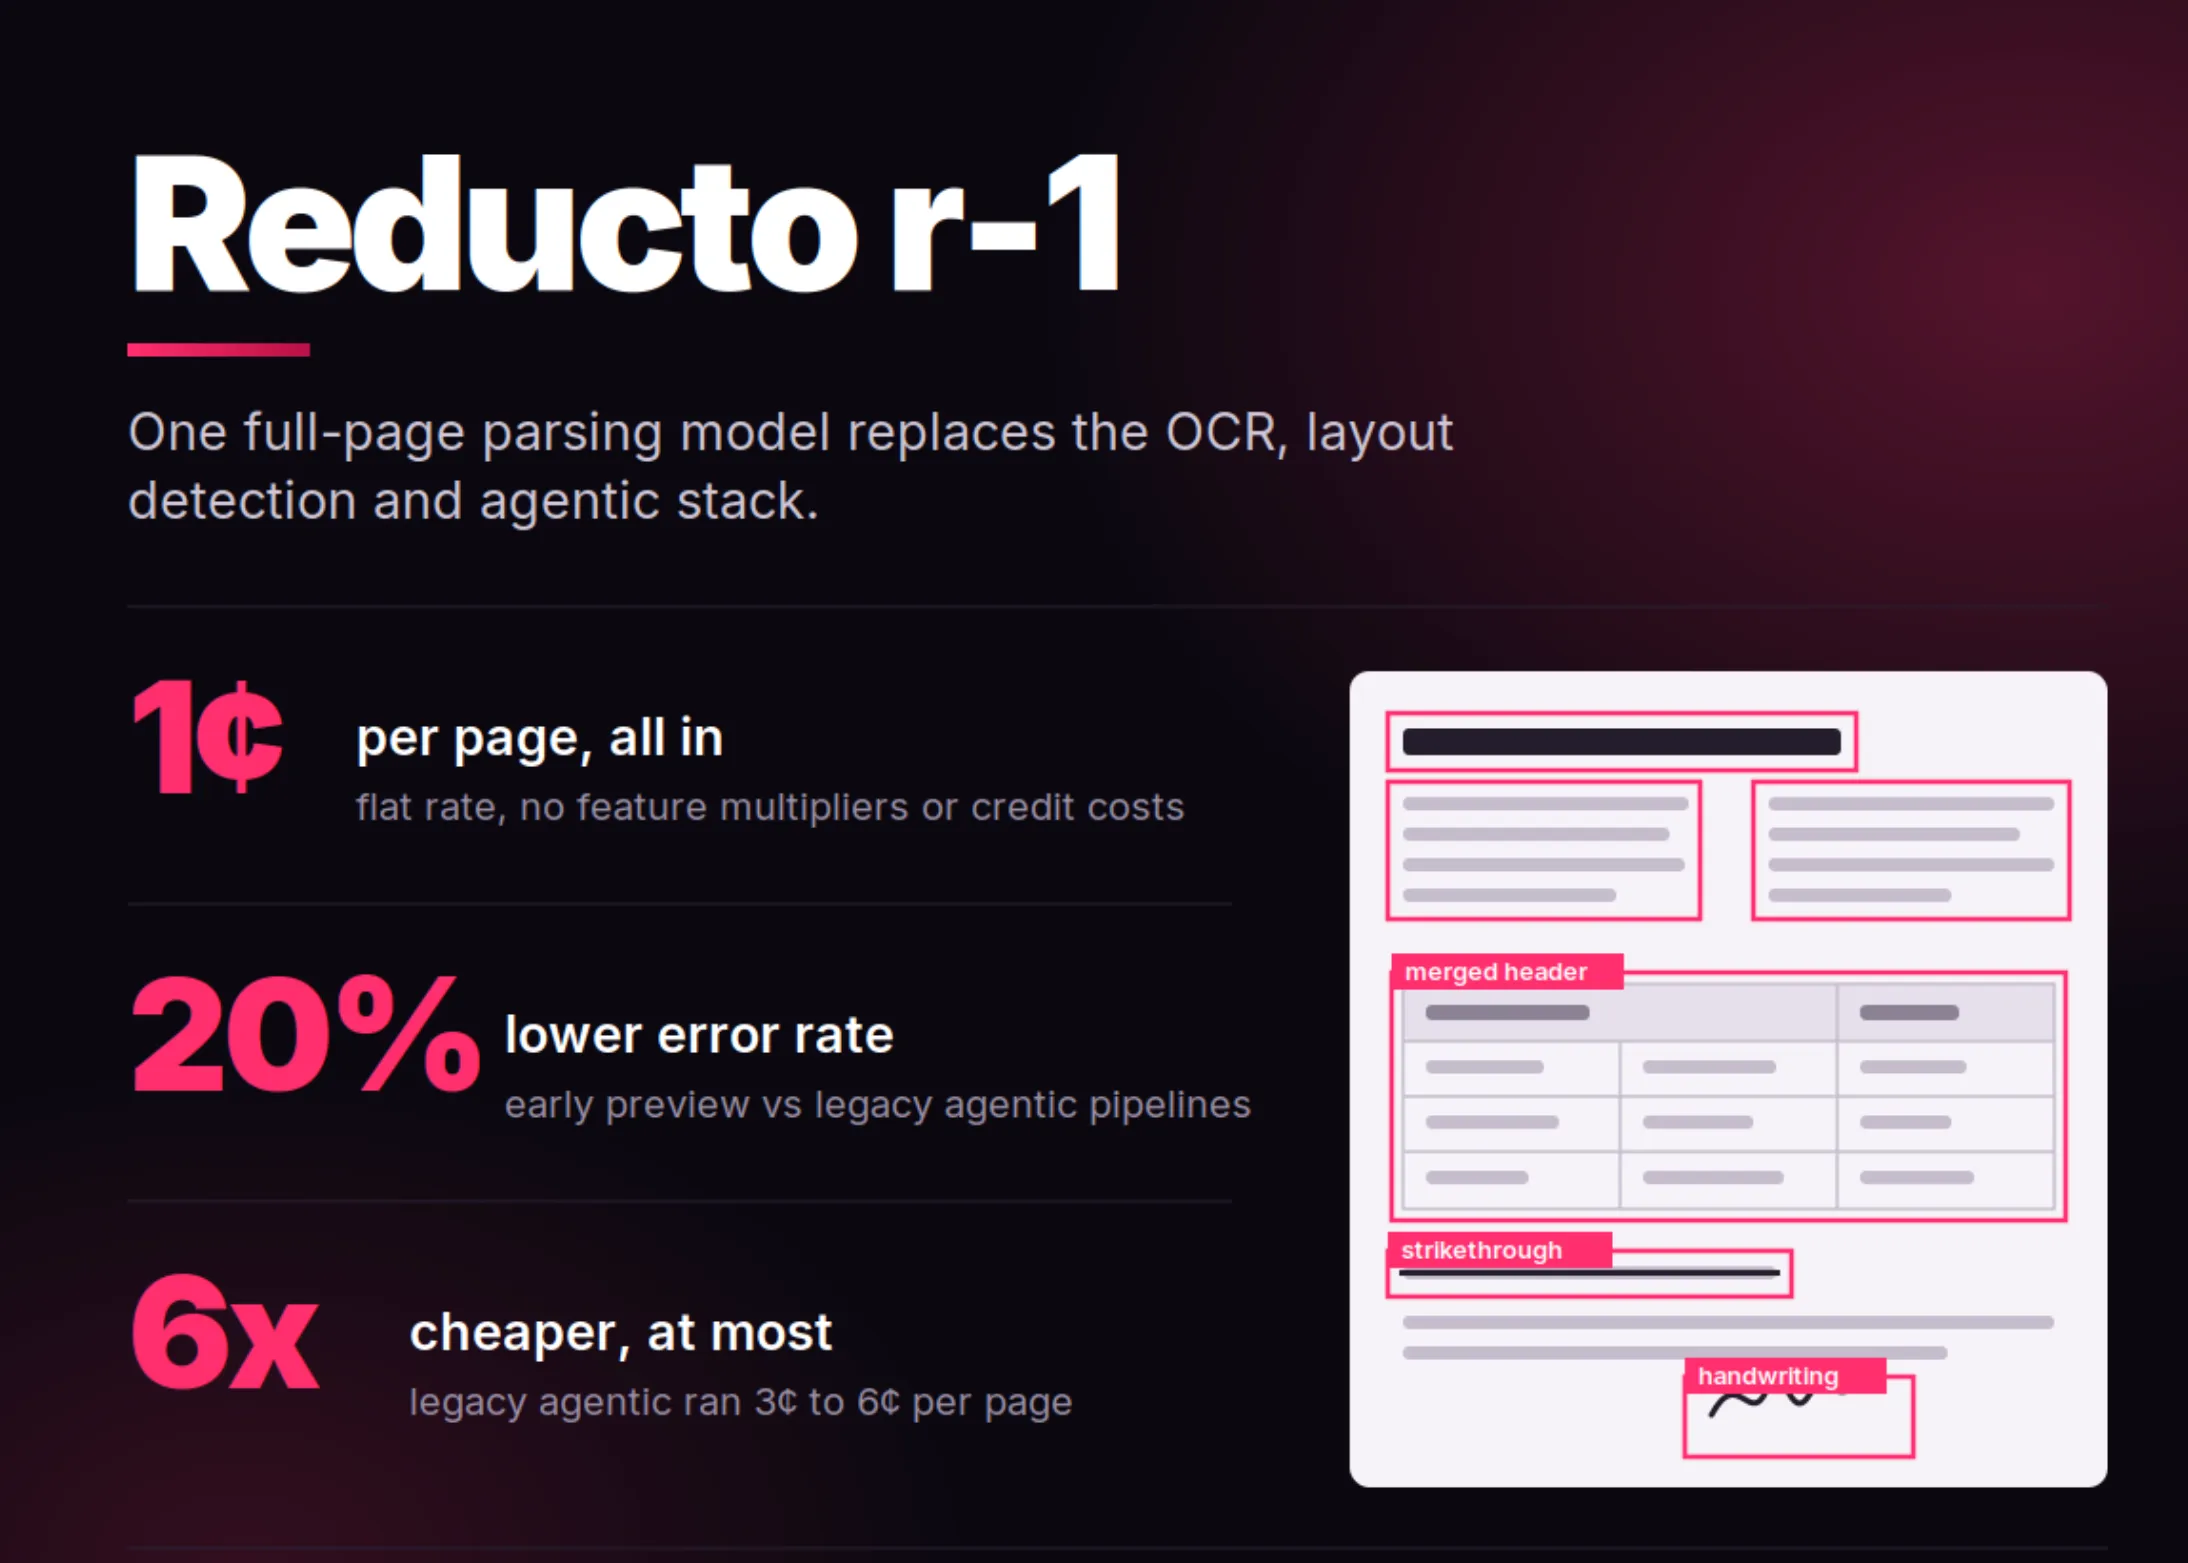
Reducto lansează r-1: model de parsare documentară într-o singură trecere, cu 20% mai puține erori la un cent pe pagină
Reducto a lansat r-1, un model de parsare documentară într-o singură trecere, care reduce erorile cu 20% și costă doar un cent pe pagină. O soluție accesibilă și performantă pentru extragerea datelor din documente, esențială pentru aplicațiile AI moderne.

SpaceXAI lansează Grok 4.6: modelul frontieră cu context de 500K, optimizat pentru agenți de lungă durată, programare și muncă intelectuală
SpaceXAI lansează Grok 4.6, un model de tip frontieră cu context de 500K tokeni, optimizat pentru agenți autonomi de lungă durată, programare și muncă intelectuală. Descoperă cum această lansare redefinește standardele în inteligența artificială și ce înseamnă pentru dezvoltatori și companii.

Microsoft lansează MAI-Cyber-1-Flash: modelul AI cu 5 miliarde de parametri activi care atinge 95,95% pe CyberGym
Microsoft a lansat MAI-Cyber-1-Flash, un model AI specializat în securitate cibernetică, cu doar 5 miliarde de parametri activi, care atinge 95,95% pe benchmark-ul CyberGym. Eficient, open-source și gata de implementare on-premise, modelul promite să revoluționeze apărarea cibernetică.

SpaceXAI lansează Grok 4.5: modelul antrenat pe Cursor pentru codare, sarcini agentice și muncă de cunoaștere, la doar 2 dolari per milion de tokeni de intrare
SpaceXAI a lansat Grok 4.5, un model de limbaj antrenat pe Cursor, specializat în codare, sarcini agentice și muncă de cunoaștere, la un preț de doar 2 dolari per milion de tokeni de intrare. Articolul analizează performanțele, comparațiile cu concurența și impactul asupra pieței AI.

Google lansează DiffusionGemma: un model open-source de 26 de miliarde de parametri care generează text de 4 ori mai rapid
Google a lansat DiffusionGemma, un model open-source de 26 de miliarde de parametri care folosește difuzia textuală pentru a genera text de până la 4 ori mai rapid decât modelele tradiționale. Acest model inovator promite să revoluționeze generarea de text, oferind viteză și eficiență sporite, fiind disponibil gratuit pentru comunitatea AI.
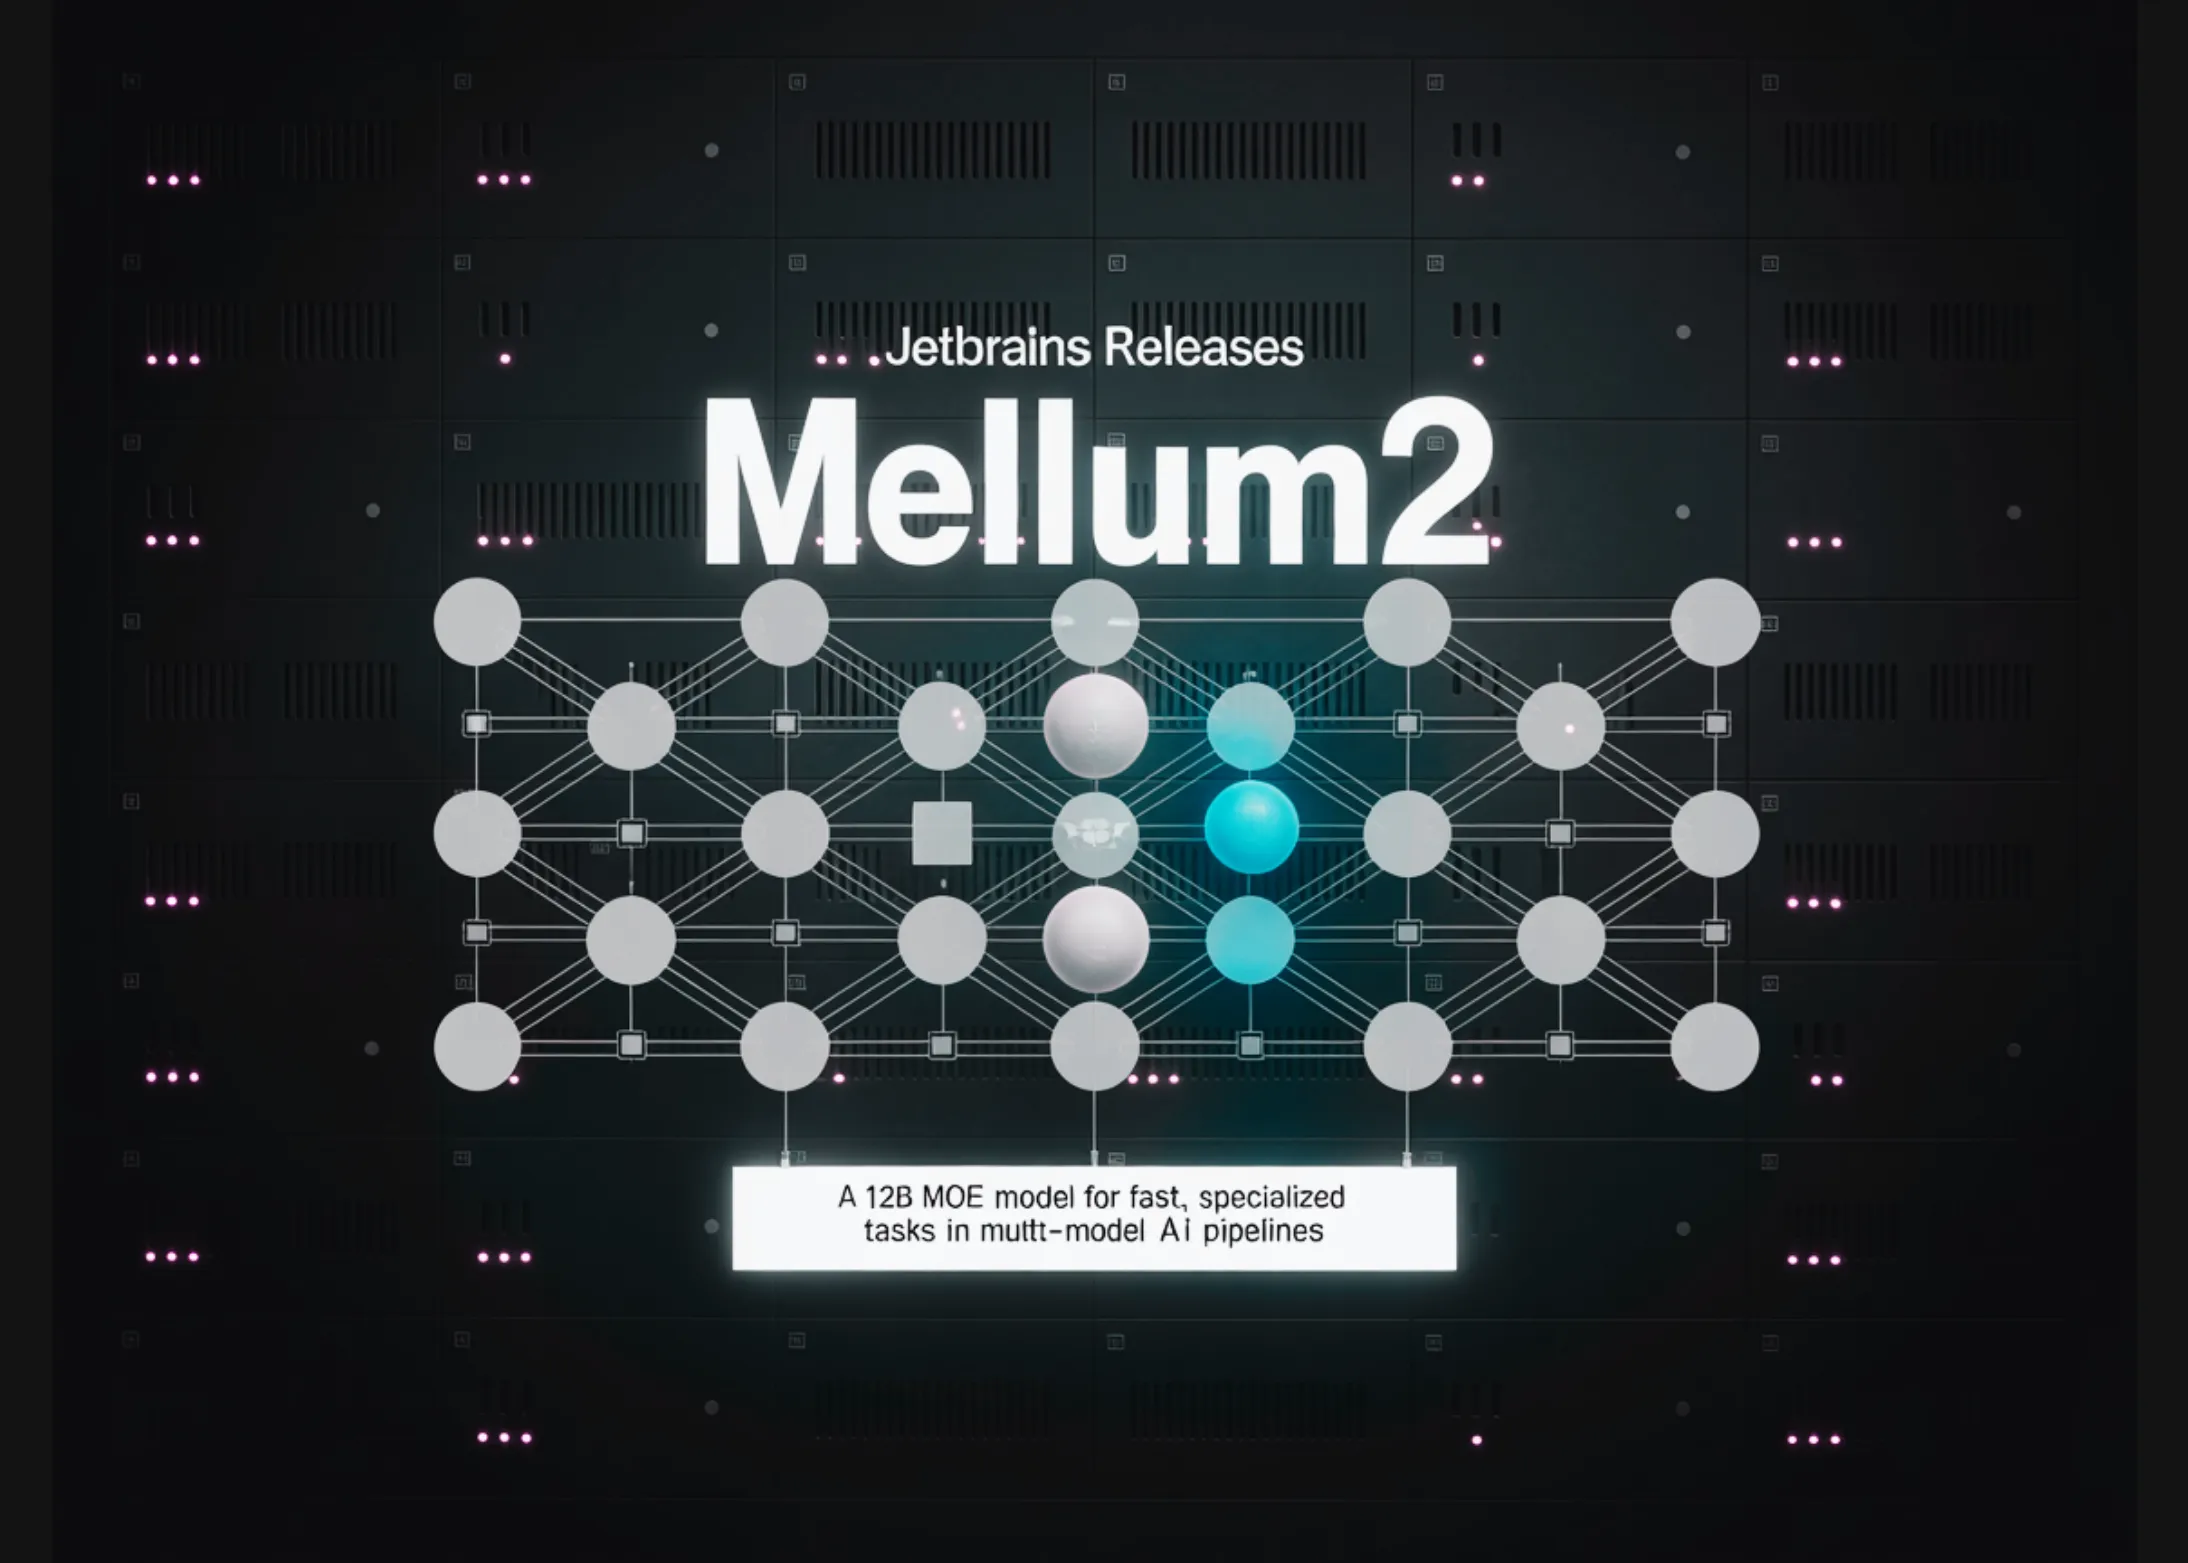
JetBrains lansează Mellum2: modelul de 12 miliarde de parametri care promite să schimbe regulile jocului în conductele AI multimodel
JetBrains a lansat Mellum2, un model MoE de 12 miliarde de parametri, conceput pentru sarcini rapide și specializate în conductele AI multimodel. Articolul analizează arhitectura, poziționarea competitivă și impactul asupra dezvoltatorilor.
NVIDIA lansează Nemotron-Labs-Diffusion: un model de limbaj cu trei moduri de decodare și de 6 ori mai multe tokenuri per pas față de Qwen3-8B
NVIDIA a lansat Nemotron-Labs-Diffusion, o familie de modele de limbaj care combină trei moduri de decodare (autoregresiv, difuziune paralelă și auto-speculație) într-o singură arhitectură. Disponibil în variante de 3B, 8B și 14B parametri, modelul oferă de 6 ori mai multe tokenuri per pas decât Qwen3-8B, menținând o calitate comparabilă. Articolul analizează inovația, performanța și aplicațiile practice.

OpenAI lansează GPT-5.5 Instant: noul model implicit pentru ChatGPT
OpenAI a lansat GPT-5.5 Instant, noul model implicit pentru ChatGPT, care reduce halucinațiile în domenii sensibile și îmbunătățește gestionarea contextului, inclusiv accesul la conversații anterioare și Gmail. Modelul obține scoruri mai bune la teste de matematică și raționament, dar vine și cu provocări legate de tranziția de la modelele anterioare, având în vedere reacțiile negative la retragerea GPT-4o.