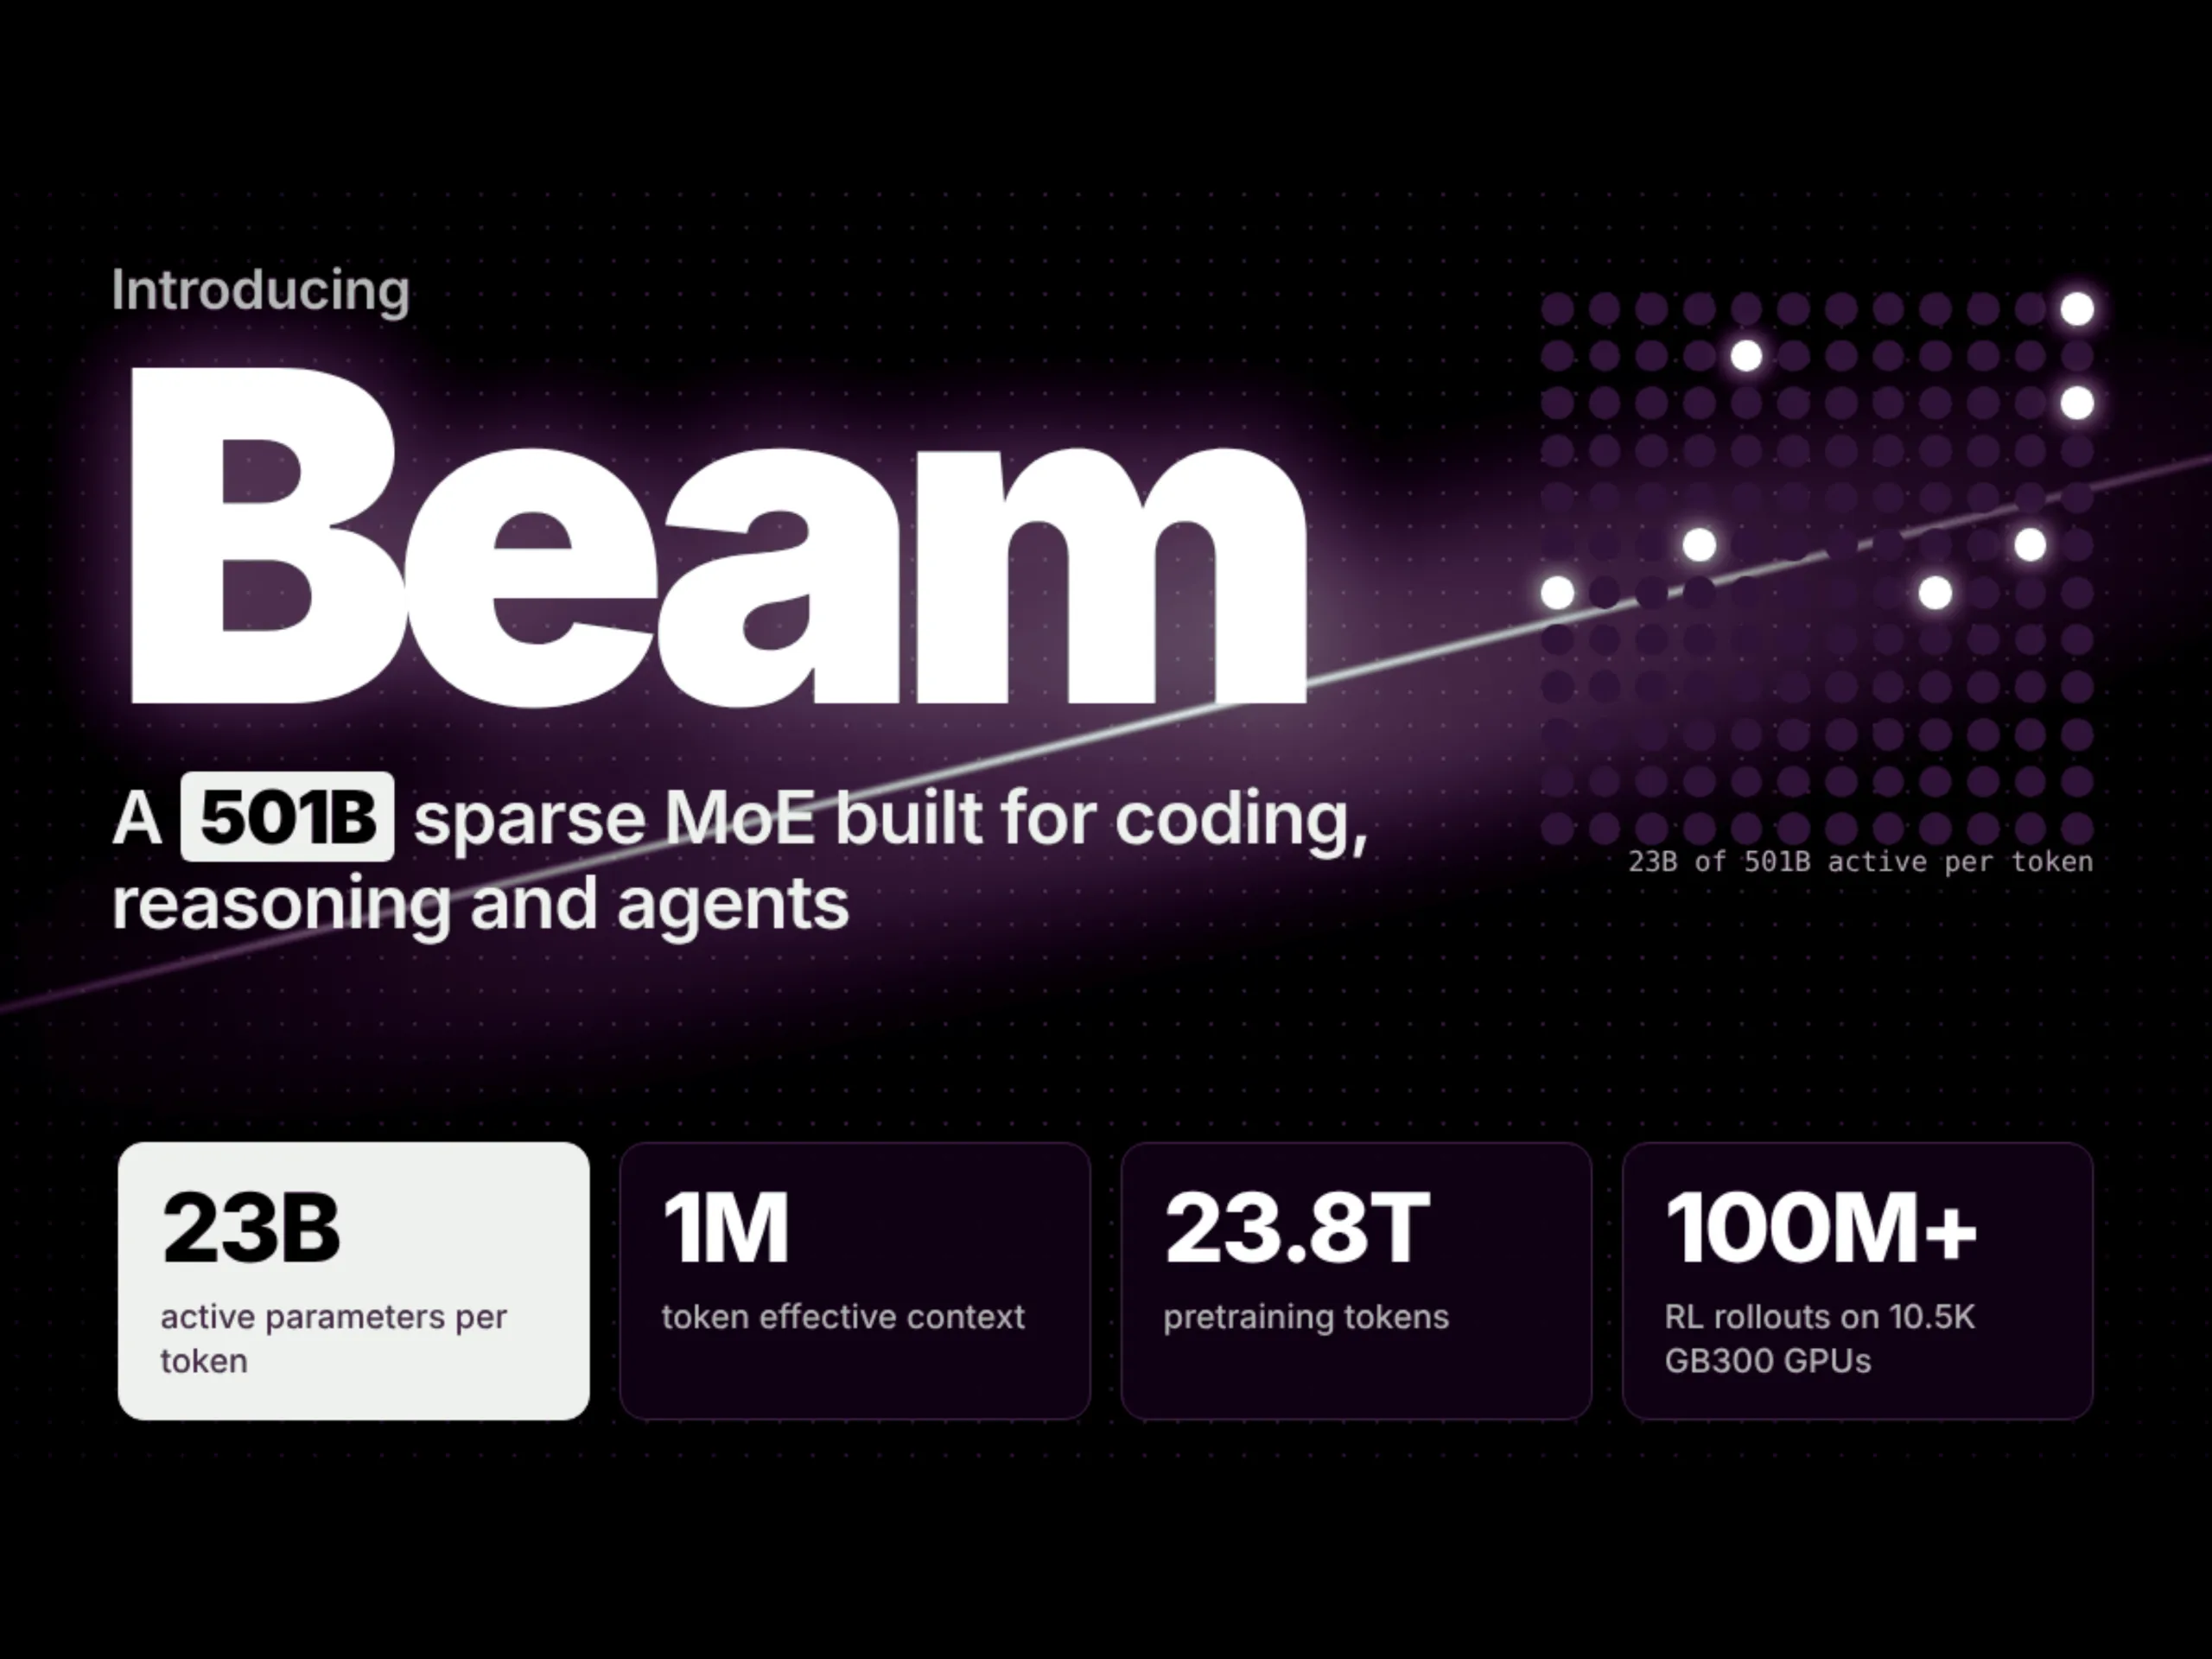
Să lămurim mai întâi ce înseamnă, pe românește, un model MoE. Spre deosebire de un model „dens” clasic, unde fiecare parametru este folosit pentru fiecare token generat, un model Mixture of Experts împarte rețeaua în mai multe „experți” specializați. Când vine un token, un mecanism de rutare decide către care experți să-l trimită. Rezultatul? Modelul are capacitatea brută a unui monstru de 501 miliarde de parametri, dar consumă resurse computaționale ca unul de 23 de miliarde. Este echivalentul unui spital imens, cu sute de specialiști, dar la care fiecare pacient ajunge doar la medicii de care are nevoie. Nimeni nu plătește pentru cardiolog când problema e la genunchi.
De ce contează asta pentru cod și pentru agenți autonomi? Pentru că exact aceste două domenii sunt cele mai înfometate de putere de calcul. Un asistent de programare care stă într-un IDE și completează linii de cod trebuie să răspundă în milisecunde, nu în secunde. Iar un agent autonom — acel tip de AI care navighează singur prin browser, dă click-uri, scrie fișiere, rulează comenzi în terminal și își verifică propriile rezultate — are nevoie de sute sau mii de apeluri consecutive la model pentru o singură sarcină. Dacă fiecare apel costă cât un zbor cu elicopterul, agentul devine inutilizabil. Beam promite exact opusul: inteligența unui model gigantic, la un cost de rulare care poate fi susținut pe termen lung.
Un detaliu care merită subliniat este că vorbim despre un model „open-weight”. Adică greutățile sunt disponibile public, iar comunitatea, companiile mici și cercetătorii independenți pot să-l descarce, să-l ruleze pe infrastructura proprie sau să-l adapteze pentru nișe foarte specifice. Nu mai ești obligat să te rogi de un API străin, să accepți prețuri care se schimbă peste noapte sau să trimiți date sensibile către servere pe care nu le controlezi. Pentru o piață europeană tot mai atentă la suveranitatea datelor, acest lucru nu este un moft, ci o necesitate strategică.
Desigur, nimeni nu rulează un model de 501 miliarde de parametri pe laptopul din sufragerie. Chiar și cu doar 23 de miliarde activi, ai nevoie de memorie suficientă pentru a ține în VRAM toți experții — ceea ce înseamnă, în practică, un nod serios de GPU-uri, genul acela pe care îl găsești în centre de date sau în ferme de calcul bine dotate. Totuși, diferența față de un model dens de talie similară este uriașă: costul per token scade dramatic, iar throughput-ul crește. Pentru o echipă care servește mii de utilizatori simultan, asta poate însemna diferența dintre a fi profitabil și a arde bani pe factura de cloud.
Alegerea Reflection AI de a se concentra pe coding și agentic workloads nu este întâmplătoare. Aici se dă, în acest moment, bătălia cea mai aprigă din industrie. Companiile nu mai vor doar un chatbot care să răspundă frumos la întrebări — vor un coleg digital care să scrie teste, să repare bug-uri, să migreze cod legacy, să automatizeze fluxuri întregi de lucru. Iar pentru asta, modelul trebuie să fie bun la raționament pe pași lungi, să nu se piardă după a cincizecea iterație și să respecte instrucțiuni complexe fără să halucineze. Un MoE bine antrenat are exact acest avantaj: capacitate mare de memorare a cunoștințelor, dar și flexibilitate de specializare pe sarcini.
Există, bineînțeles, și reversul medaliei. Modelele MoE sunt notoriu de greu de antrenat. Rutarea trebuie echilibrată, altfel unii experți ajung supraîncărcați și alții stau degeaba. Fine-tuning-ul este mai delicat, iar quantizarea — esențială pentru a reduce amprenta de memorie — poate degrada performanța dacă nu e făcută cu grijă. Apoi mai e și problema ecosistemului: un model nou are nevoie de suport în framework-uri precum vLLM, SGLang sau llama.cpp, de tooling de evaluare, de comunitate. Fără aceste lucruri, chiar și cel mai strălucit model rămâne o curiozitate de laborator.
Comparația cu concurența este inevitabilă. DeepSeek a demonstrat că un MoE open-weight poate concura cu modelele proprietare de top. Qwen a arătat că poți construi o familie întreagă de modele eficiente. Llama a deschis drumul, iar Mistral a rafinat rețeta. Beam intră pe o piață deja aglomerată, dar cu un argument puternic: raportul dintre capacitatea totală și parametrii activi. Dacă Reflection AI reușește să livreze performanțe apropiate de modelele de frontieră la un cost de rulare de câteva ori mai mic, atunci nu vorbim doar despre un model nou, ci despre o schimbare de paradigmă în modul în care companiile își construiesc produsele bazate pe AI.
Pentru dezvoltatorii români și din regiune, vestea este excelentă. Accesul la un astfel de model înseamnă că o echipă mică, cu buget limitat, poate construi un agent de codare sau un automatizator de procese care până acum era rezervat doar giganților cu milioane de dolari în buzunar. Startup-urile pot experimenta, pot face fine-tuning pe date proprii, pot rula totul on-premise pentru clienți din banking, sănătate sau sectorul public, unde confidențialitatea este sfântă. Bariera de intrare tocmai a scăzut cu câțiva metri.
Rămâne de văzut cum se va comporta Beam în teste reale, nu doar în benchmark-uri. Istoria recentă ne-a învățat să fim precauți: cifrele arată spectaculos pe hârtie, dar provocarea adevărată începe când pui modelul să lucreze într-un mediu haotic, cu date murdare, cerințe contradictorii și utilizatori nerăbdători. Totuși, direcția este clară. Viitorul AI-ului open nu va fi dominat de modele din ce în ce mai mari, ci de arhitecturi din ce în ce mai deștepte. Iar Beam, cu cei 501 de miliarde de parametri care se trezesc la viață doar 23 de miliarde o dată, este exact genul de inovație care ne arată încotro se îndreaptă lucrurile.
De ce este important:
Lansarea Beam de către Reflection AI contează din mai multe motive care se leagă direct de viitorul industriei AI. În primul rând, demonstrează că eficiența computațională a devenit noul câmp de luptă: nu mai câștigă cine are cel mai mare model, ci cine reușește să ofere cea mai multă inteligență la cel mai mic cost de rulare. Un MoE de 501 miliarde de parametri cu doar 23 de miliarde activi este o dovadă tehnologică a acestei direcții. În al doilea rând, faptul că modelul este open-weight accelerează democratizarea accesului la AI de vârf, permițând echipelor mici, startup-urilor și instituțiilor publice să construiască produse avansate fără a depinde de API-uri scumpe și opace. În al treilea rând, focalizarea pe coding și agenți autonomi anticipează unde se va duce cea mai mare parte a valorii economice în următorii ani: automatizarea muncii intelectuale repetitive. Iar în al patrulea rând, pentru piețe precum cea europeană, un astfel de model reprezintă o oportunitate strategică de a păstra suveranitatea datelor și de a construi tehnologie locală pe fundații deschise. Pe scurt, Beam nu este doar un model nou — este un semnal că viitorul AI-ului se scrie cu arhitecturi inteligente, nu doar cu hardware tot mai scump.