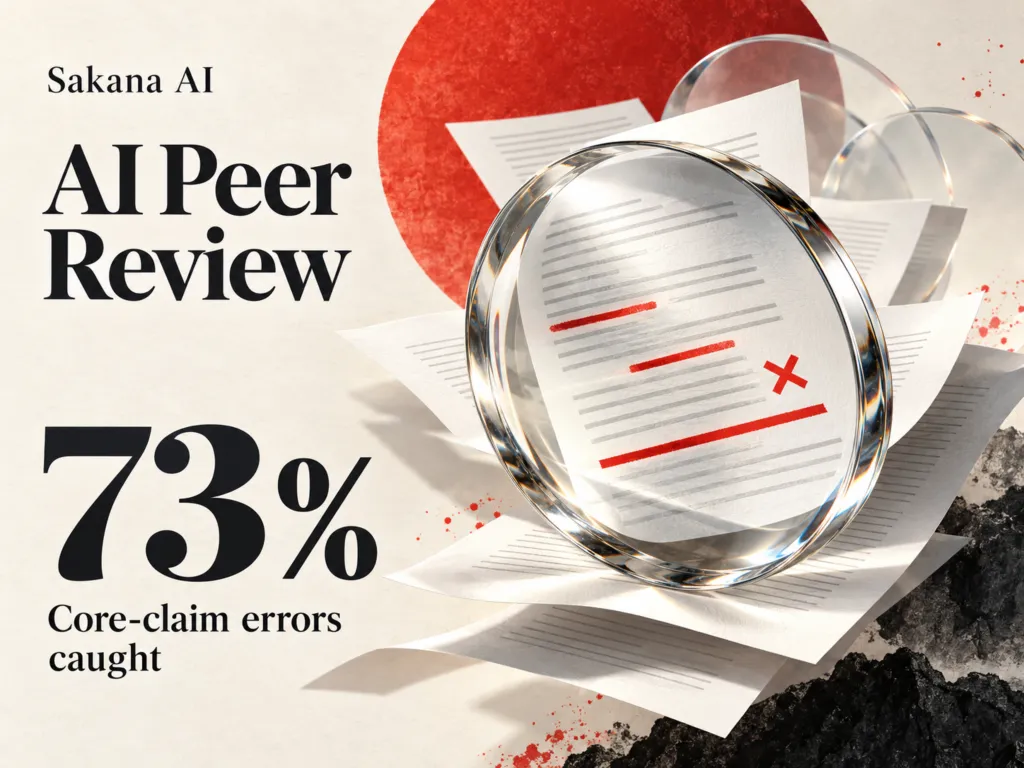
Sakana AI, fondată de David Ha și Llion Jones – da, chiar unul dintre creatorii arhitecturii Transformer de la Google – a venit cu o propunere care sună aproape SF la prima vedere: ce-ar fi dacă am pune modelele de limbaj să se judeze între ele? Nu e vorba despre cine face cel mai frumos text, ci despre cine identifică cel mai bine erorile de fond, acele afirmații centrale care, dacă sunt greșite, otrăvesc tot restul raționamentului. Un sistem de peer review automatizat, dacă vreți, dar cu un twist: judecătorul și acuzatul sunt, până la urmă, cam din aceeași specie digitală.
Cifra care dă de gândit: 73%
Dacă ar fi să reținem un singur lucru din toată povestea asta, ar fi procentul acela rotund și totuși brutal: 73%. Atât reușește sistemul Sakana să prindă din erorile de afirmație centrală, din ceea ce specialiștii numesc "core-claim errors". Adică atunci când un LLM susține cu nonșalanță că doi plus doi fac cinci, sau când îți explică o teoremă greșit cu aceeași convingere cu care un politician promite taxe mai mici.
Dar să nu ne grăbim. 73% nu înseamnă perfecțiune. Înseamnă că, din zece afirmații fundamentale greșite, sistemul le identifică pe șapte. Mai rămân trei care scapă. Și aici devine interesant, pentru că tocmai aceste trei sunt cele care îți pot strica toată ziua, mai ales dacă le folosești în cercetare, în medicină sau în orice alt domeniu unde o eroare factuală nu e doar jenă, ci risc real.
Cum funcționează, mai exact?
Mecanismul e simplu în teorie și complicat în practică. Sakana a construit un fel de tribunal digital în care un model A generează un text, iar un model B – diferit ca arhitectură sau antrenament – primește sarcina de a-l critica. Nu să-l aprobe, nu să-l mângâie pe cap, ci să-i găsească hibele. E ca și cum ai avea un prieten cinstit care îți spune că ți-a ieșit cravata strâmb, în loc să te lase să pleci la întâlnire cu ea dată peste cap.
Ideea nu e nouă – conceptul de "self-consistency" sau de evaluare încrucișată între modele a mai fost explorat. Noutatea vine din două direcții. Prima e cantitatea: Sakana a construit un protocol riguros, cu sarcini bine definite, cu metrici clare și cu o bază de testare care acoperă domenii diverse, de la matematică la istorie, de la programare la etică. A doua e maturitatea: sistemul nu mai e la stadiul de experiment academic, ci pare gata de integrare în fluxuri reale de lucru.
De ce e important ce au făcut japonezii
Hai să fim cinstiți, problema cu LLM-urile actuale nu e că sunt proaste. E că sunt prea încrezătoare. Halucinează cu un zâmbet pe buze, fabulează cu ochii în lacrimi de sinceritate și, dacă nu le pui un piedici, te lasă să crezi orice. Într-o lume în care tot mai multe decizii – de la medicale la juridice, de la financiare la militare – sunt influențate de ceea ce spun aceste modele, problema încrederii devine o problemă de siguranță națională, literalmente.
Sakana propune, practic, un al doilea strat de verificare. Nu te bazezi doar pe ce zice modelul, ci pe ce observă un alt model despre ce zice primul. E un fel de double-check algoritmic, unde două surse independente își compară concluziile înainte de a-ți da un răspuns final. Sună simplu, dar implementarea cere resurse, cere timp și cere, mai ales, oameni care înțeleg atât partea tehnică, cât și implicațiile etice.
Ce înseamnă asta pentru industrie
Pentru companiile care dezvoltă sau folosesc LLM-uri, mesajul e clar: nu te mai baza pe un singur model, oricât de strălucit ar fi el pe hârtie. Epoca în care GPT-cutare sau Claude-cutare era suficient de unul singur se apropie de final. În curând, dacă vrei un răspuns în care poți avea încredere, vei avea nevoie de o echipă de modele, fiecare cu rolul lui, fiecare cu sarcina lui, fiecare verificându-le pe celelalte.
Pentru cercetători, sistemul Sakana deschide o cutie a Pandorei plină cu întrebări fascinante. Cum alegi modelele care se evaluează reciproc? Cum eviți ca ele să aibă aceleași puncte oarbe? Cum ponderizezi opiniile când un "judecător" digital are mai multă încredere în el decât ar trebui? Toate acestea sunt probleme reale, iar răspunsurile lor vor modela viitorul nu doar al AI-ului, ci al modului în care producem și verificăm cunoaștere în general.
Limitele pe care nu trebuie să le ignorăm
Acum, ca orice jurnalist care se respectă, trebuie să pun și niște semne de întrebare. 73% e un număr bun, dar e un număr măsurat în condiții controlate. În lumea reală, unde întrebările sunt ambigue, unde contextul lipsește, unde adevărul e mai degrabă o convenție socială decât o constantă matematică, performanța scade. Și chiar și acele 73% se referă la erori de afirmație centrală – ce rămâne cu erorile mai subtile, cu raționamentele greșite care ajung la concluzii corecte pe drum greșit, cu premisele ascunse care contaminează totul?
Mai e și problema costului. Rularea mai multor modele pentru a verifica un singur răspuns nu e ieftină, nici ca timp, nici ca energie electrică, nici ca amprentă de mediu. Dacă vrem cu adevărat să folosim peer review automat la scară largă, va trebui să regândim arhitecturile, să optimizăm, poate chiar să inventăm modele specializate exclusiv pe sarcina de a evalua, nu de a genera.
O privire spre viitor
Sakana AI nu a rezolvat problema halucinațiilor. Nimeni n-a rezolvat-o, deși toți pretind că au găsit-o. Ce au făcut japonezii e mai degrabă o promisiune: că putem construi sisteme mai sigure, că putem pune frâne digitale inteligente înainte ca AI-ul să ne ia locul nu doar la muncă, ci și în a distinge adevărul de ficțiune.
Dacă ești dezvoltator, dacă ești cercetător, dacă ești doar un utilizator curios care vrea să știe dacă poate avea încredere în ce-i zice ChatGPT-ul, sistemele de acest gen sunt cele care vor face diferența între o eră a informației augmentate și una a dezastrului informațional. Nu e o exagerare. E o observație simplă, dintr-o lume în care adevărul a devenit, în sfârșit, o problemă tehnică.
De ce este important:
Sistemul Sakana AI de evaluare între colegi demonstrează că inteligența artificială poate fi antrenată nu doar să producă conținut, ci și să verifice conținutul produs de alte sisteme AI, oferind un strat suplimentar de siguranță într-o eră în care halucinațiile modelelor lingvistice devin o problemă tot mai presantă. Cu o rată de detectare de 73% a erorilor de afirmație centrală, această abordare marchează o tranziție de la modele care operează izolat la ecosisteme de modele care colaborează și se corectează reciproc. Pentru companii, cercetători și utilizatori finali, implicațiile sunt uriașe: de la creșterea încrederii în răspunsurile automate, la reducerea riscurilor în domenii sensibile precum sănătatea, dreptul sau finanțele, până la o posibilă regândire a modului în care construim și evaluăm cunoașterea automată. Nu e doar un progres tehnic, e o schimbare de paradigmă.