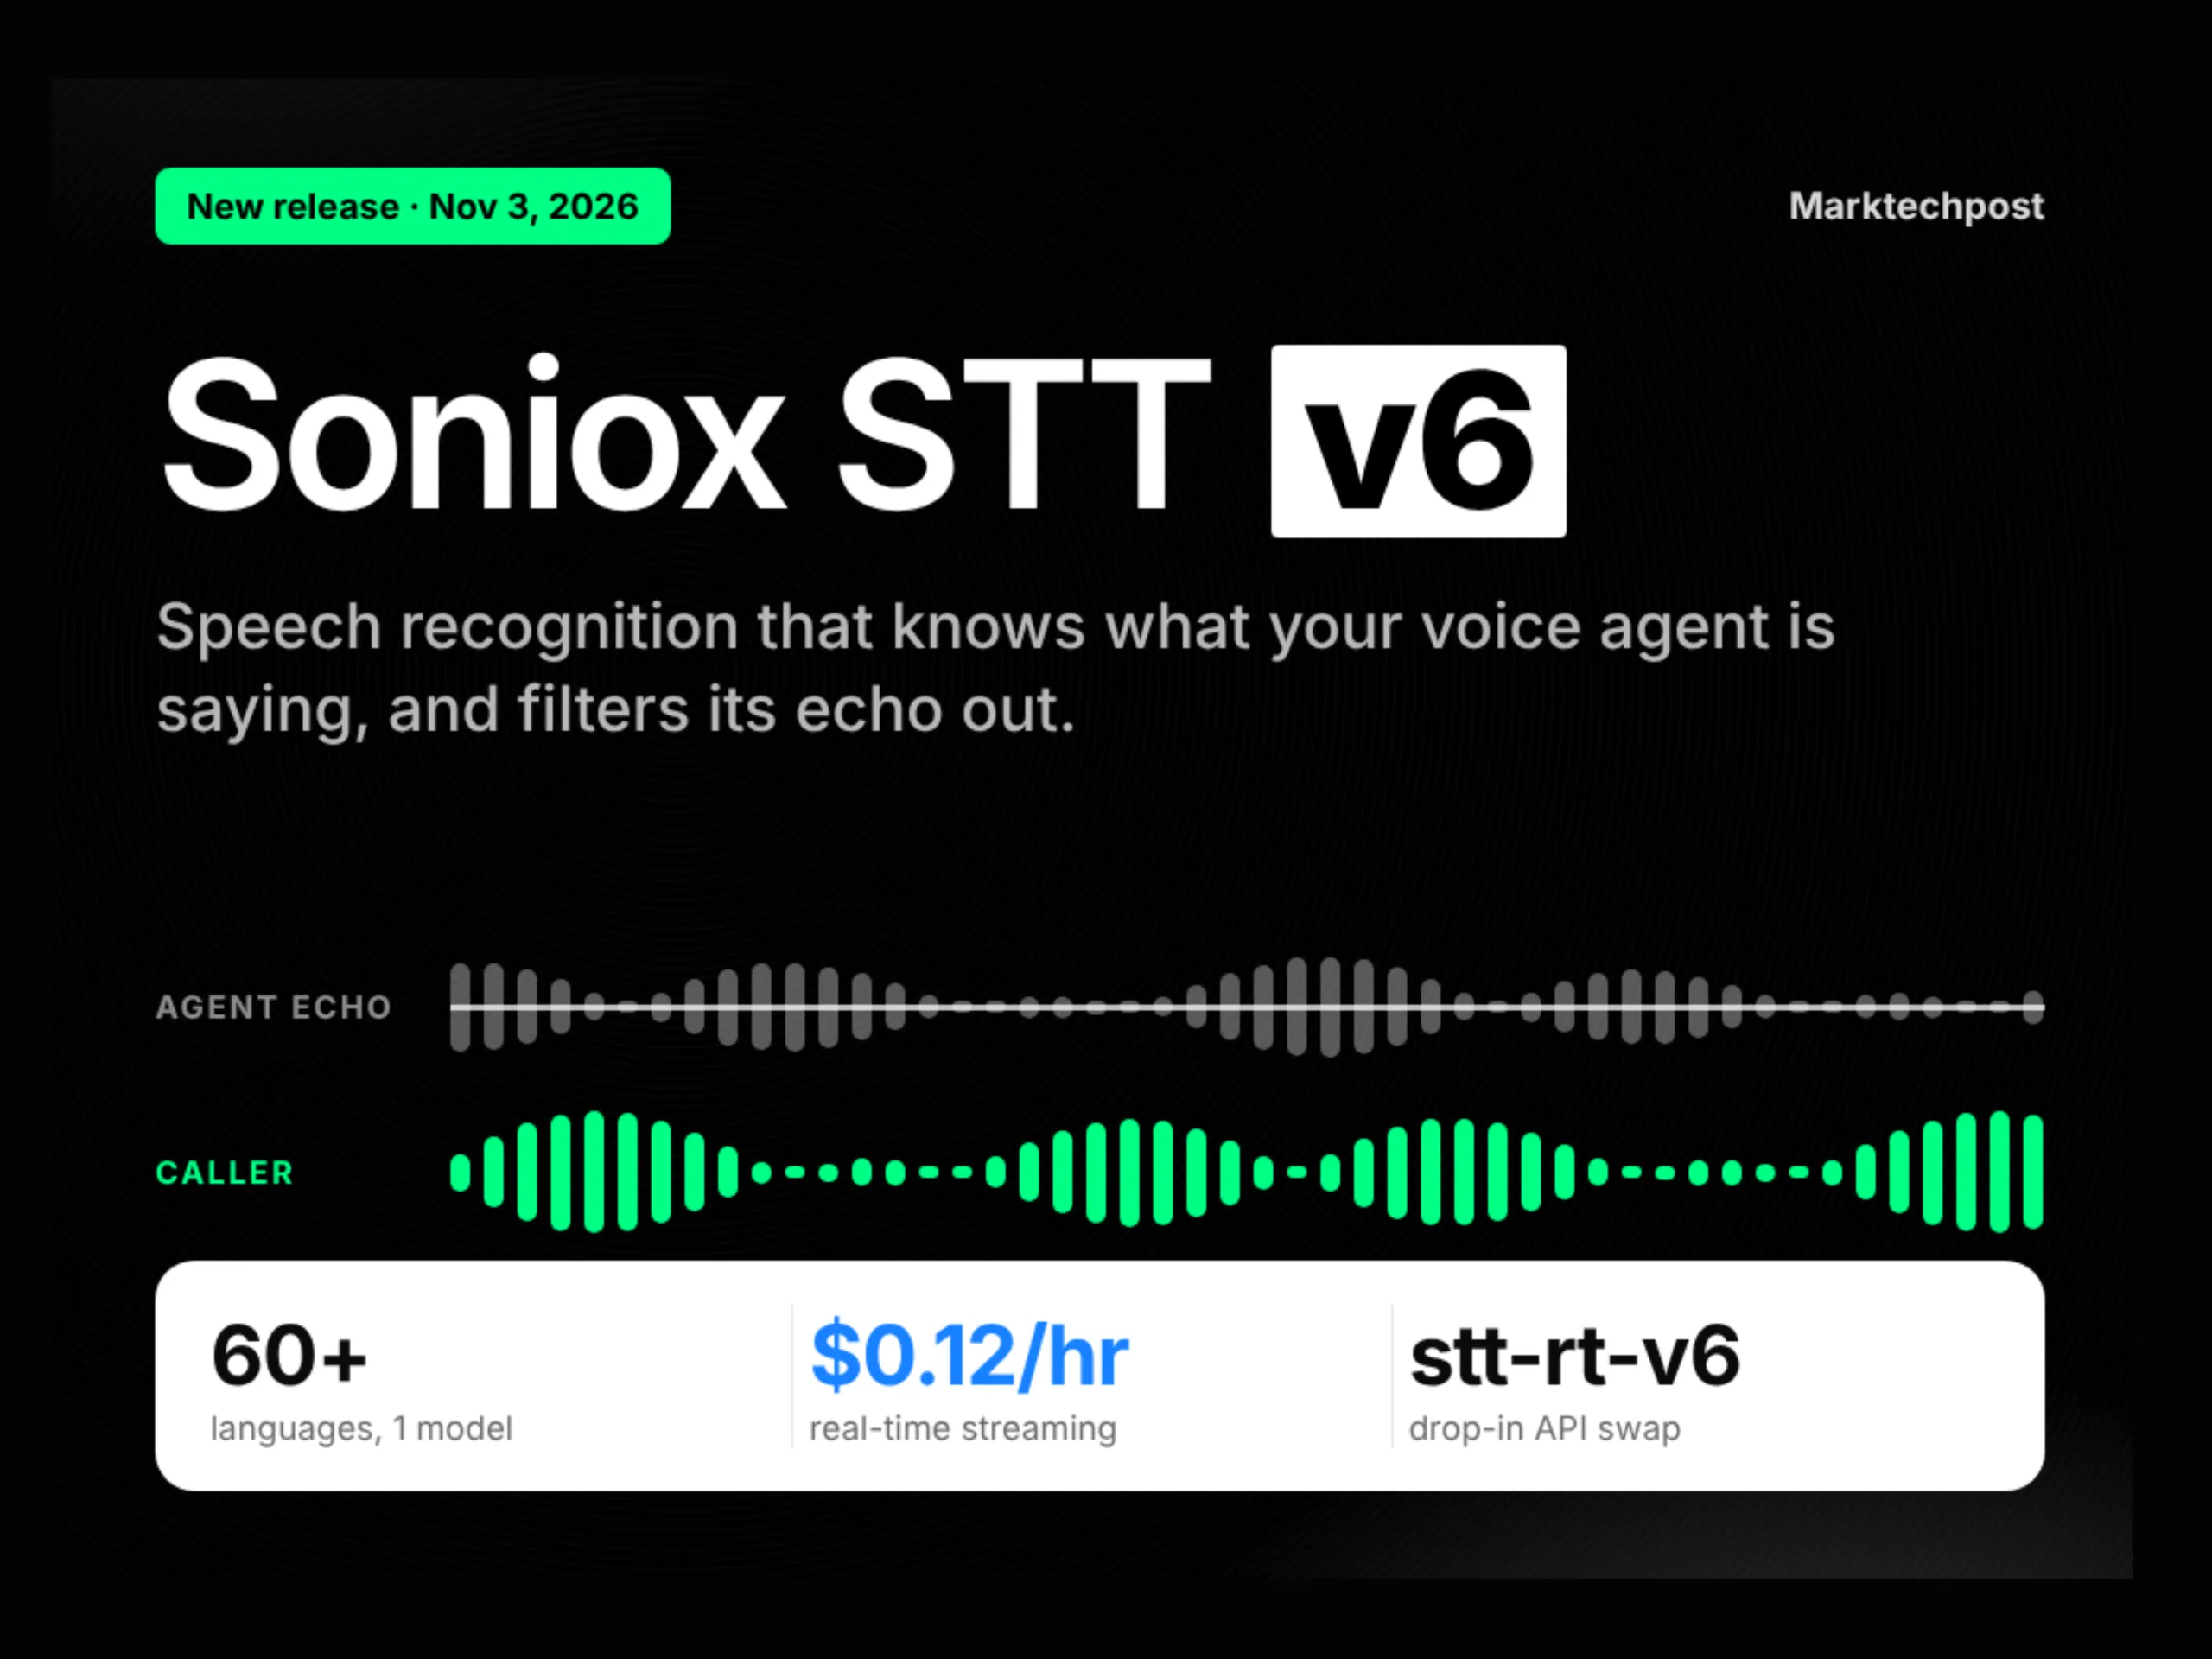
Dacă ați încercat să construiți un agent vocal în ultimul an, știți durerea: modelele STT clasice au fost create pentru dictare sau transcriere a call-urilor center. Ascultă, procesează, returnează text. Dar un agent vocal modern trebuie să asculte în timp ce vorbește, să oprească generarea când utilizatorul întrerupe (barge-in), să ignore propriul sunet emis de speaker (echo cancellation) și să primească context textuel pentru a corecta erorile în timp real. Soniox STT v6 adresază exact aceste puncte de fractură cu două funcționalități care sună tehnice, dar sunt esențiale: Agent Text Input și Echo Filtering.
Problema "Echo-ului" în arhitectura RAG vocală
Să începem cu Echo Filtering, pentru că este cel mai vizibil durere de cap pentru dezvoltatori. Într-un setup clasic RAG (Retrieval-Augmented Generation) vocal, pipeline-ul arată cam asta: STT -> LLM -> TTS (Text-to-Speech). Agentul vorbește, utilizatorul începe să răspundă. Microfonul captează amândouă: vocea utilizatorului și vocea agentului care revine din speaker. Modelele STT tradiționale se confunda, transcriind un amestec haotic sau, mai rău, oprire agentul din greșeală (false positive barge-in).
Soniox v6 aduce un filtru echo nativ, la nivel de model, nu doar un DSP (Digital Signal Processing) clasic de la nivel de hardware sau soft. Aceasta înseamnă că rețeaua neuronală a învățat să recunoască și să suprimă proprie semnătura acustică a agentului, chiar și în condiții de zgomot sau reverberare puternică. În teste interne, dar și în beta-ul privat pe care l-am urmărit de câteva săptămâni, reducerea ratei de eroare pe word (WER) în scenarii de "self-talk" (agentul vorbește, utilizatorul întrerupe) a fost de ordinul a 30-40% față de v5 combinat cu soluții terțe de AEC (Acoustic Echo Cancellation). Practic, agentul devine capabil să se "auto-asculte" și să ignore propriul output audio, lucru fundamental pentru conversații duplex reale.
Agent Text Input: Contextul este rege
A doua mare inovație, Agent Text Input, este poate mai subtilă, dar la fel de critică. Imaginează-ți un agent care ajută un utilizator să reserve un bilet de avion. Utilizatorul spune: "Rezervă-mi locul la... ähh... acel loc cu turnul Eiffel". Un STT standard va transcri: "Rezervă-mi locul la... ähh... acel loc cu turul Eiffel" (greșeală fonetică) sau va rata entitatea. Dar agentul știe contextul: este un agent de călătorii, destinațiile posibile sunt Paris, Lyon, etc.
Cu Agent Text Input, dezvoltatorii pot injecta în motorul STT, în timp real, textul de context: lista destinațiilor, termenii specifici domeniului, istoricul conversației. Modelul Soniox folosește acest text ca un "prior" Bayesian puternic, biasând decodificarea către cuvintele așteptate. Rezultatul? "Turnul Eiffel" devine "Turnul Eiffel" corect, chiar și dacă pronunția e murdără. Este o abordare "human-in-the-loop" la nivel de inferență: modelul nu mai este o cutie neagră izolată, devine parte din sistemul cognitive al agentului. Aceasta reduce drastic halucinațiile de entități (slot filling errors), care sunt azi principalul motiv pentru care agenții vocali eșuează în producție.
Arhitectură și Latentă: Jocul milisecundelor
Pe de sub capot, Soniox a rescris motorul de decodificare pentru a suporta streaming-ul cu latență ultra-joasă (sub 100ms end-to-end în configurații optime) fără a sacrifica acuratețea modelului mare (large model). Au implementat o arhitectură de tip "lookahead" optimizată pentru GPU-uri moderne (H100/A100), dar care scalează surprinzător de bine pe instanțe mai mici (T4, L4) datorită unei noi tehnici de distilare a cunoștințelor (knowledge distillation) aplicată la nivel de tokenizer și decoder.
Ce m-a impresionat la discuțiile cu echipa lor (și pe care o văd reflectată în documentația tehnică nouă) este refuzul de a compromite. Multe soluții "low latency" pe piață (cum ar fi anumite modele distilate Whisper sau soluții proprii mici) tăiesd din model până devin proaste la zgomot sau accente. Soniox v6 menține performanța de top pe benchmark-uri standard (LibriSpeech, Common Voice, GigaSpeech) și adaugă noile capacități de streaming controlat. Pentru un dezvoltator, asta înseamnă: deployezi un singur model, un singur API endpoint, și primești atat transcrierea batch de înaltă calitate, cât și streaming-ul interactiv pentru agenți.
Impactul pe ecosistemul Voice AI
De ce este important acest lucru acum? Pentru că 2024-2025 este anul în care agenții vocali trec din faza "demo cool pe Twitter" în producție reală: call center automation, recepționiste virtuale, asistenți medicali, tutori AI. Toate aceste aplicații au nevoie de fiabilitate, nu de demo-uri. Fiabilitatea în voce vine de la trei piloni: acuratețe la entități (rezolvat prin Text Input), robustețe la auto-vorbire/echo (rezolvat prin Echo Filtering) și latență percepută ca umană (rezolvat prin noua arhitectură de streaming).
Am văzut prea multe startup-uri care lipesc resursele să îmbine un Whisper fine-tuned, un AEC de la WebRTC, un VAD (Voice Activity Detection) separat și un sistem de biasing extern. Stack-ul devine frământat, greu de depanat, costisitor de rulat. Soniox v6 propune o consolidare: "Batteries included". Un singur model care face VAD, STT, Echo Cancellation, Contextual Biasing și Punctuation/ITN (Inverse Text Normalization). Aceasta este maturitatea pe care industriea o aștepta.
Perspective și provocări rămase
Desigur, nu totul e perfect. Prețul API-ul Soniox rămâne premium față de alternativele open-source (Whisper.cpp, faster-whisper) sau modelele hostate low-cost (Deepgram, AssemblyAI tier-uri de bază). Pentru o startup la început de drum, costul per minută de audio procesat poate fi o barieră. De asemenea, suportul pentru limbi mai puțin reprezentate (româna inclusiv, deși a avut progrese uriașe în v5) încă nu atinge nivelul englezei sau spaniolului în scenarii de zgomot extrem sau dialecte regionale puternice.
Dar direcția este clară. Soniox nu mai vinde "speech-to-text". Vinde "înțelegere vocală pentru agenți". Și această distincție lingvistică maschează o schimbare fundamentală de paradigă: de la transcriere pasivă la percepție activă, contextualizată și reactivă.
De ce este important:
Lansarea Soniox STT v6 marchează maturizarea tehnologiei Speech-to-Text de la un utilitar de transcriere la o componentă strategică a arhitecturii agentilor AI. Introducerea Agent Text Input rezolvă problema fundamentală a halucinațiilor de entități în timp real prin injectarea contextului semantic direct în decodificator, în timp ce Echo Filtering nativ elimină nevoia de soluții AEC externe fragile, permițând conversații full-duplex naturale. Pentru dezvoltatori și CTO-uri, acest lucru înseamnă simplificarea drastică a stack-ului tehnic (un singur model pentru VAD, STT, AEC, Context Biasing), reducerea latenței percepute sub pragul percepcției umane și, în final, posibilitatea de a lansa agenți vocali în producție cu o fiabilitate care până acum era rezervată sistemelor enterprise costisioase și complexe. Este pasul decisiv spre democratizarea interfețelor vocale realmente inteligente.