
Pentru cei neinițiați, SGLang (Structured Generation Language) s-a impus în ultimul an ca unul dintre cele mai promițătoare framework-uri pentru serving-ul modelor LLM, oferind o alternativă flexibilă și performantă soluțiilor etablite precum vLLM sau TGI (Text Generation Inference). Arhitectura sa, bazată pe conceptul de "radix attention" și o planificare a cererilor orientată pe batch-uri continue, a demonstrat deja viteze de inferență superioare în benchmark-uri independente. Totuși, orice inginer care a deployat modele în producție știe că bottleneck-ul real nu este doar matricea de atenție, ci managementul memoriei KV (Key-Value) cache — acel mecanism esențial care stochează starea internă a modelului pentru fiecare token generat, evitând recalculul complet la fiecare pas de decodare.
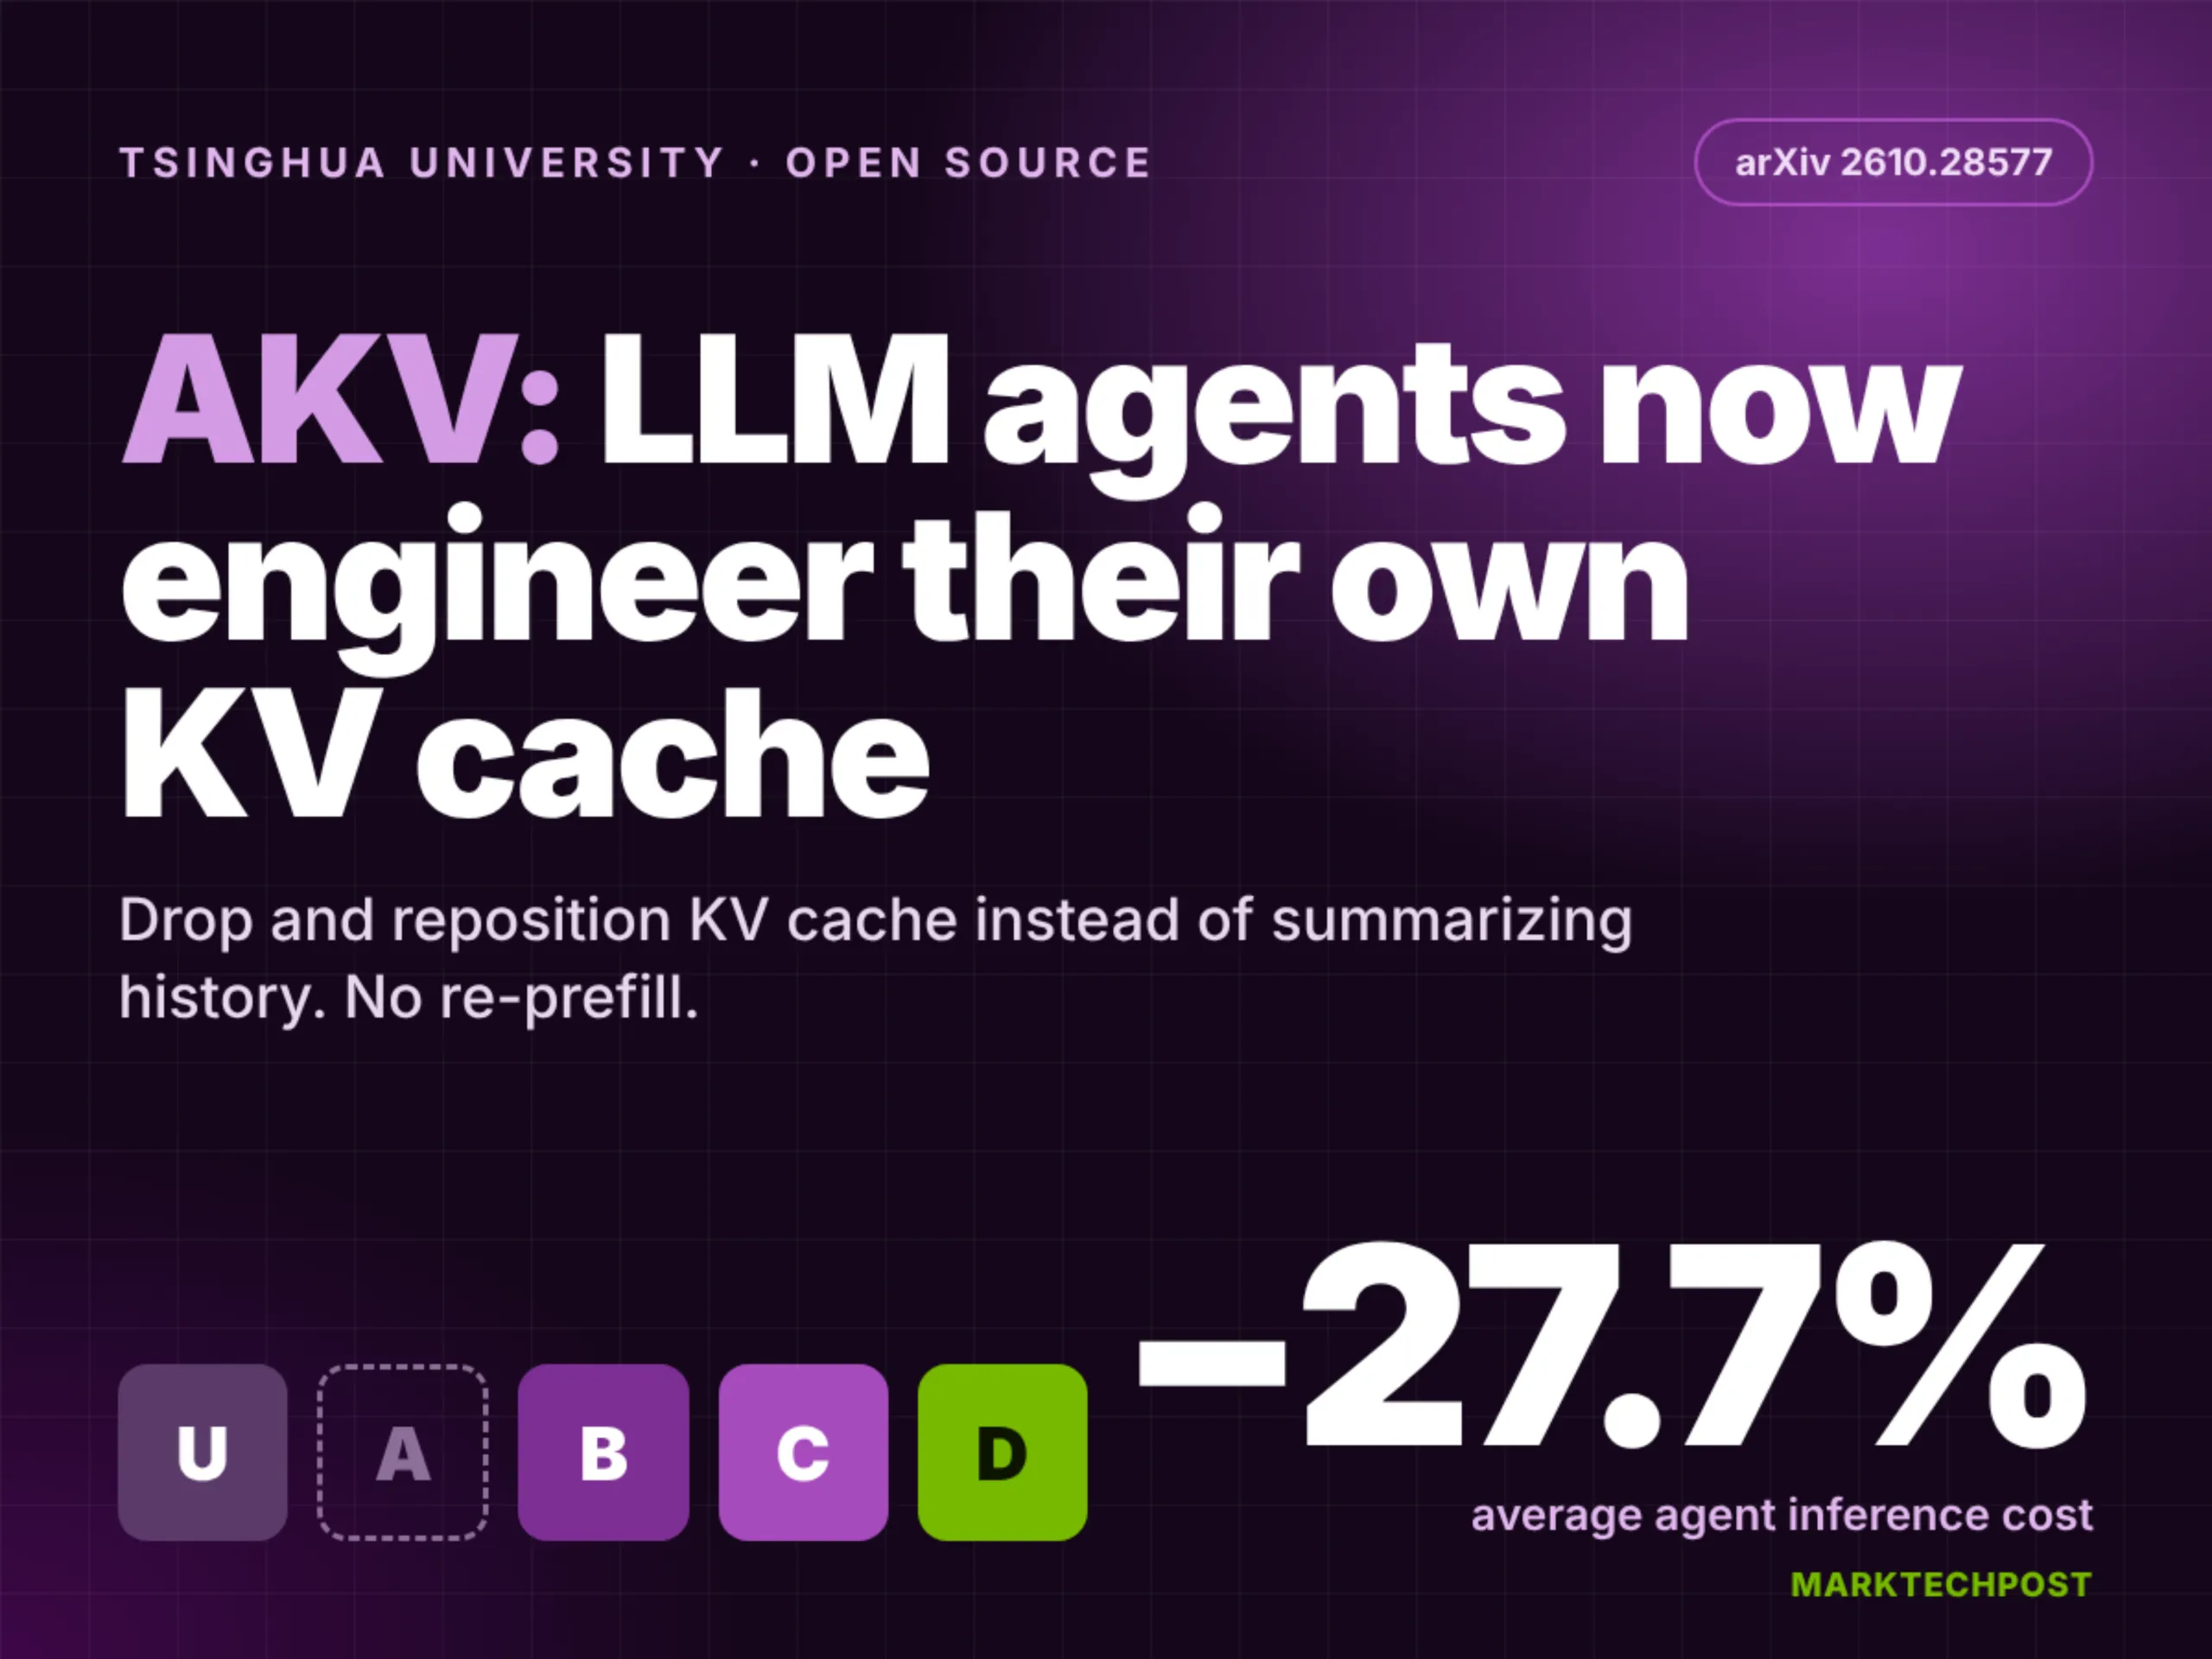
Aici intervine AKV. Nu este doar un simplu magazin key-value generic, precum Redis sau Memcached, adaptat ad-hoc. Este un server de cache engineering-at — un termen pe care echipa Tsinghua îl folosește deliberat pentru a sublinia faptul că AKV a fost construit de la zero cu constrângerile specifice ale inferenței LLM în minte: accesul secvențial la blocuri de token-uri, evicția prioritizată pe baza importanței contextuale (nu doar LRU), suport nativ pentru prefix sharing între cereri multiple (crucial pentru sistemele RAG sau agenții care reutilizează prompt-uri de sistem lungi), și, cel mai important, o integrare nativă, zero-copy cu motorul de execuție SGLang printr-un protocol RPC optimizat.
Arhitectura AKV dezleagă storage-ul KV cache de GPU-urile care fac inferența. În configurațiile tradiționale, cache-ul KV locuiește în VRAM pe același GPU cu modelul, limitând dimensiunea contextului și numărul de cereri concurente (batch size) de memoria disponibilă. AKV mută acest cache pe o tier separată — potențial pe CPU RAM (mult mai ieftină și abundentă), pe NVMe SSD-uri de înaltă performanță, sau chiar pe un cluster distribuit de noduri CPU-only — lăsând GPU-urile să facă exclusiv calculul matriceal. Rezultatul? O creștere dramatică a capacității de throughput: experimentele interne ale echipei indică până la 3-5x mai multe cereri concurente pe același hardware GPU, cu o latență medie de inferență redusă cu 30-40% pentru contexte lungi (peste 32k tokeni), datorită eliminării recomputărilor redundante a prefixelor comune.
Dar inovația nu se oprește la separarea memoriei. AKV introduce un concept numit "Semantic-Aware Eviction". Algoritmii tradiționali de cache (LRU, LFU) tratează toate token-urile egal. În realitate, token-urile din prompt-ul de sistem sau din documentele RAG retrivate sunt mult mai valoroase decât cele din conversația curentă a utilizatorului, pentru că sunt reutilizate de mii de ori. AKV analizează pattern-urile de acces în timp real și atribuie scoruri de "valoare marginală" fiecărui bloc KV, menținând în tier-ul rapid (CPU RAM) ceea ce contează și deplasând restul pe disk sau evicinându-l complet. Aceasta este o abordare fundamental diferită de cele existente în vLLM (cu PagedAttention) sau în sistemele de cache generice.
Implicațiile pentru agentii LLM sunt profunde. Agienții moderni — acele sisteme care lansează căi de raționament complexe, fac tool calling, iterează pe bucle de reflexie și accesează baze de date vectoriale — generează volume uriașe de token-uri intermediare, multe redundante. Un agent care scrie cod, rulează teste, refactorizează și documentează poate consuma ușor 100k-500k tokeni per task. Fără un cache KV inteligent, fiecare iterare re-procesează contextul întreg. Cu AKV, contextul comun (fișierele repository-ului, documentația API, prompt-ul de sistem al agentului) rămâne "cald" în cache, transformând o inferență care ar dura minute într-una de secunde. Echipa Tsinghua a demonstrat acest lucru rulând un benchmark de tip SWE-bench (rezolvarea issue-urilor GitHub reale) pe un agent bazat pe Llama-3-70B: timpul mediu de rezolvare a scăzut de la 12 minute la 4 minute, iar costul GPU/ora a căzut proporțional.
Decizia de a face AKV complet open-source (licența Apache 2.0) și de a-l integra nativ în ecosistemul SGLang — în loc să-l vândă ca serviciu gestionat sau să-l țină proprietar — reflectă o filozofie specifică comunității de cercetare chineze de top: accelerarea colectivă a stării de arte. Codul este curat, bine documentat (ceea ce e rar în proiectele academice), cu teste de integrare pentru Docker, Kubernetes (inclusiv un operator custom pentru scalare automată a nodurilor de cache) și suport pentru heterogenitate hardware (NVIDIA, AMD ROCm, chiar și Apple Silicon prin Metal). Comunitatea SGLang a reaccionat entuziasmat: în primele 48 de ore, repository-ul a strâns peste 1.200 de stele, 40+ de fork-uri și un flux constant de PR-uri care adaugă suport pentru noi backend-uri de storage (TiKV, Cassandra, Alluxio).
Există, desigur, provocări. Mutarea cache-ului KV de pe GPU pe CPU/NVMe introduce o latență de rețea și serializare/deserializare. AKV mitigează asta prin batching-ul transferurilor, compresia tensorilor (suportând FP8, INT4 quantization on-the-fly) și un protocol RPC bazat pe RDMA/UCX pentru clusterele high-end. Dar pentru deployment-urile mici (un singur GPU), overhead-ul poate depăși beneficiile. Echipa recomandă AKV pentru scenarii cu context lung (>8k), concurență ridicată (>16 requeste simultane) sau agenți multi-turn — exact zonele unde SGLang strălucește oricum.
Pe termen lung, AKV ar putea deveni componenta standard de facto pentru serving-ul LLM în producție, similar cu cum a devenit Redis standard pentru caching-ul web. Dacă SGLang este motorul, AKV este sistemul de alimentare cu combustibil inteligent. Și faptul că vine din academia chineză, nu dintr-o corporație americană (Google, Meta, OpenAI), semnalizează o maturizare a ecosistemului global open-source AI: inovația fundamentală în infrastructură nu mai este monopolu laboratoarelor industriale. Pentru inginerii care construiesc astăzi generația viitoare de aplicații AI — agenți autonomi, sisteme RAG la scară enterprise, copiloți de codare — AKV nu este doar un tool de încercat. Este o parte esențială a stack-ului modern, gata de folosit, astăzi.
De ce este important:
AKV rezolvă unul dintre cele mai costisitoare și neglijate probleme ale inferenței LLM în producție: managementul eficient al memoriei KV cache. Prin dezlegarea cache-ului de GPU și introducerea unei politici de evicție semantic-aware, AKV permite rularea agentilor LLM complexi cu contexte masive pe hardware existent, reducând costurile cu 60-80% și latența cu 30-40%. Fiind open-source, nativ integrat cu SGLang și proiectat pentru producție (K8s, RDMA, quantizare), AKV accelerează democratizarea accesului la AI performantă, permițând echipelor mici să construiască sisteme care rivalizează cu cele ale gigantelor tech — fără bugetele lor.