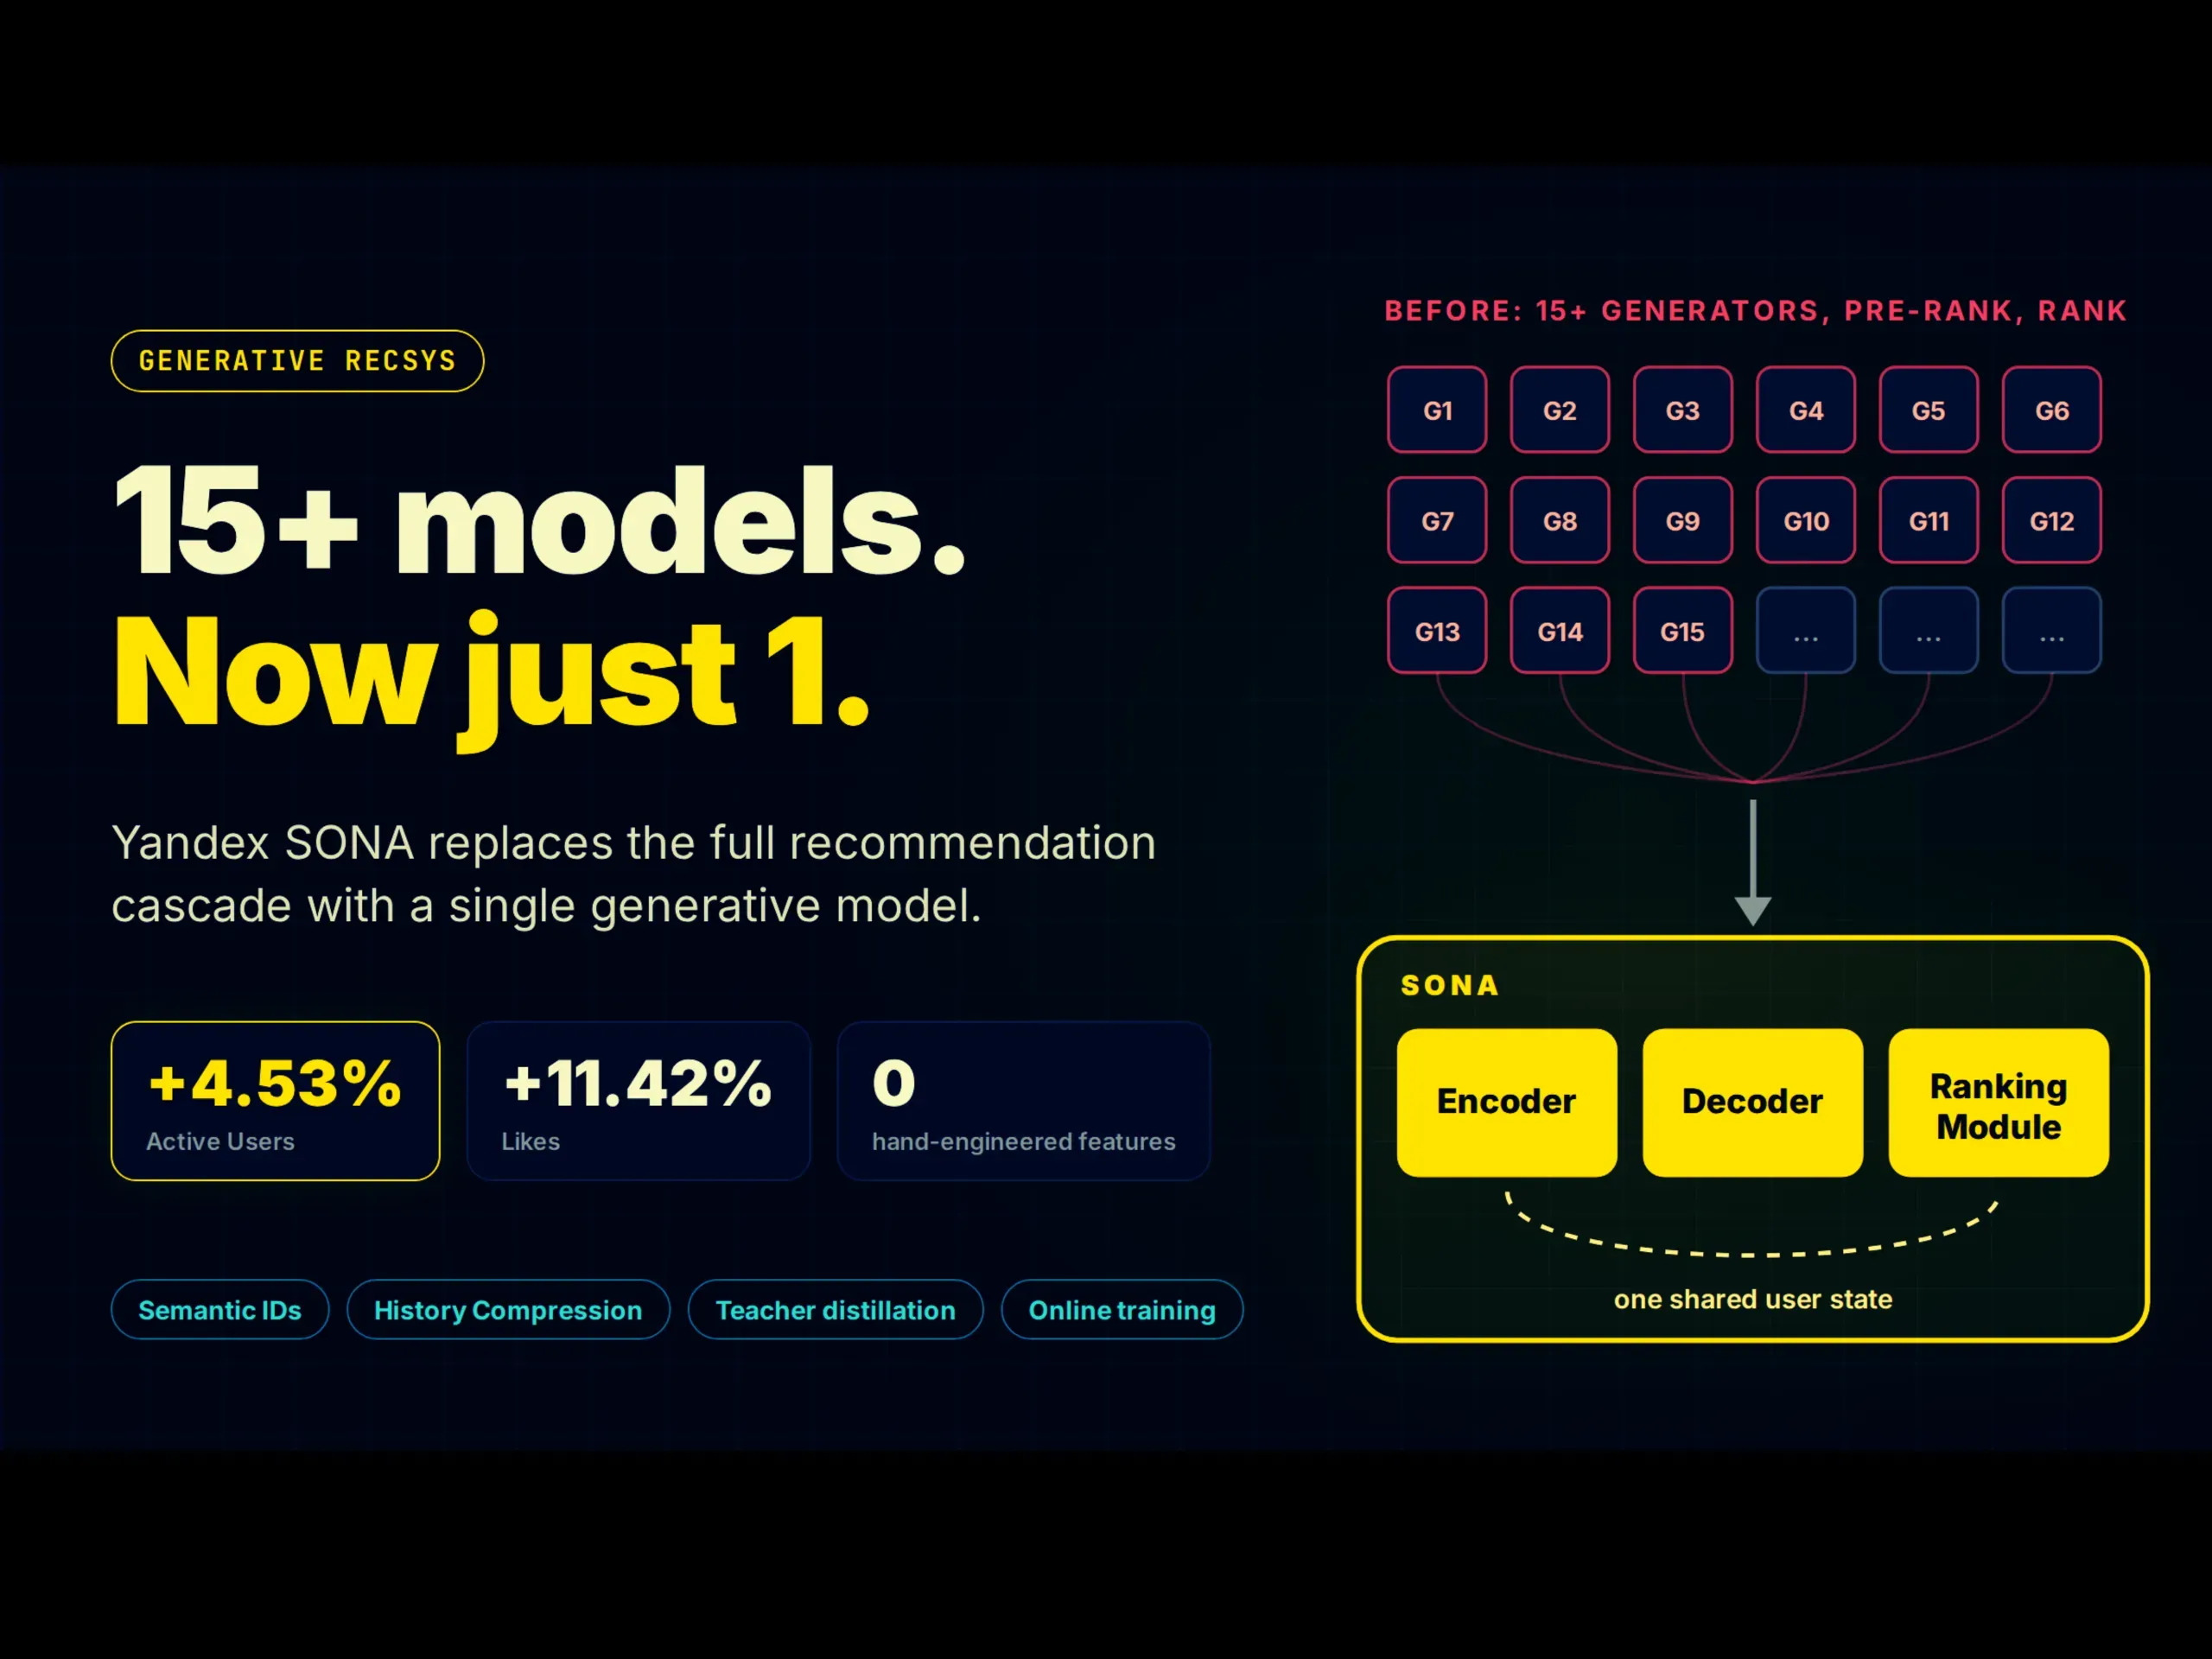
Nu este o optimizare incrementală. Este o schimbare de paradigmă. În loc să antrenezi separat cinci sau șase modele, fiecare cu propriile date, propriile pierderi și propriile compromisuri, Sona învață să genereze direct lista finală de recomandări, ca și cum ar scrie o propoziție. Exact așa cum un model de limbaj prezice următorul token, Sona prezice următorul item relevant pentru utilizator, ținând cont de contextul întregii sesiuni.
De ce contează asta atât de mult? Pentru că vechea cascadă avea un defect fundamental: fiecare etapă optimiza un obiectiv local, nu obiectivul global. Modelul de generare a candidaților putea rata itemi relevanți pentru că nu ajungeau niciodată în lista scurtă. Modelul de ranking putea promova clickbait-uri pentru că era antrenat pe click-uri. Iar re-ranker-ul putea strica ordinea bună încercând să repare diversitatea. Rezultatul era un sistem care funcționa bine, dar niciodată optim. Sona rezolvă această problemă prin design: un singur obiectiv, o singură pierdere, o singură optimizare end-to-end.
Arhitectura din spate este fascinantă. Sona folosește un transformer cu atenție pe secvențe lungi de interacțiuni, tratând istoricul utilizatorului ca pe un text. Fiecare item consumat devine un token, fiecare context (ora din zi, dispozitiv, locație aproximativă) devine un embedding, iar modelul învață să genereze continuarea plauzibilă a acelei secvențe. Nu mai există un pas separat de „generare a candidaților” pentru că modelul poate genera direct din întregul catalog, folosind tehnici de eșantionare eficientă precum căutarea aproximativă în spațiul latent sau decodarea cu fascicule restrânse.
Un aspect crucial pe care Yandex l-a subliniat în comunicarea lor este scalabilitatea. La nivelul lor de trafic, vorbim de miliarde de interacțiuni zilnice și de un catalog de milioane de itemi. Un model generativ care ar încerca să scoreze fiecare item pentru fiecare utilizator ar fi imposibil de rulat în timp real. Soluția a venit din combinarea unor tehnici de retrieval aproximativ cu un decoder autoregresiv care generează doar candidații promițători, fără a evalua explicit restul catalogului. Practic, Sona învață să „știe” unde să caute, nu să verifice tot.
Dar poate cel mai interesant lucru este modul în care Sona tratează diversitatea și prospețimea. În cascada clasică, acestea erau injectate forțat la final, prin reguli sau prin re-ranking. În Sona, ele devin parte din obiectivul de antrenare. Modelul învață că o listă bună nu înseamnă doar itemi relevanți, ci itemi relevanți care acoperă interese diferite și care nu repetă aceeași temă la nesfârșit. Este o diferență subtilă, dar cu impact uriaș asupra experienței utilizatorului.
Există și provocări, desigur. Un model generativ end-to-end este mult mai greu de debugat. Când ceva merge prost, nu poți să spui „ah, problema e în re-ranker”. Trebuie să te uiți la întregul sistem, la datele de antrenare, la modul în care sunt construite secvențele, la modul în care sunt eșantionați negativele. De asemenea, actualizarea modelului devine mai delicată: o schimbare mică în date poate avea efecte în cascadă pe care nu le vezi imediat. Yandex a recunoscut aceste dificultăți și a investit masiv în infrastructură de monitorizare și în teste A/B riguroase.
Un alt aspect demn de remarcat este modul în care Sona se comportă la rece, adică pentru utilizatori noi sau pentru itemi noi. Cascada tradițională avea mecanisme specifice pentru cold-start: embeddings inițializate aleatoriu, reguli de fallback, conținut bazat pe metadate. Sona, fiind un model generativ, poate folosi contextul disponibil (de exemplu, primele câteva interacțiuni) pentru a genera recomandări plauzibile, fără a avea nevoie de un istoric bogat. Este o dovadă că abordarea generativă este mai flexibilă decât se anticipa.
Rezultatele raportate de Yandex sunt impresionante: creșteri semnificative ale metricilor de engagement, reducerea latenței și simplificarea dramatică a infrastructurii. În loc să întreții șase modele, întreții unul. În loc să ai șase pipeline-uri de date, ai unul. În loc să ai șase echipe care se coordonează greu, ai una singură, cu un obiectiv clar. Pentru o companie de talia Yandex, asta înseamnă economii de milioane de dolari și luni de dezvoltare.
Dar impactul depășește cu mult granițele Yandex. Sona este un semnal că industria se îndreaptă spre modele generative unificate pentru recomandări, la fel cum s-a întâmplat în NLP cu trecerea de la pipeline-uri specializate la modele mari pre-antrenate. Este foarte posibil ca în următorii doi-trei ani să vedem tot mai multe companii care renunță la cascadele tradiționale în favoarea unor abordări similare. Netflix, Spotify, Amazon sau Meta experimentează deja în această direcție, iar succesul lui Sona le va da curaj să accelereze.
Desigur, nu toată lumea va putea face acest salt. Un model generativ de recomandări are nevoie de date masive, de infrastructură de calcul serioasă și de expertiză în transformers. Pentru companiile mai mici, cascada tradițională rămâne o alegere pragmatică. Dar pentru giganții care își permit, Sona arată clar unde se îndreaptă viitorul.
Un ultim aspect care merită subliniat este modul în care Sona schimbă modul în care gândim despre recomandări. Nu mai vorbim despre „filtrare colaborativă” sau „ranking”, ci despre „generare de secvențe plauzibile”. Este o schimbare de vocabular care reflectă o schimbare de mentalitate. Recomandarea devine o problemă de modelare a limbajului comportamental, iar utilizatorul devine un text pe care modelul învață să îl continue. Este o viziune care poate părea abstractă, dar care are consecințe practice enorme.
De ce este important:
Sona nu este doar o inovație tehnică a Yandex, ci un semnal că întreaga industrie a sistemelor de recomandare se îndreaptă spre o nouă paradigmă. Înlocuirea cascadei tradiționale cu un singur model generativ simplifică dramatic infrastructura, reduce costurile și elimină compromisurile inerente optimizării locale. Pentru utilizatori, asta înseamnă recomandări mai relevante, mai diverse și mai puțin repetitive. Pentru companii, înseamnă echipe mai mici, pipeline-uri mai simple și timpi de inovare mai scurți. Iar pentru industrie în ansamblu, Sona demonstrează că principiile care au revoluționat NLP-ul — un singur model mare, antrenat end-to-end, capabil să genereze direct rezultatul final — funcționează și în recomandări. Este foarte probabil ca în următorii ani să asistăm la o migrație masivă a platformelor mari către abordări similare, iar cine nu se adaptează va rămâne în urmă. Într-o lume în care atenția utilizatorilor este cea mai valoroasă resursă, capacitatea de a genera recomandarea perfectă cu un singur model nu mai este un lux, ci o necesitate competitivă.