Subiect: #CUDA
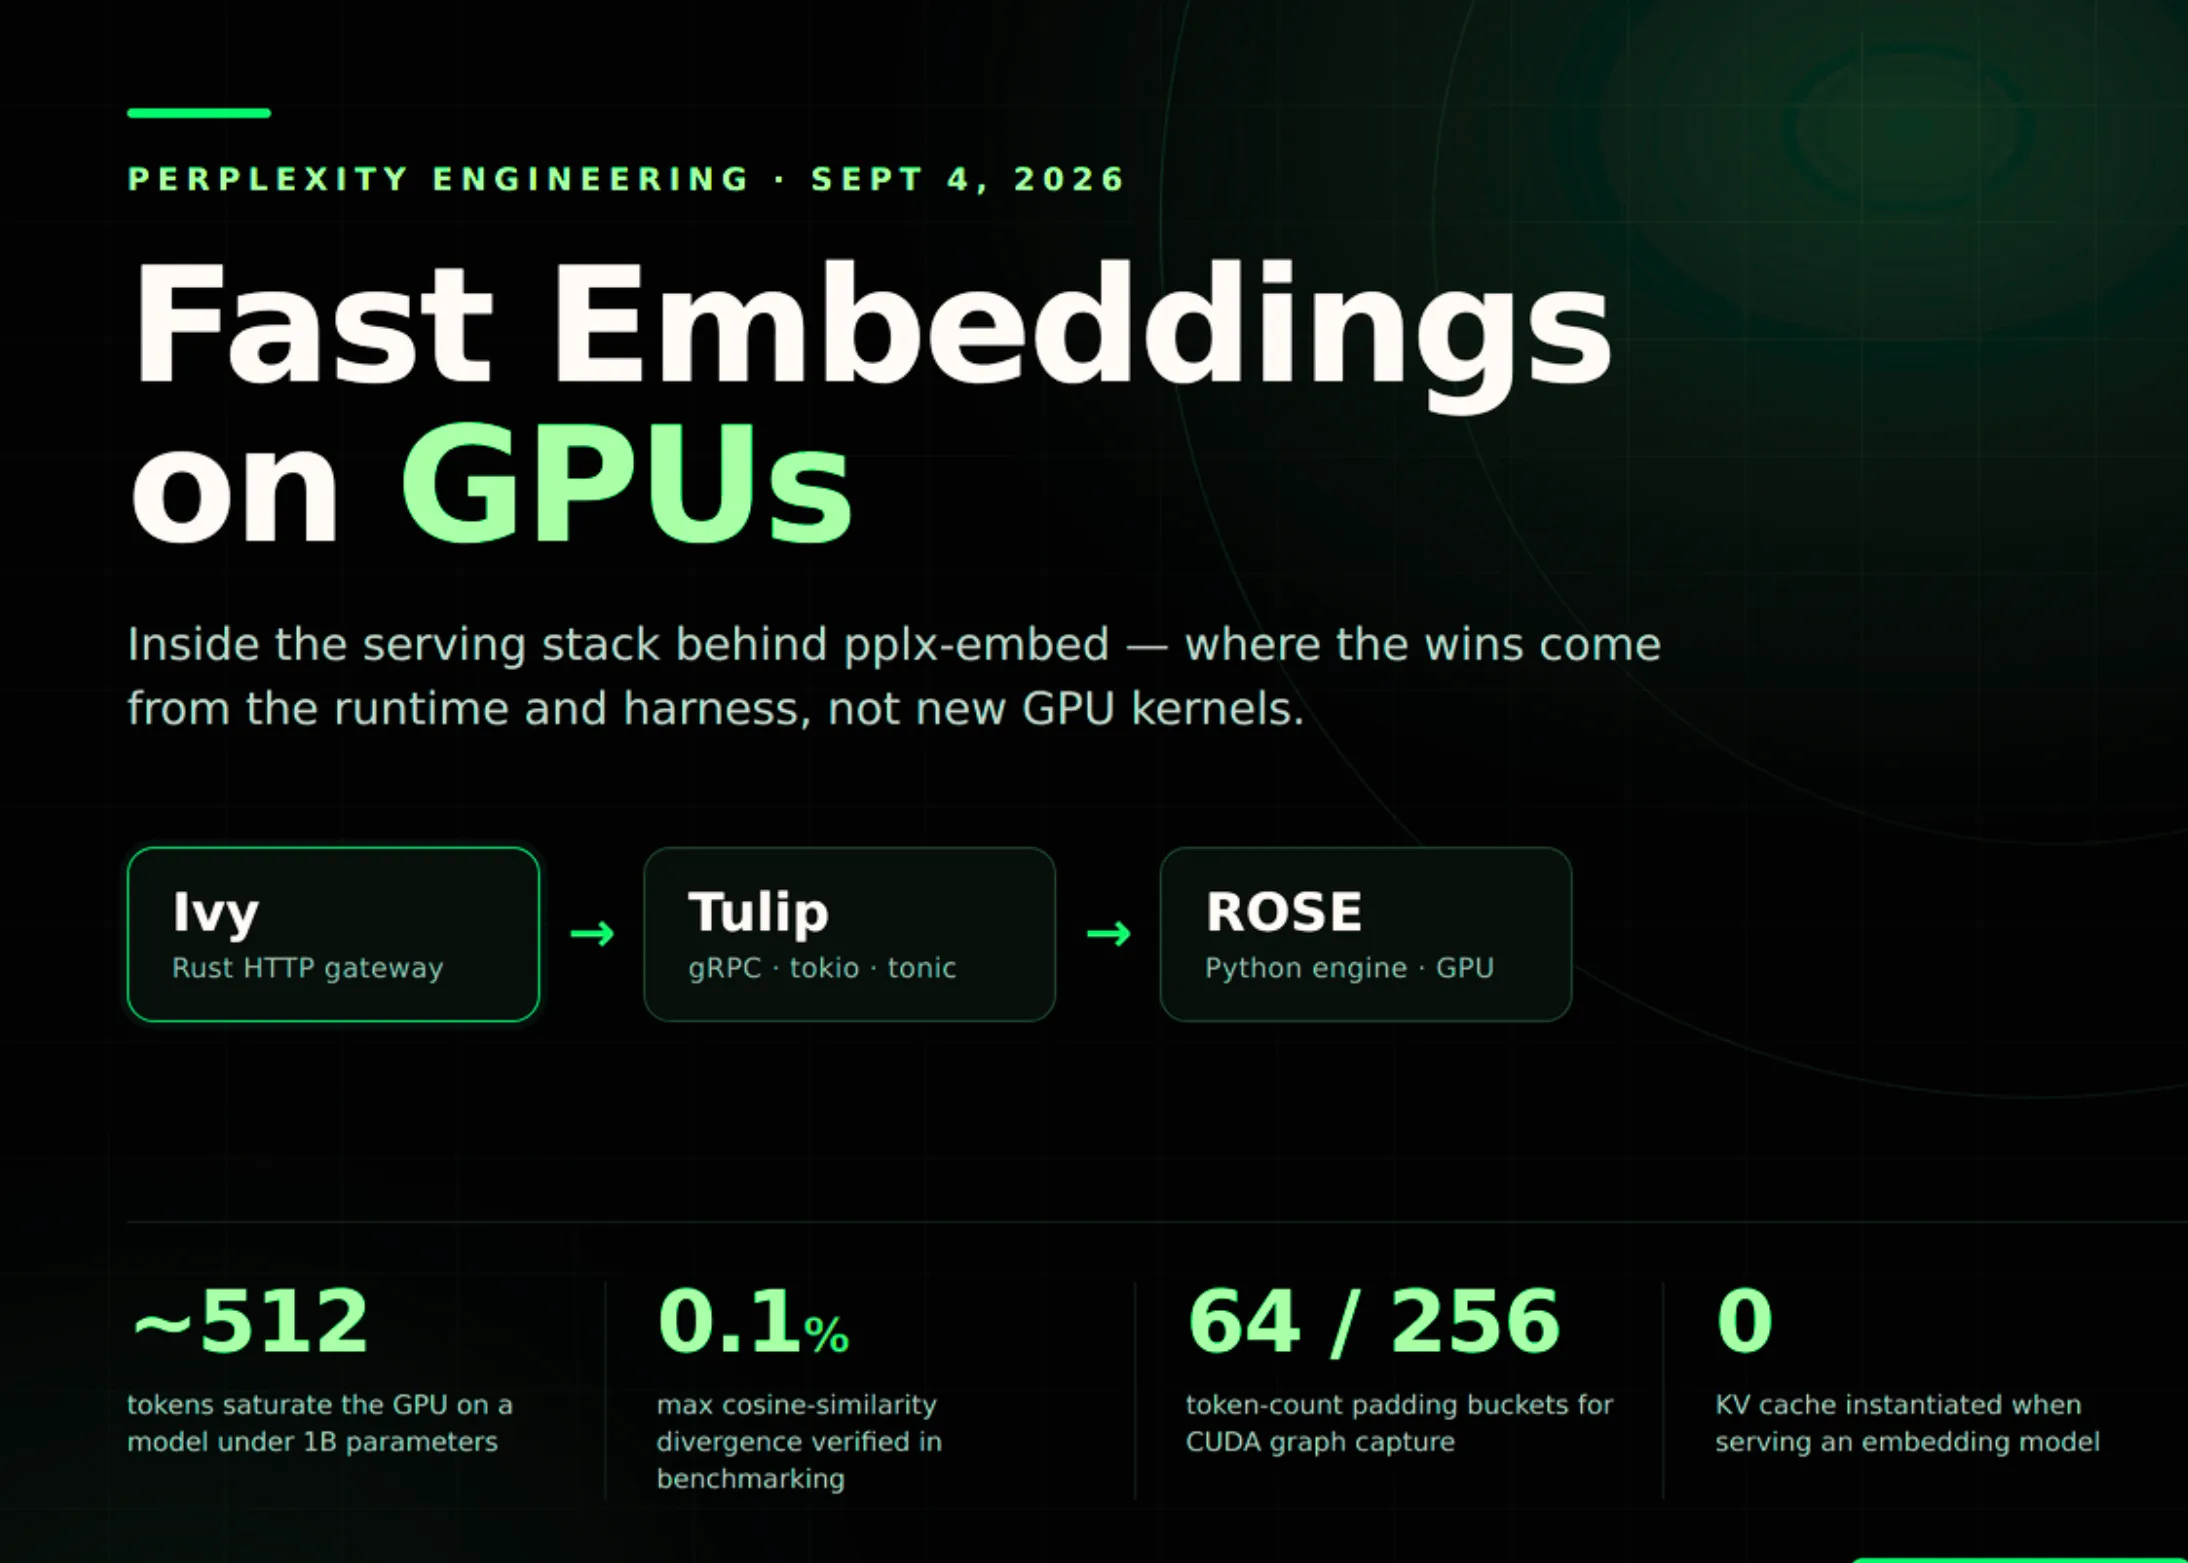
Perplexity dezvăluie arhitectura GPU a stivei de embedding: Cum Ivy, Tulip și ROSE alimentază pplx-embed
Perplexity AI dezvăluie pentru prima dată arhitectura completă a stivei sale de embedding GPU: Ivy (kerneli CUDA optimizați), Tulip (scheduler distribuit cu elastic batching) și ROSE (compresie vectorială ierarhică). Analizăm cum aceste trei componente reduc latenta, costurile și complexitatea la scară, și de ce această abordare "full-stack" devine noul standard pentru sistemele RAG de producție.

ByteDance și Tsinghua AIR lansează CUDA Agent: un sistem RL agentic la scară largă pentru generarea kernel-urilor CUDA
ByteDance Seed și Tsinghua AIR au lansat CUDA Agent, un sistem de învățare prin consolidare agentic la scară largă care generează automat kernel-uri CUDA optimizate. Acesta promite să revoluționeze programarea GPU, reducând timpul de dezvoltare și îmbunătățind performanța aplicațiilor de înaltă performanță.

Startup-ul Infinity strânge 15 milioane de dolari de la Touring Capital și cercetători OpenAI și Anthropic
Startup-ul Infinity, fondat de fostul cercetător Google Jeremy Nixon, a strâns 15 milioane de dolari de la Touring Capital și cercetători OpenAI și Anthropic pentru a construi un software universal care să permită oricărui cip AI să ruleze modele de inteligență artificială la performanțe comparabile cu Nvidia, amenințând dominația acesteia pe piață.
Ghid practic pentru programarea GPU pe bază de tile-uri: de la cuTile și Triton la Flash Attention
Un ghid practic pentru programarea GPU pe bază de tile-uri folosind cuTile, Triton și Flash Attention, cu exemple de kernel-uri și verificare în PyTorch. Învață cum să optimizezi operații precum adunarea vectorială, GELU, softmax, înmulțirea matricelor și atenția eficientă.
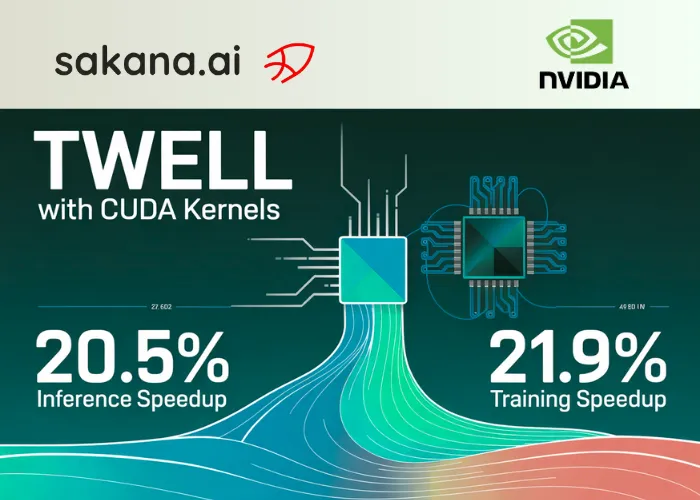
Sakana AI și NVIDIA lansează TwELL cu nuclee CUDA: accelerare cu 20,5% la inferență și 21,9% la antrenament pentru modelele de limbaj mari
Sakana AI și NVIDIA au lansat TwELL, o tehnologie care accelerează inferența cu 20,5% și antrenamentul cu 21,9% pentru modelele de limbaj mari, folosind nuclee CUDA optimizate. Articolul explică cum funcționează, impactul și importanța acestei inovații.
NVIDIA lansează cuda-oxide: un compilator experimental Rust-to-CUDA care compilează kernel-uri SIMT direct în PTX
NVIDIA a lansat cuda-oxide, un backend experimental de compilare care transformă kernel-uri SIMT scrise în Rust direct în PTX, deschizând calea către programarea GPU-urilor cu siguranța și performanța oferite de Rust.
Claude construiește kernele CUDA și instruiește modelele open-source: O revoluție în optimizarea AI
Un articol detaliat despre utilizarea modelului Claude pentru a genera și transfera abilități de programare CUDA către modele open-source mai mici, democratizând accesul la expertiza avansată în optimizarea GPU.