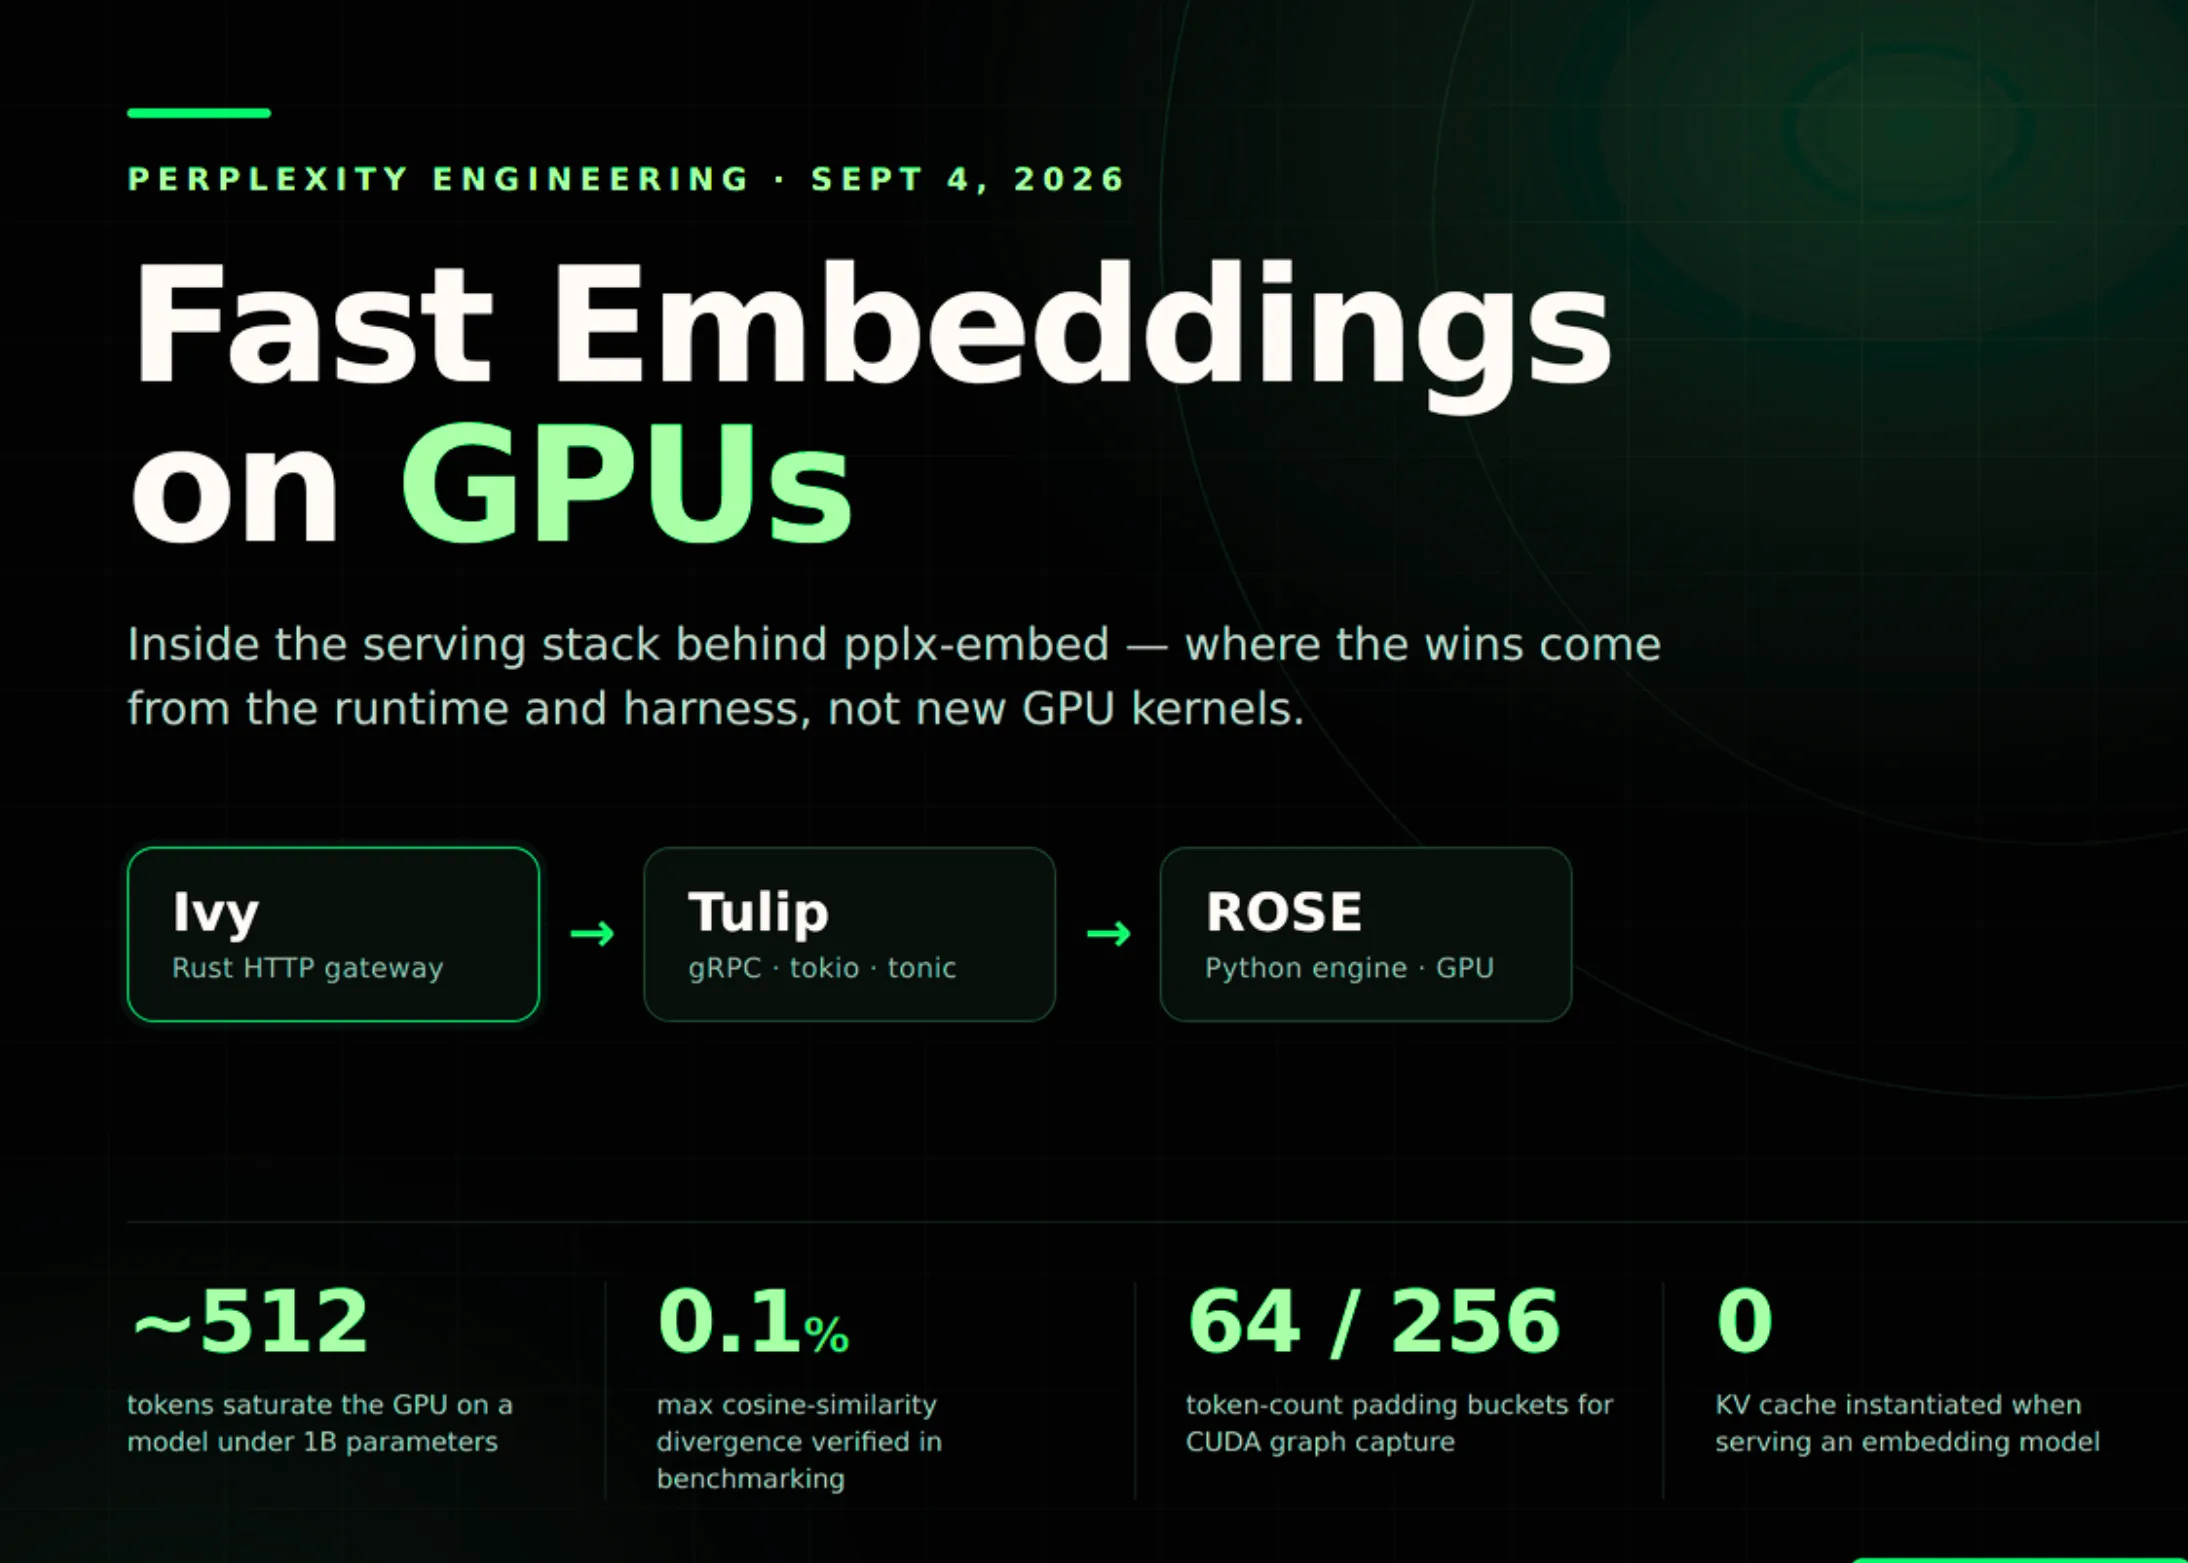
Pentru cei neinițiați, embedding-urile sunt ADN-ul invizibil al oricărui model de limbaj modern. Ele transformă cuvinte, propoziții, întregi documente în vectori densi de numere — coordonate într-un spațiu multidimensional unde semnificația devine geometrie. Când întrebați Perplexity "care este impactul economic al inteligenței artificiale în România", sistemul nu "citește" textul în sensul uman. El caută vecini apropiati în acel spațiu vectorial: articole academice, rapoarte FMI, analize McKinsey, postări de blog de la economiști români — toate proiectate în aceleași dimensiuni latente. Calitatea răspunsului depinde, în măsură decisivă, de calitatea acestui mapping.
Ivy: Fundația silicioasă
Primul pilon, Ivy, nu este un model per se, ci o bibliotecă de kerneli CUDA scrise de mână, optimizată pentru operațiunile de bază ale embedding-urilor: multiplicarea de matrice batched, normalizarea L2, produsele scalare masive. Ingenierii Perplexity au constatat că bibliotecile standard — cuBLAS, cuDNN, chiar FlashAttention — lăsau pe masă performanță critică la dimensiunile specifice embedding-urilor: batch-uri mici (32-128), secvențe scurte (128-512 tokeni), dar dimensionalități mari (1024-4096). Ivy refolosește registrii, minimizează round-trip-urile la memoria globală HBM și folosește tensor cores în mod asimetric: FP16 pentru accumulare, BF16 pentru stocare, FP32 pentru reducții critice.
Rezultatul? Un speedup de 2.3-3.1x față de PyTorch eager mode pe H100, și, poate mai important, o latită de coadă (tail latency) sub 5ms la p99 pentru cereri individuale. Într-un produs unde utilizatorul așteaptă răspunsul sub 2 secunde, fiecare milisecundă economisită la embedding se traduce direct în headroom pentru generare, reranking, verificare de fapte.
Tulip: Orhestrarea la scară
Dacă Ivy este motorul, Tulip este cutia de viteze și sistemul de direcție. Este un scheduler de inferență distribuit, gândit special pentru workload-uri de embedding heterogene: cereri interactive (utilizatorul tastează o întrebare), batch-uri de indexare (crawlerele care înghite site-uri noi), fine-tuning continuu (modelul își actualizează reprezentările pe noile date). Tulip nu folosește Kubernetes. El rulează direct pe bare metal, cu un allocator de memorie GPU custom care evită fragmentarea — problema care doare cel mai tare când modelele de 7B parametri trebuie să coexiste cu modelele de 400M parametri pe același cluster.
Inovația cheie a Tulip este "elastic batching": gruparea dinamică a cererilor care au același model-target și lungimi similare, cu un timeout configurabil de 2-8ms. Dacă nu s-au adunat suficiente cereri, Tulip lansează un micro-batch cu padding minim, folosind o tehnică de "ragged tensors" implementată la nivel de kernel Ivy. Aceasta reduce wasted compute la sub 3% — o cifră care face diferența între profitabilitate și ardere de cash la scară de milioane de query-uri pe zi.
ROSE: Compresia fără compromise
Al treilea pilon, ROSE (Recursive Orthogonal Subspace Embedding), atacă problema stocării și transferului. Un index vectorial pentru miliarde de documente la 4096 dimensiuni FP16 = teraocteți de VRAM și bandwidth. ROSE aplică o proiecție ortogonală recursivă, învățată end-to-end împreună cu modelul principal, care reduce dimensionalitatea la 256-512 cu o pierdere de recall@10 sub 0.8%. Dar geniul nu e compresia per se — e faptul că ROSE produce embedding-uri "nested": primele 64 dimensiuni capturen 85% din informație, primele 128 — 93%, etc. Aceasta permite o căutare ierarhică: filtru rapid pe 64D, reranking pe 256D, verificare finală pe 1024D — totul din același vector, fără re-encoding.
Implicațiile pentru ecosistem
De ce contează acest lucru dincolo de Perplexity? Pentru că stiva Ivy-Tulip-ROSE este, de facto, primul sistem de embedding "full-stack" expus public ca referință de arhitectură. Majoritatea companiilor (OpenAI, Anthropic, Cohere) tratează embedding-urile ca un black box: apelezi API-ul, primești vectori, plătești per token. Perplexity, prin natura sa de motor de căutare care trebuie să indexeze webul în timp real, a fost forțată să posede întregul pipeline. Și acum, prin articolele tehnice și, probabil, open-sourcing-ul parțial al componentelor, ele devin standardul de facto pentru oricine construiește RAG (Retrieval-Augmented Generation) la scară.
Pentru un startup românesc care construiește un asistent juridic pe bază de Codul Muncii și jurisprudență, adoptarea principiilor Ivy (kerneli custom pentru lungimi fixe de 512 tokeni), Tulip (elastic batching pentru cereri burst-y de la avocați) și ROSE (compresie nested pentru a păstra indexul pe un singur A100 80GB) poate reduce costurile de inferență cu 60-70% față de abordarea naivă "trimite tot la OpenAI embeddings API".
Riscurile și calea înaintare
Nu totul e roz. Ivy necesită ingineri CUDA de elită — o resursă mai rară decât GPUs. Tulip introduce complexitate operativă: debugging-ul unui scheduler custom distribuit e un capcană pentru echipe mici. ROSE necesită re-antrenarea modelului de embedding — nu poți aplica proiecția post-hoc fără pierderi majore. Perplexity are resursele să absoarbă aceste costuri. Majoritatea nu.
Totuși, direcția e clară: viitorul embedding-urilor nu e modele mai mari, ci sisteme mai smarte care le servesc. Ivy, Tulip, ROSE sunt prima manifestare coerentă a acestei filosofii. Urmează să vedem dacă comunitatea le adoptă, le forkează, le îmbunătățește — sau dacă rămân un monolit proprietary al unui unicorn care a înțeles că în era generativă, căutarea e rege și embedding-ul e coroana.
De ce este important:
Această dezvăluire arhitecturală marchează trecerea de la "embedding-uri ca serviciu" la "embedding-uri ca infrastructură posedită". Pentru companiile care construiesc produse AI la scară, înțelegerea și adoptarea principiilor Ivy (kerneli specializați), Tulip (scheduling elastic) și ROSE (compresie ierarhică) poate reprezenta diferența între o infrastructură costisitoare și una eficientă economic. De asemenea, semnifică că Perplexity investește masiv în diferentiere tehnică profundă, nu doar în interfețe de utilizator — un semn al maturității industriei.