Subiect: #Fine-Tuning
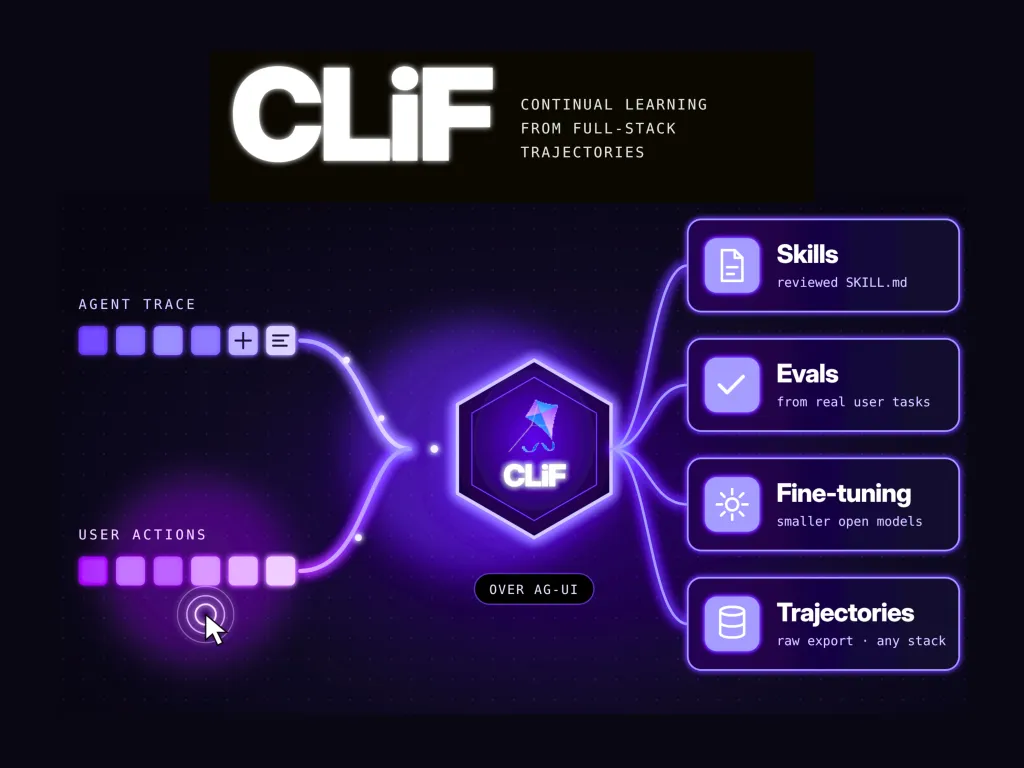
CopilotKit lansează CLiF: platforma care transformă fiecare interacțiune a agenților AI în combustibil pentru îmbunătățire continuă
CopilotKit a lansat CLiF, o platformă de învățare continuă care transformă traseele agenților AI și acțiunile utilizatorilor în skill-uri noi, evaluări automate și date pentru fine-tuning. Practic, fiecare interacțiune devine combustibil pentru îmbunătățirea agentului.
Când un model de încredere își schimbă codul: cum Unsloth Studio verifică din nou înainte să ruleze ceva
Un repository de model AI considerat de încredere se poate schimba peste noapte, iar consecințele pot fi grave. Unsloth Studio a introdus un mecanism de re-verificare automată înainte de rulare, transformând verificarea integrității dintr-o practică opțională într-un comportament implicit. O analiză despre supply chain-ul de modele AI, încrederea oarbă în open source și de ce igiena digitală contează mai mult ca niciodată.
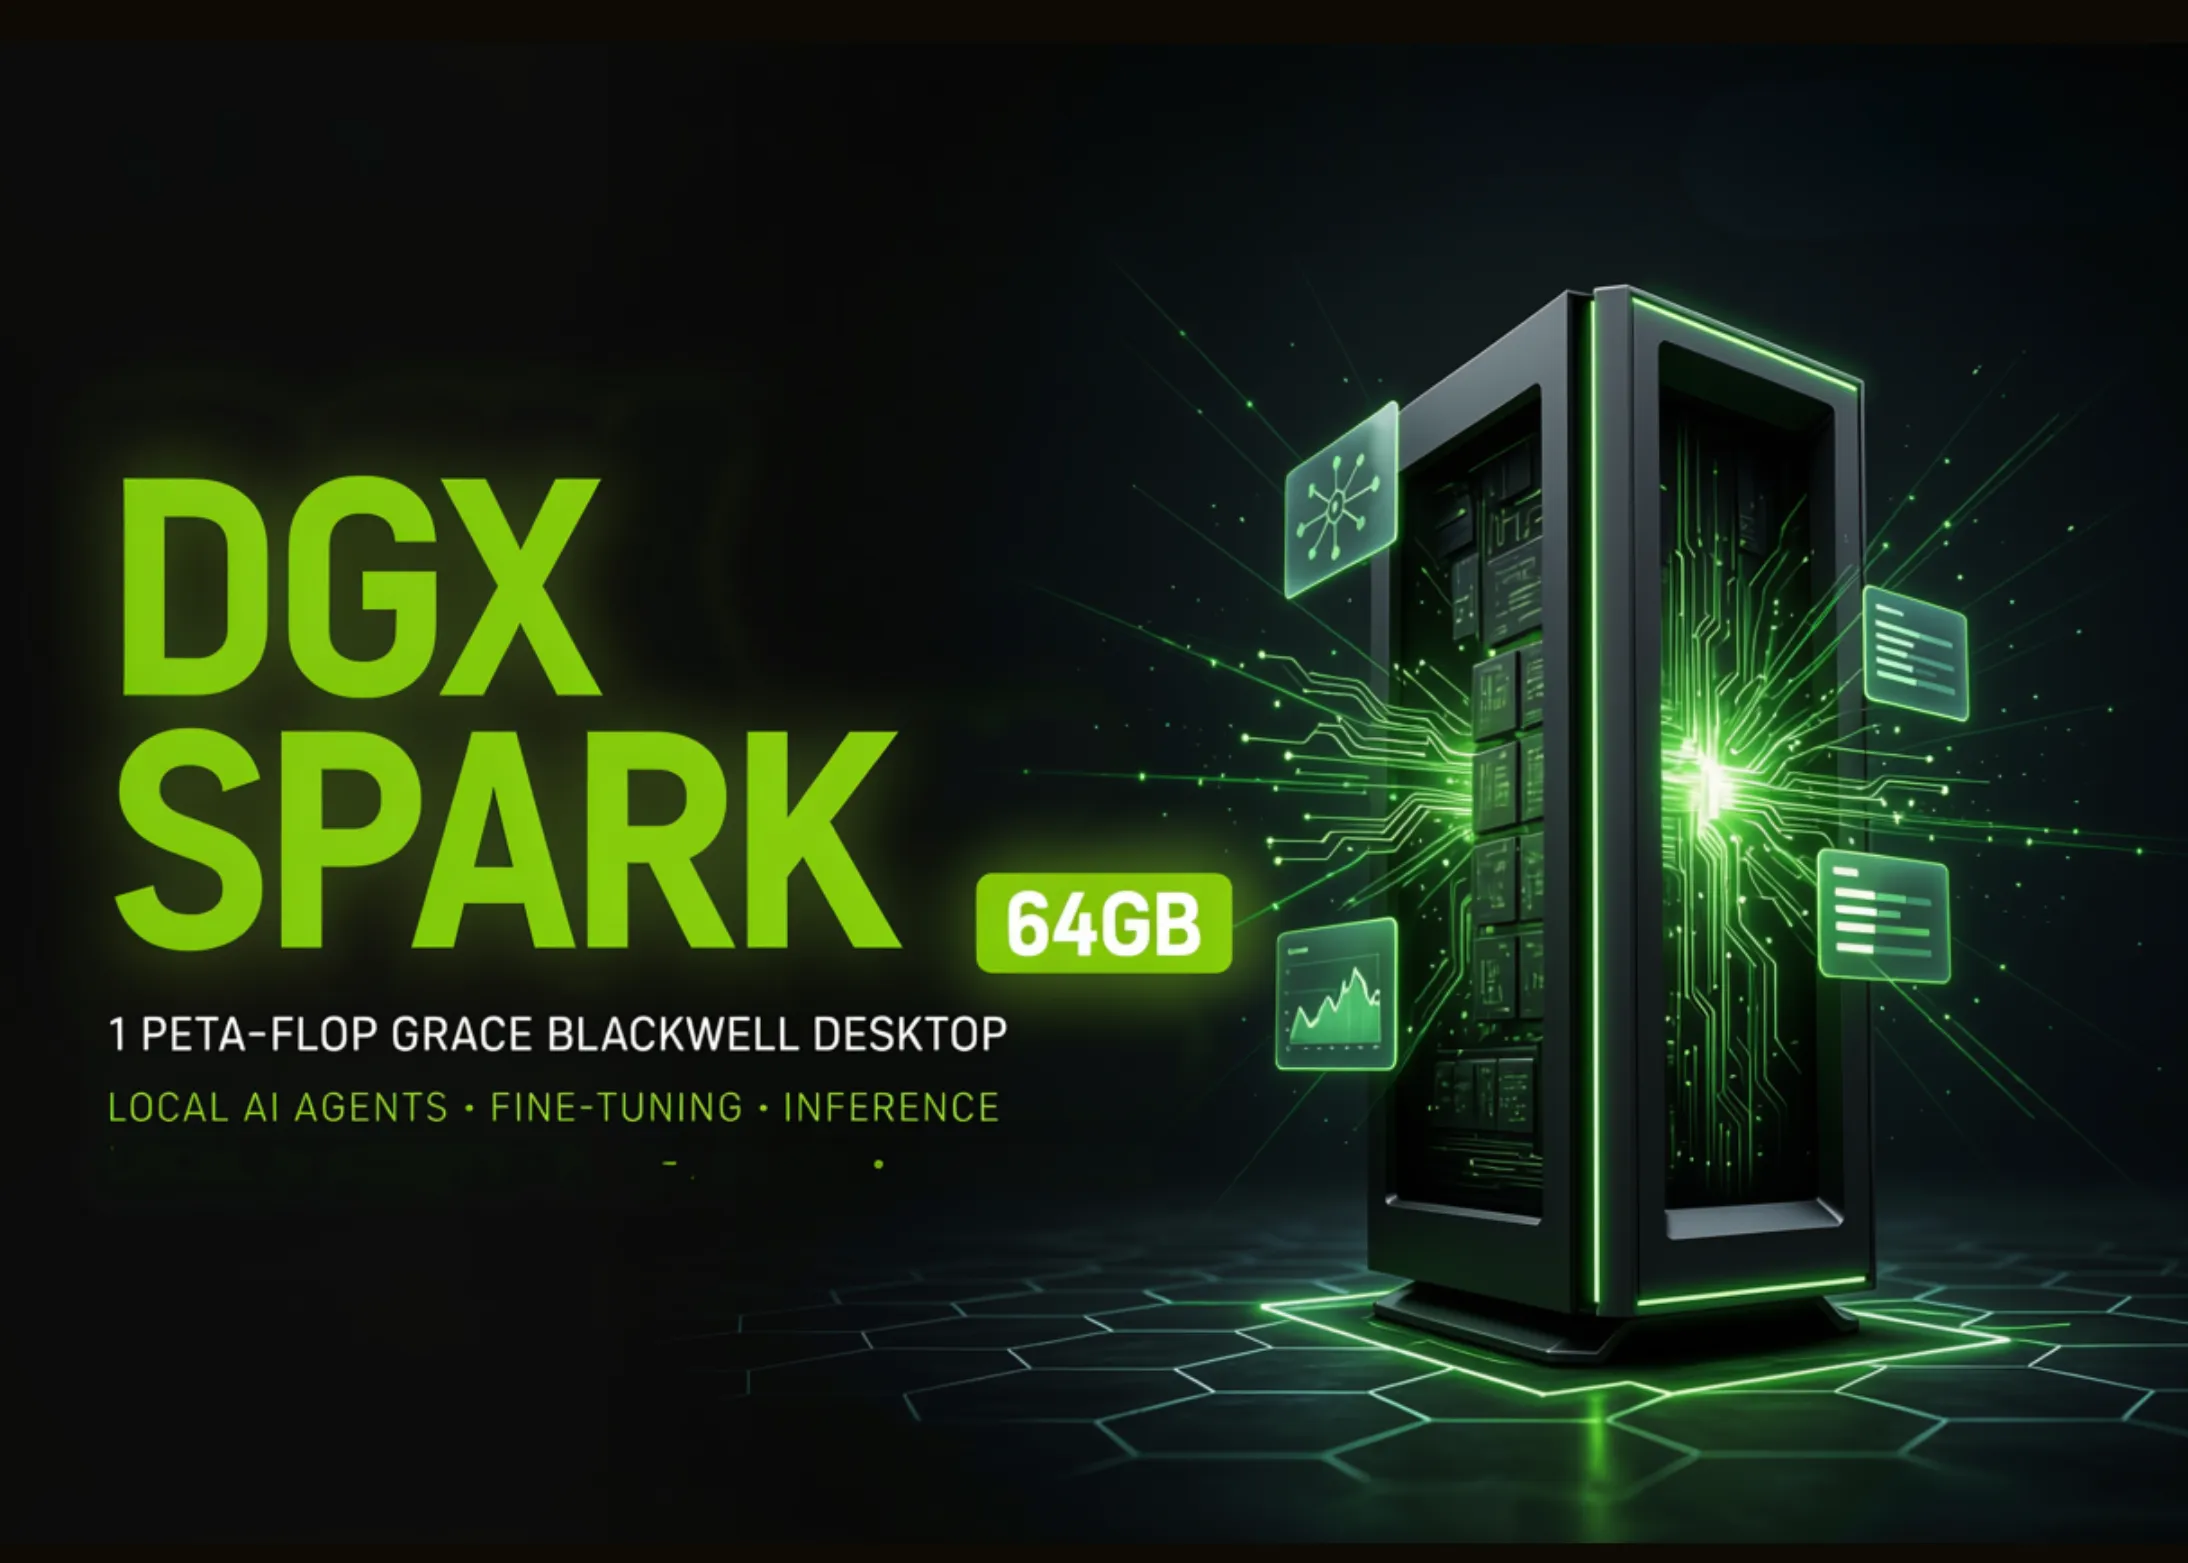
NVIDIA lansează DGX Spark 64GB: un monstru de 1 PetaFLOP pe birou, pentru agenți AI locali și fine-tuning
NVIDIA a anunțat DGX Spark 64GB, o stație de lucru compactă bazată pe arhitectura Grace Blackwell, care livrează 1 PetaFLOP de putere AI direct pe birou. Dispozitivul este gândit pentru agenți AI locali, fine-tuning pe date private și inferență fără dependență de cloud, promițând să democratizeze accesul la AI de înaltă performanță.
Cum să construiești un model de limbaj axat pe raționament: ghid practic pentru streaming, curatare și fine-tuning cu SupraLabs
Un ghid practic pentru construirea unui model de limbaj mic, dar specializat în raționament, folosind streaming-ul datelor SupraLabs, filtrarea calității și fine-tuning cu LoRA pe SmolLM2-135M-Instruct. Articolul analizează fiecare etapă și subliniază importanța accesibilității în AI.
Construirea datelor de instruire supravegheată din Open-SWE-Traces de la NVIDIA: analiza traiectoriilor, patch-urilor, bugetelor de tokeni și metricilor de utilizare a uneltelor
În acest articol, învățăm cum să prelucrăm setul de date Open-SWE-Traces de la NVIDIA pentru a crea date de instruire supravegheată. Parcurgem pașii esențiali: parsarea traiectoriilor, analiza patch-urilor, gestionarea bugetelor de tokeni și evaluarea metricilor de utilizare a uneltelor, totul într-un mediu Google Colab.
Cum să ajustezi fin LFM2 folosind QLoRA și DPO: Ghid pas cu pas pentru Google Colab
Un ghid complet pentru ajustarea fină a modelului LFM2 folosind QLoRA și DPO în Google Colab, incluzând configurarea mediului, încărcarea modelului, antrenarea și testarea, cu accent pe eficiență și resurse accesibile.
Cum să folosești AgentTrove: Transmite în flux 1,7 milioane de urme agentice și construiește un set de date SFT curat în stil ShareGPT în Python
Descoperă cum să accesezi și să procesezi peste 1,7 milioane de urme agentice din AgentTrove folosind Python, transformându-le într-un set de date SFT curat în stil ShareGPT, gata pentru antrenarea modelelor de limbaj.
Sistemul Meta al Poetiq construiește automat un ham independent de model care a îmbunătățit fiecare LLM testat pe LiveCodeBench Pro, fără fine-tuning
Poetiq a dezvoltat un meta-sistem care construiește automat un ham independent de model, capabil să îmbunătățească performanța oricărui LLM pe benchmark-ul LiveCodeBench Pro, fără a necesita fine-tuning. Rezultatele arată creșteri semnificative ale scorurilor pentru toate modelele testate, deschizând calea către o nouă paradigmă în optimizarea inteligenței artificiale.
Implementare codificare pentru parsarea, analiza, vizualizarea și ajustarea fină a urmelor de raționament ale agenților folosind setul de date lambda/hermes-agent-reasoning-traces
Acest articol prezintă o implementare practică pentru parsarea, analiza, vizualizarea și ajustarea fină a urmelor de raționament ale agenților AI, folosind setul de date lambda/hermes-agent-reasoning-traces. Sunt explicate structura datelor, metodele de extragere a componentelor cheie, analiza tiparelor, vizualizarea fluxurilor de gândire și tehnicile de fine-tuning pentru îmbunătățirea performanței agenților.
Presupunerea LoRA care eșuează în producție
LoRA este o tehnică populară de fine-tuning, dar în producție, presupunerea că funcționează la fel ca fine-tuning-ul complet se sparge adesea. Află care sunt capcanele și cum să le eviți.
Jupyter Agents: Antrenarea modelelor de limbaj pentru raționament bazat pe notebook-uri
Jupyter Agent reprezintă o inovație majoră în antrenarea modelelor de limbaj de mici dimensiuni pentru a raționa și executa cod în medii Jupyter. Proiectul detaliază un pipeline complex de curățare a datelor din Kaggle și fine-tuning, demonstrând cum modelele mici pot deveni agenți eficienți în știința datelor.
Together AI și Hugging Face revoluționează antrenarea modelelor: Acum poți adapta orice LLM în doar câteva minute
Parteneriatul dintre Together AI și Hugging Face permite dezvoltatorilor să efectueze fine-tuning pe orice model LLM compatibil direct prin infrastructura cloud, eliminând complexitatea tehnică și reducând timpul de la descoperire la implementare la doar câteva minute.