Subiect: #GPTQ
AI
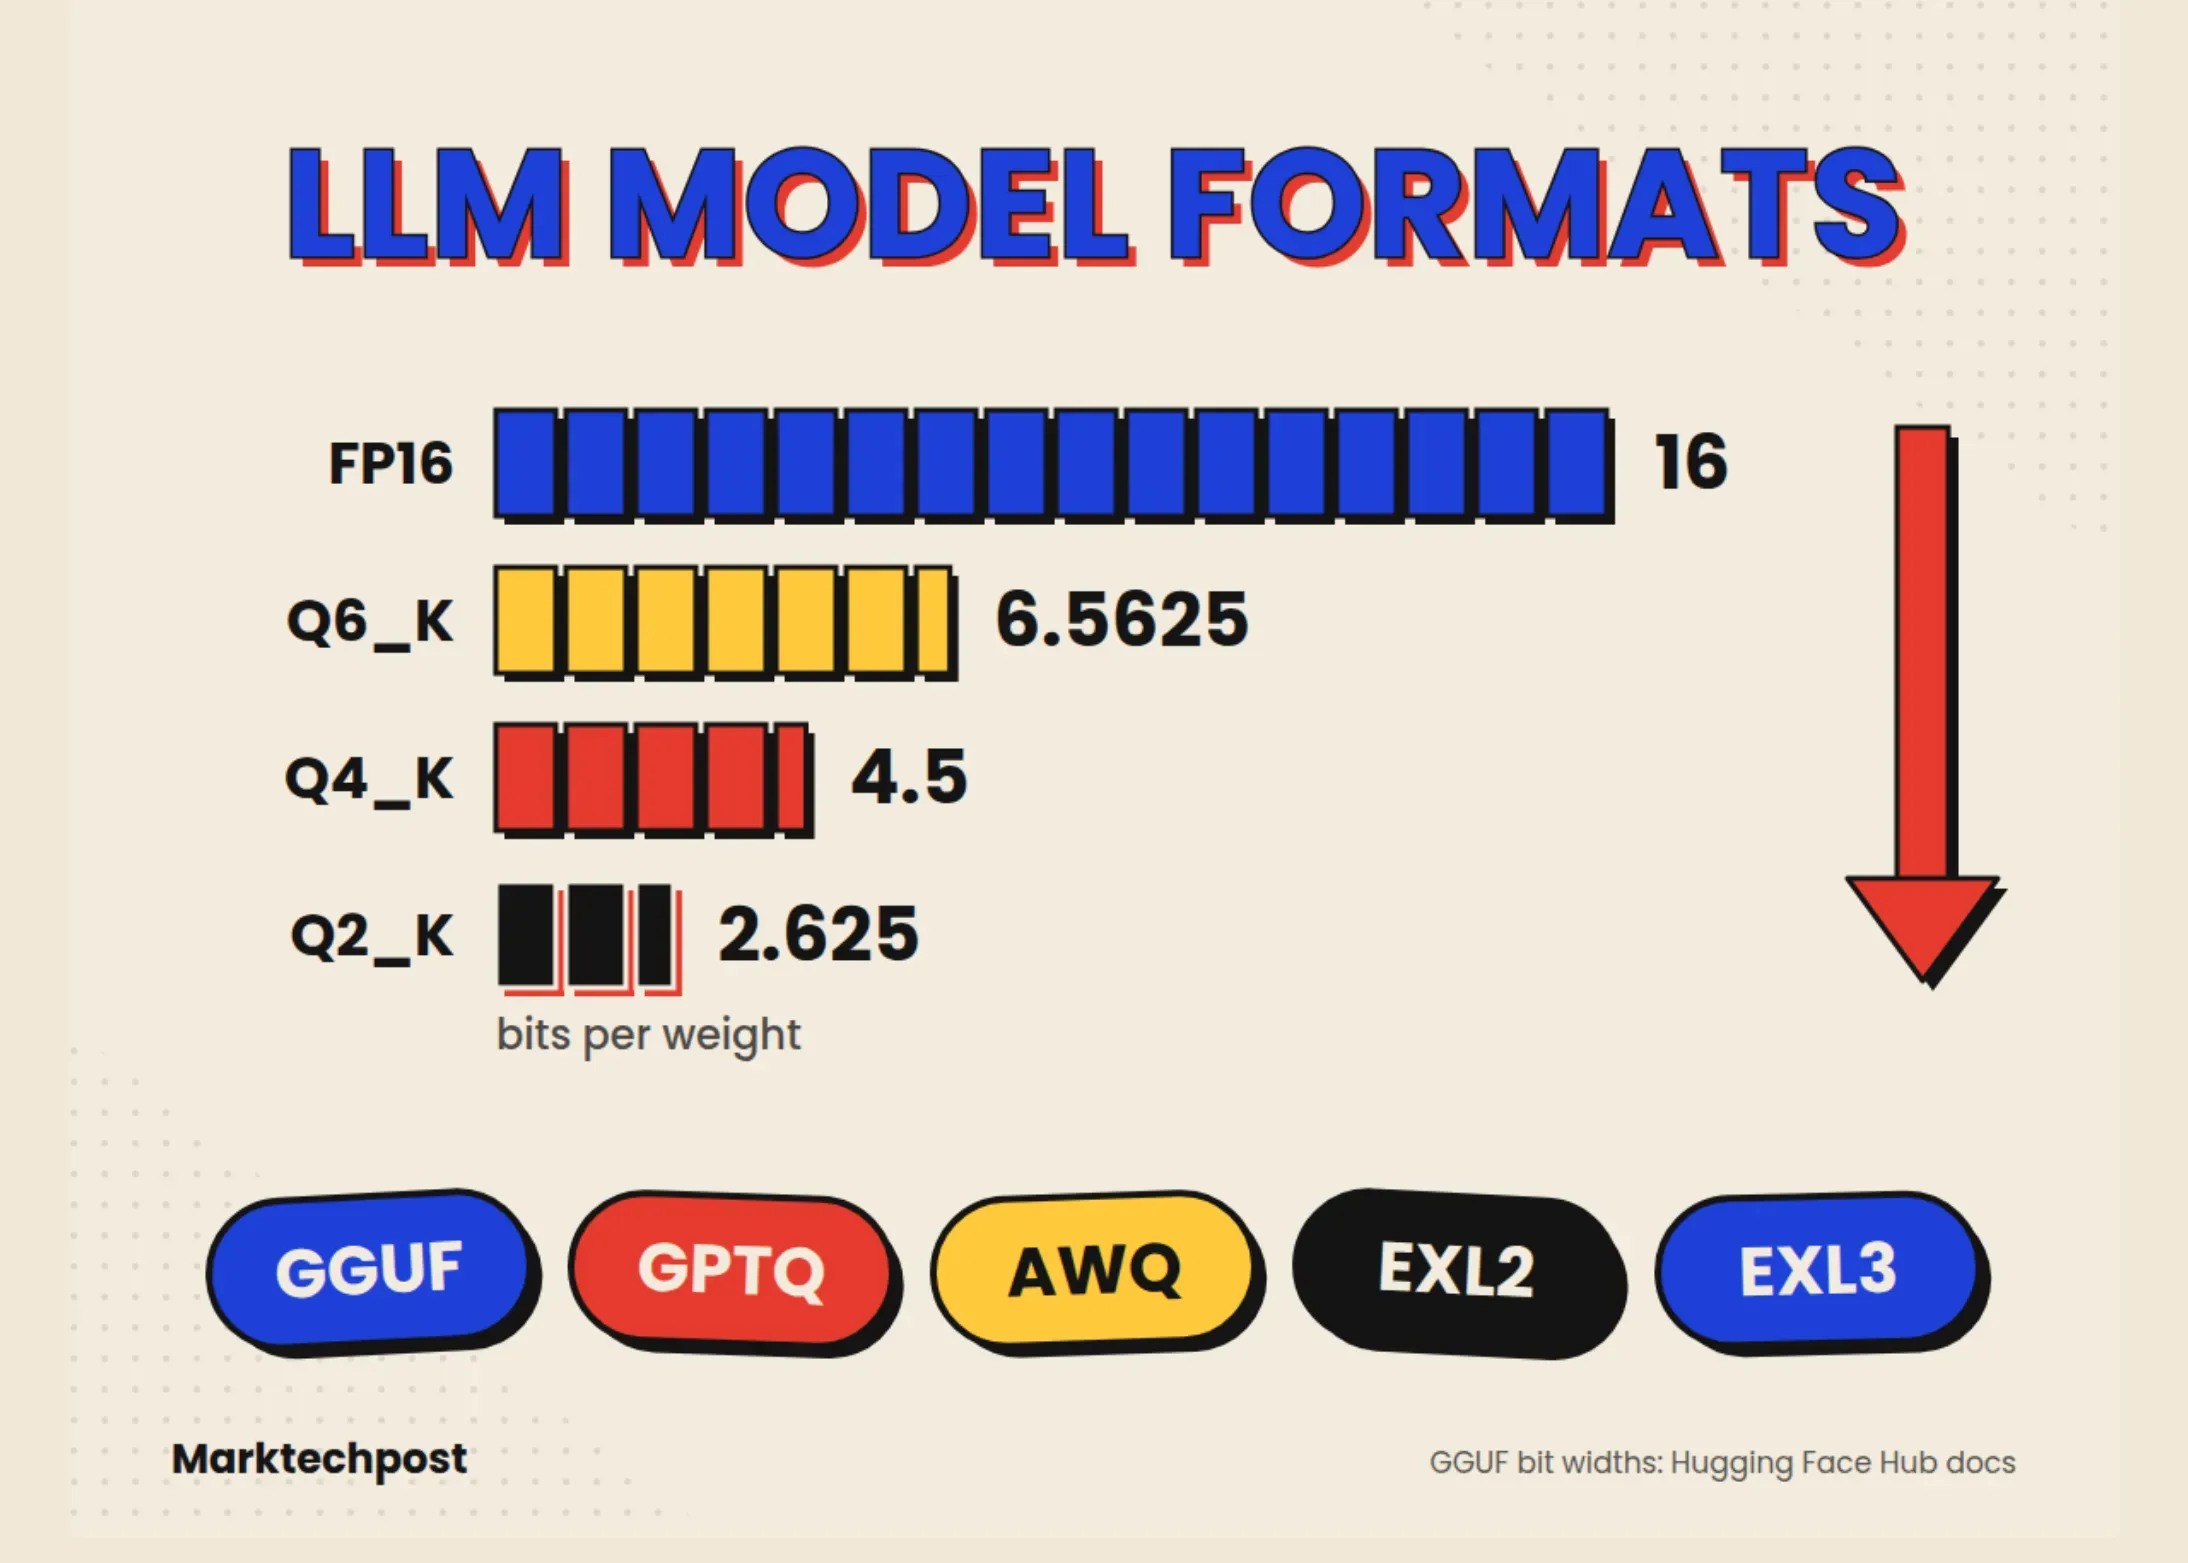
GGUF vs GPTQ vs AWQ vs EXL2: Formatele modelelor LLM explicate (2026)
Descoperiți diferențele dintre formatele de modele LLM: GGUF, GPTQ, AWQ și EXL2. Aflați care este cel mai potrivit pentru hardware-ul și nevoile dumneavoastră în 2026.
AI
Cum să comprimi și să evaluezi modelele lingvistice instruite cu FP8, GPTQ și SmoothQuant folosind llmcompressor
Află cum poți comprima modelele lingvistice instruite (instruction-tuned LLMs) folosind FP8, GPTQ și SmoothQuant cu ajutorul bibliotecii llmcompressor. Articolul explică pașii de implementare, rezultatele benchmark-urilor și importanța cuantizării pentru eficiență și accesibilitate.