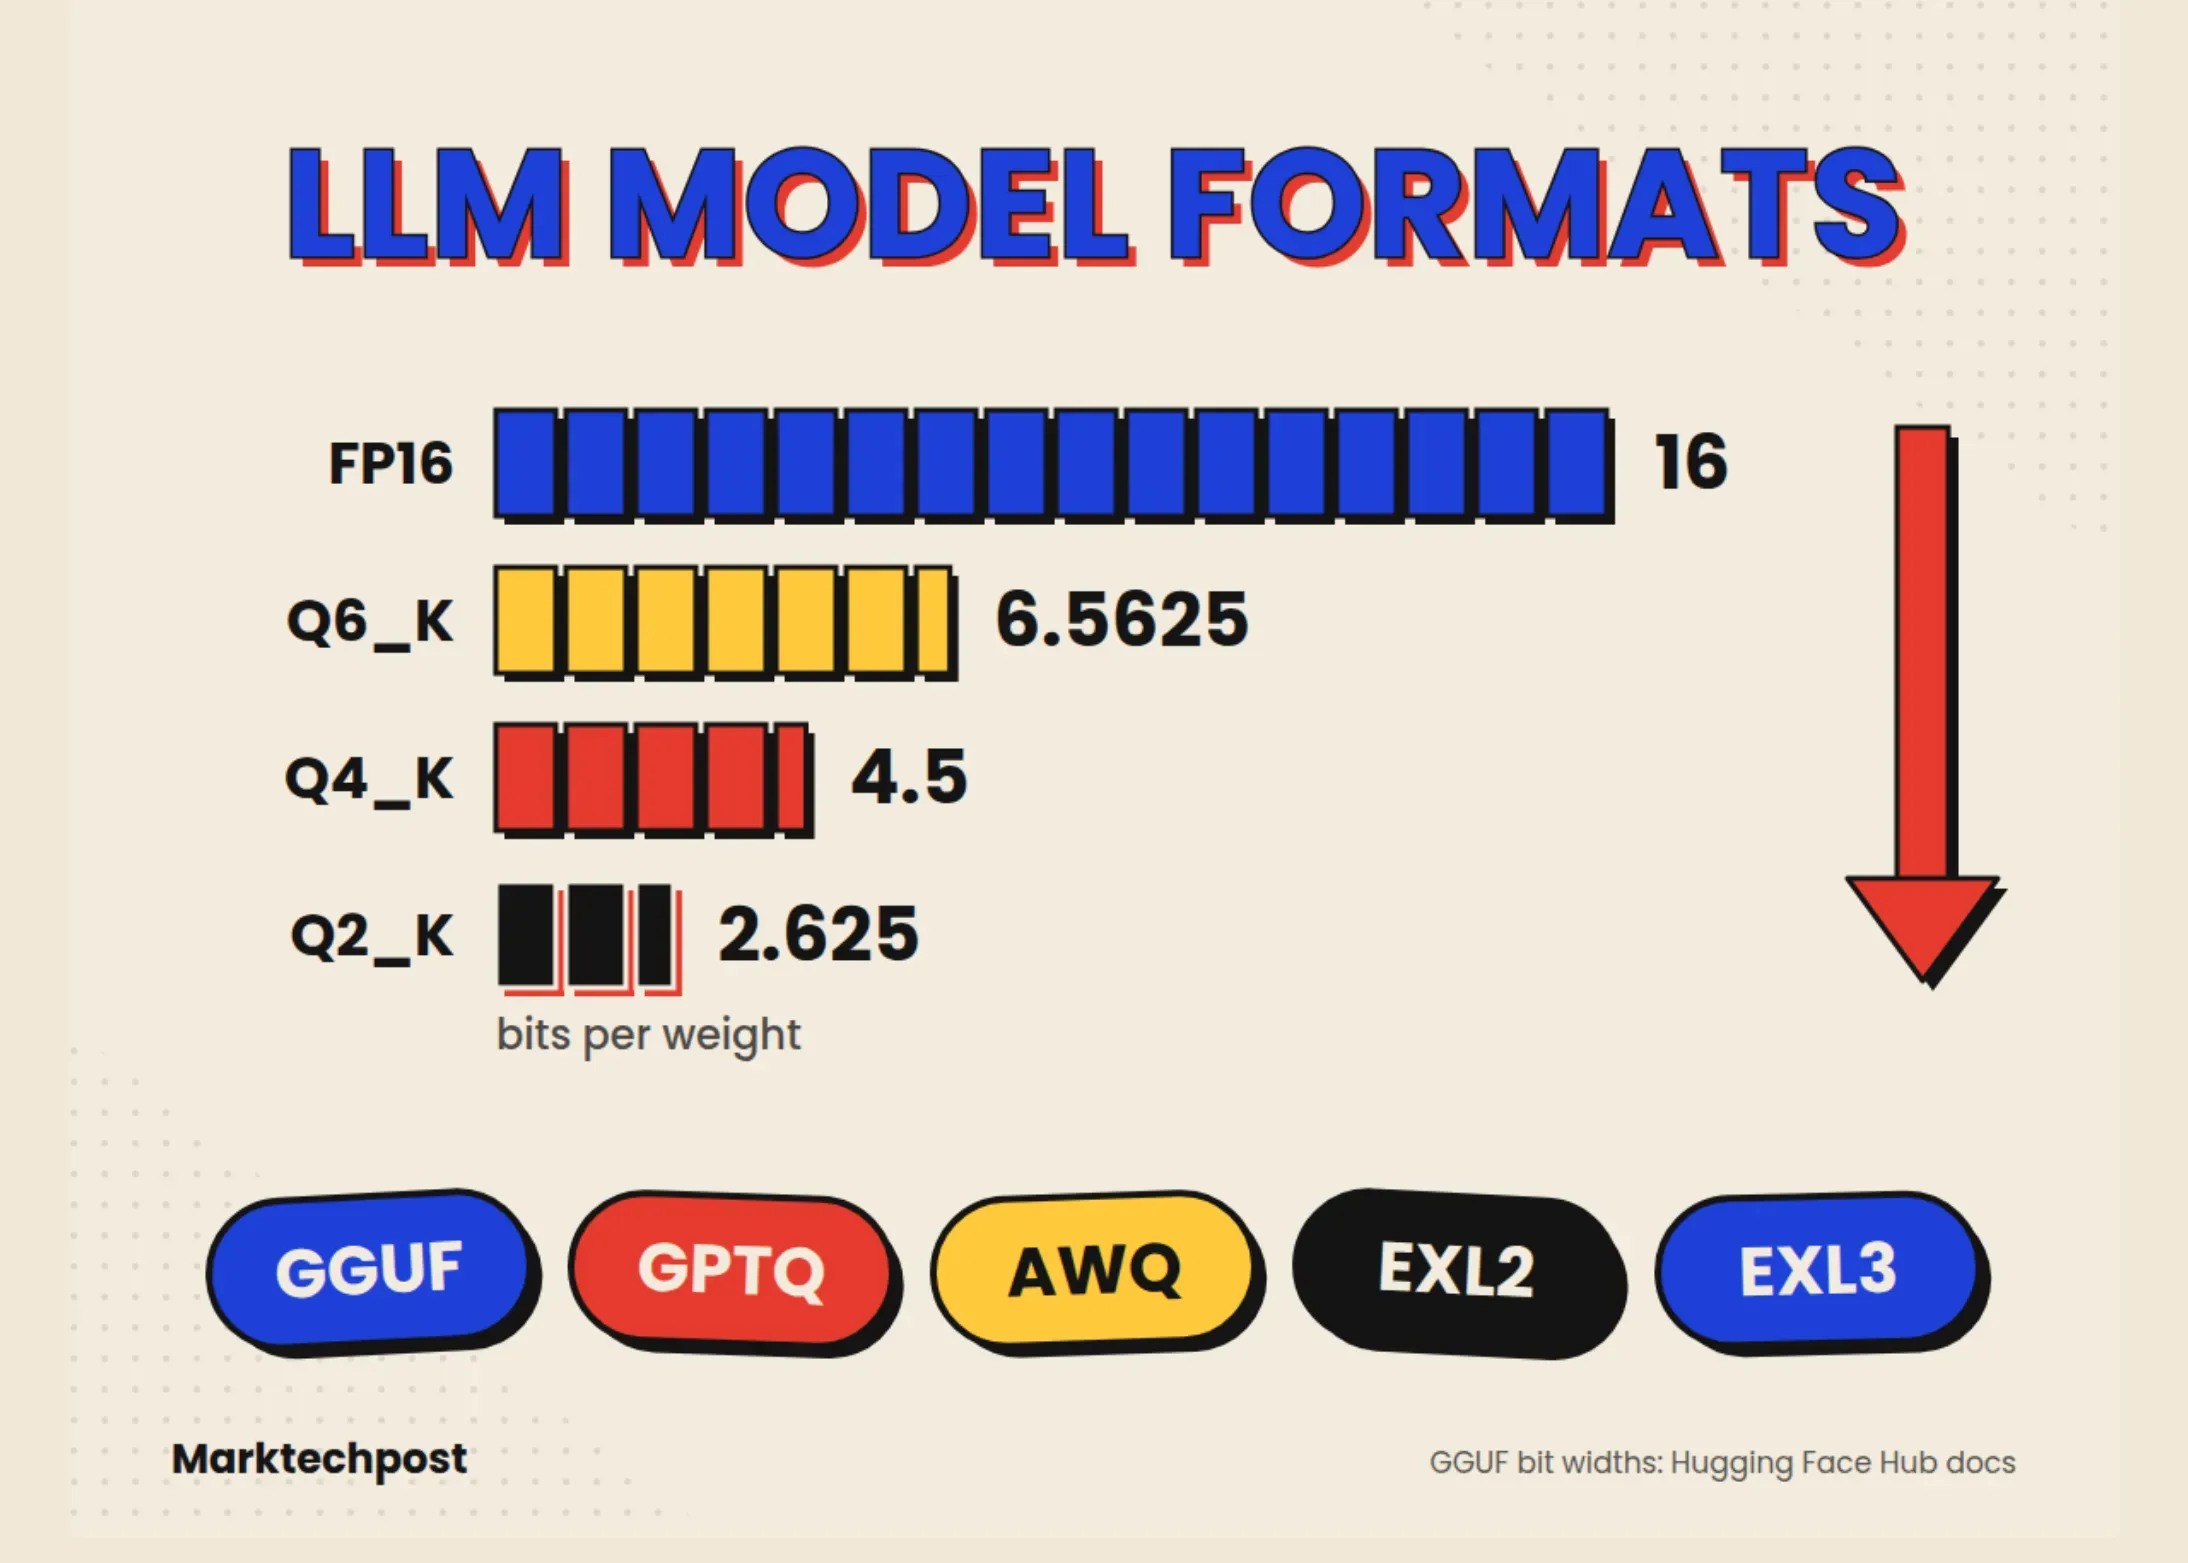
Ce sunt formatele de modele LLM?
Înainte de a intra în detalii, să clarificăm ce înseamnă un „format” de model. Un model LLM este, în esență, o rețea neuronală cu miliarde de parametri. Acești parametri sunt stocați ca numere în virgulă mobilă, de obicei în precizie de 32 de biți (FP32) sau 16 biți (FP16). Aceste fișiere sunt extrem de mari – un model cu 7 miliarde de parametri poate ocupa peste 14 GB în FP16. Pentru a rula astfel de modele pe hardware de consum, cum ar fi GPU-urile cu 8-12 GB VRAM, este necesară cuantizarea – procesul de reducere a preciziei numerelor pentru a micșora dimensiunea fișierului și a accelera inferența. Formatele precum GGUF, GPTQ, AWQ și EXL2 sunt metode diferite de cuantizare și ambalare a modelelor, fiecare cu propriul său compromis între dimensiune, viteză și calitate.
GGUF – Succesorul lui GGML
GGUF (GPT-Generated Unified Format) este un format dezvoltat de comunitatea llama.cpp, creat ca o evoluție a formatului GGML. Este conceput pentru a fi extrem de flexibil și eficient pe CPU, dar și pe GPU. GGUF utilizează o cuantizare cu mai multe niveluri, permițând utilizatorilor să aleagă între diferite grade de precizie, de la 2 biți până la 8 biți. Unul dintre principalele avantaje ale GGUF este că poate fi rulat direct pe CPU, fără a necesita o placă grafică dedicată, ceea ce îl face ideal pentru sistemele cu resurse limitate. De asemenea, GGUF suportă încărcarea parțială a modelului pe GPU, permițând o utilizare hibridă CPU+GPU. În 2026, GGUF este considerat standardul de facto pentru rularea modelelor pe hardware local, datorită compatibilității sale largi cu instrumente precum llama.cpp, Ollama și LM Studio.
GPTQ – Optimizat pentru GPU-uri NVIDIA
GPTQ (Generative Pre-trained Transformer Quantization) este o tehnică de cuantizare dezvoltată de cercetătorii de la Universitatea din California, Berkeley. Aceasta este special concepută pentru a reduce dimensiunea modelelor, păstrând în același timp o calitate ridicată a predicțiilor. GPTQ funcționează prin cuantizarea ponderilor modelului la 4 biți sau 3 biți, folosind o metodă de optimizare care minimizează eroarea de cuantizare. Acest format este optimizat pentru GPU-urile NVIDIA, deoarece utilizează operații de matematică pe care acestea le execută extrem de rapid. GPTQ este adesea preferat pentru inferență pe GPU-uri cu VRAM limitată, deoarece oferă un echilibru excelent între viteză și calitate. Cu toate acestea, GPTQ nu este la fel de flexibil ca GGUF în ceea ce privește rularea pe CPU, iar suportul pentru alte mărci de GPU este limitat.
AWQ – Cuantizare bazată pe activare
AWQ (Activation-aware Weight Quantization) este o abordare mai recentă, dezvoltată de cercetătorii de la MIT și alte instituții. Spre deosebire de GPTQ, care se concentrează doar pe ponderi, AWQ ia în considerare și distribuția activărilor (valorile intermediare) în timpul inferenței. Aceasta permite o cuantizare mai inteligentă, păstrând mai multă precizie pentru ponderile care au un impact mai mare asupra rezultatului final. AWQ este adesea considerat superior GPTQ în ceea ce privește calitatea, mai ales la niveluri de cuantizare agresive (3 biți sau mai puțin). De asemenea, AWQ este proiectat să fie eficient pe GPU-uri, dar are și suport pentru CPU, deși mai puțin optimizat decât GGUF. În 2026, AWQ câștigă popularitate datorită calității sale superioare, dar suportul său este încă în creștere, iar unele instrumente nu îl acceptă încă.
EXL2 – Formatul rapid și eficient pentru ExLlama
EXL2 este un format dezvoltat special pentru biblioteca ExLlama, un motor de inferență extrem de rapid pentru GPU-uri. Acest format este optimizat pentru a profita la maximum de arhitectura GPU-urilor moderne, oferind viteze de inferență impresionante. EXL2 utilizează o cuantizare cu precizie variabilă, permițând utilizatorilor să amestece diferite niveluri de cuantizare pentru diferite părți ale modelului, pentru a obține cel mai bun compromis între dimensiune și calitate. Unul dintre avantajele majore ale EXL2 este că este extrem de eficient în utilizarea VRAM-ului, permițând rularea modelelor mari pe GPU-uri cu mai puțină memorie. Cu toate acestea, EXL2 este limitat la GPU-uri NVIDIA și necesită utilizarea bibliotecii ExLlama, care este mai puțin cunoscută decât alte instrumente. Pentru utilizatorii care doresc cea mai rapidă inferență posibilă pe hardware NVIDIA, EXL2 este adesea alegerea ideală.
Comparație și cum să alegi
Atunci când alegeți un format, trebuie să luați în considerare mai mulți factori: hardware-ul disponibil, tipul de aplicație și preferințele personale. Dacă rulați pe CPU sau pe un sistem cu GPU slab, GGUF este cea mai sigură alegere, datorită flexibilității sale și suportului larg. Dacă aveți un GPU NVIDIA cu VRAM limitată și doriți o viteză bună, GPTQ este o opțiune solidă, dar AWQ oferă o calitate mai bună la aceeași dimensiune. Dacă sunteți un entuziast care dorește să obțină performanțe maxime de pe un GPU NVIDIA, EXL2 este de neegalat în viteză, dar necesită unelte specifice. În practică, mulți utilizatori experimentează cu mai multe formate pentru a găsi cel care se potrivește cel mai bine nevoilor lor. De asemenea, este important să verificați compatibilitatea cu software-ul pe care îl utilizați, deoarece nu toate instrumentele suportă toate formatele.
Tendințe și viitorul formatelor
Pe măsură ce hardware-ul evoluează, la fel și formatele de modele. În 2026, vedem o tendință către cuantizare din ce în ce mai agresivă, cu modele care pot rula pe dispozitive mobile și embedded. De asemenea, apar noi tehnici care combină avantajele mai multor formate, cum ar fi cuantizarea adaptivă bazată pe conținut. Este posibil ca în viitor să vedem un format unificat care să ofere atât flexibilitatea GGUF, cât și viteza EXL2. Până atunci, este esențial să rămâneți la curent cu ultimele evoluții și să alegeți formatul care se potrivește cel mai bine proiectului dumneavoastră.
De ce este important:
Înțelegerea formatelor de modele LLM este crucială pentru oricine dorește să ruleze modele de limbaj local, fie pentru dezvoltare, cercetare sau aplicații practice. Alegerea corectă a formatului poate reduce semnificativ costurile hardware, îmbunătăți performanța și asigura o experiență fluidă. Într-o eră în care inteligența artificială devine din ce în ce mai accesibilă, cunoașterea acestor detalii tehnice vă oferă un avantaj competitiv și vă permite să profitați la maximum de resursele disponibile. Fie că sunteți un dezvoltator experimentat sau un începător curios, stăpânirea acestor formate vă va ajuta să navigați cu încredere în peisajul în continuă schimbare al inteligenței artificiale.