Subiect: #Optimizare Costuri
Penuria de GPU din propria infrastructură: De ce sarcinile de AI stau în coadă în timp ce capacitatea rămâne inutilizată
Articolul analizează paradoxa infrastructurii AI: GPU-urile raportează utilizare mică (5% mediu conform raportului Cast AI 2026), dar sarcinile stau în coadă. Explicăm diferența dintre alocare și utilizare, constrângerile de memorie, scheduling Kubernetes, și soluțiile de GPU sharing (MIG, MPS, vGPU).
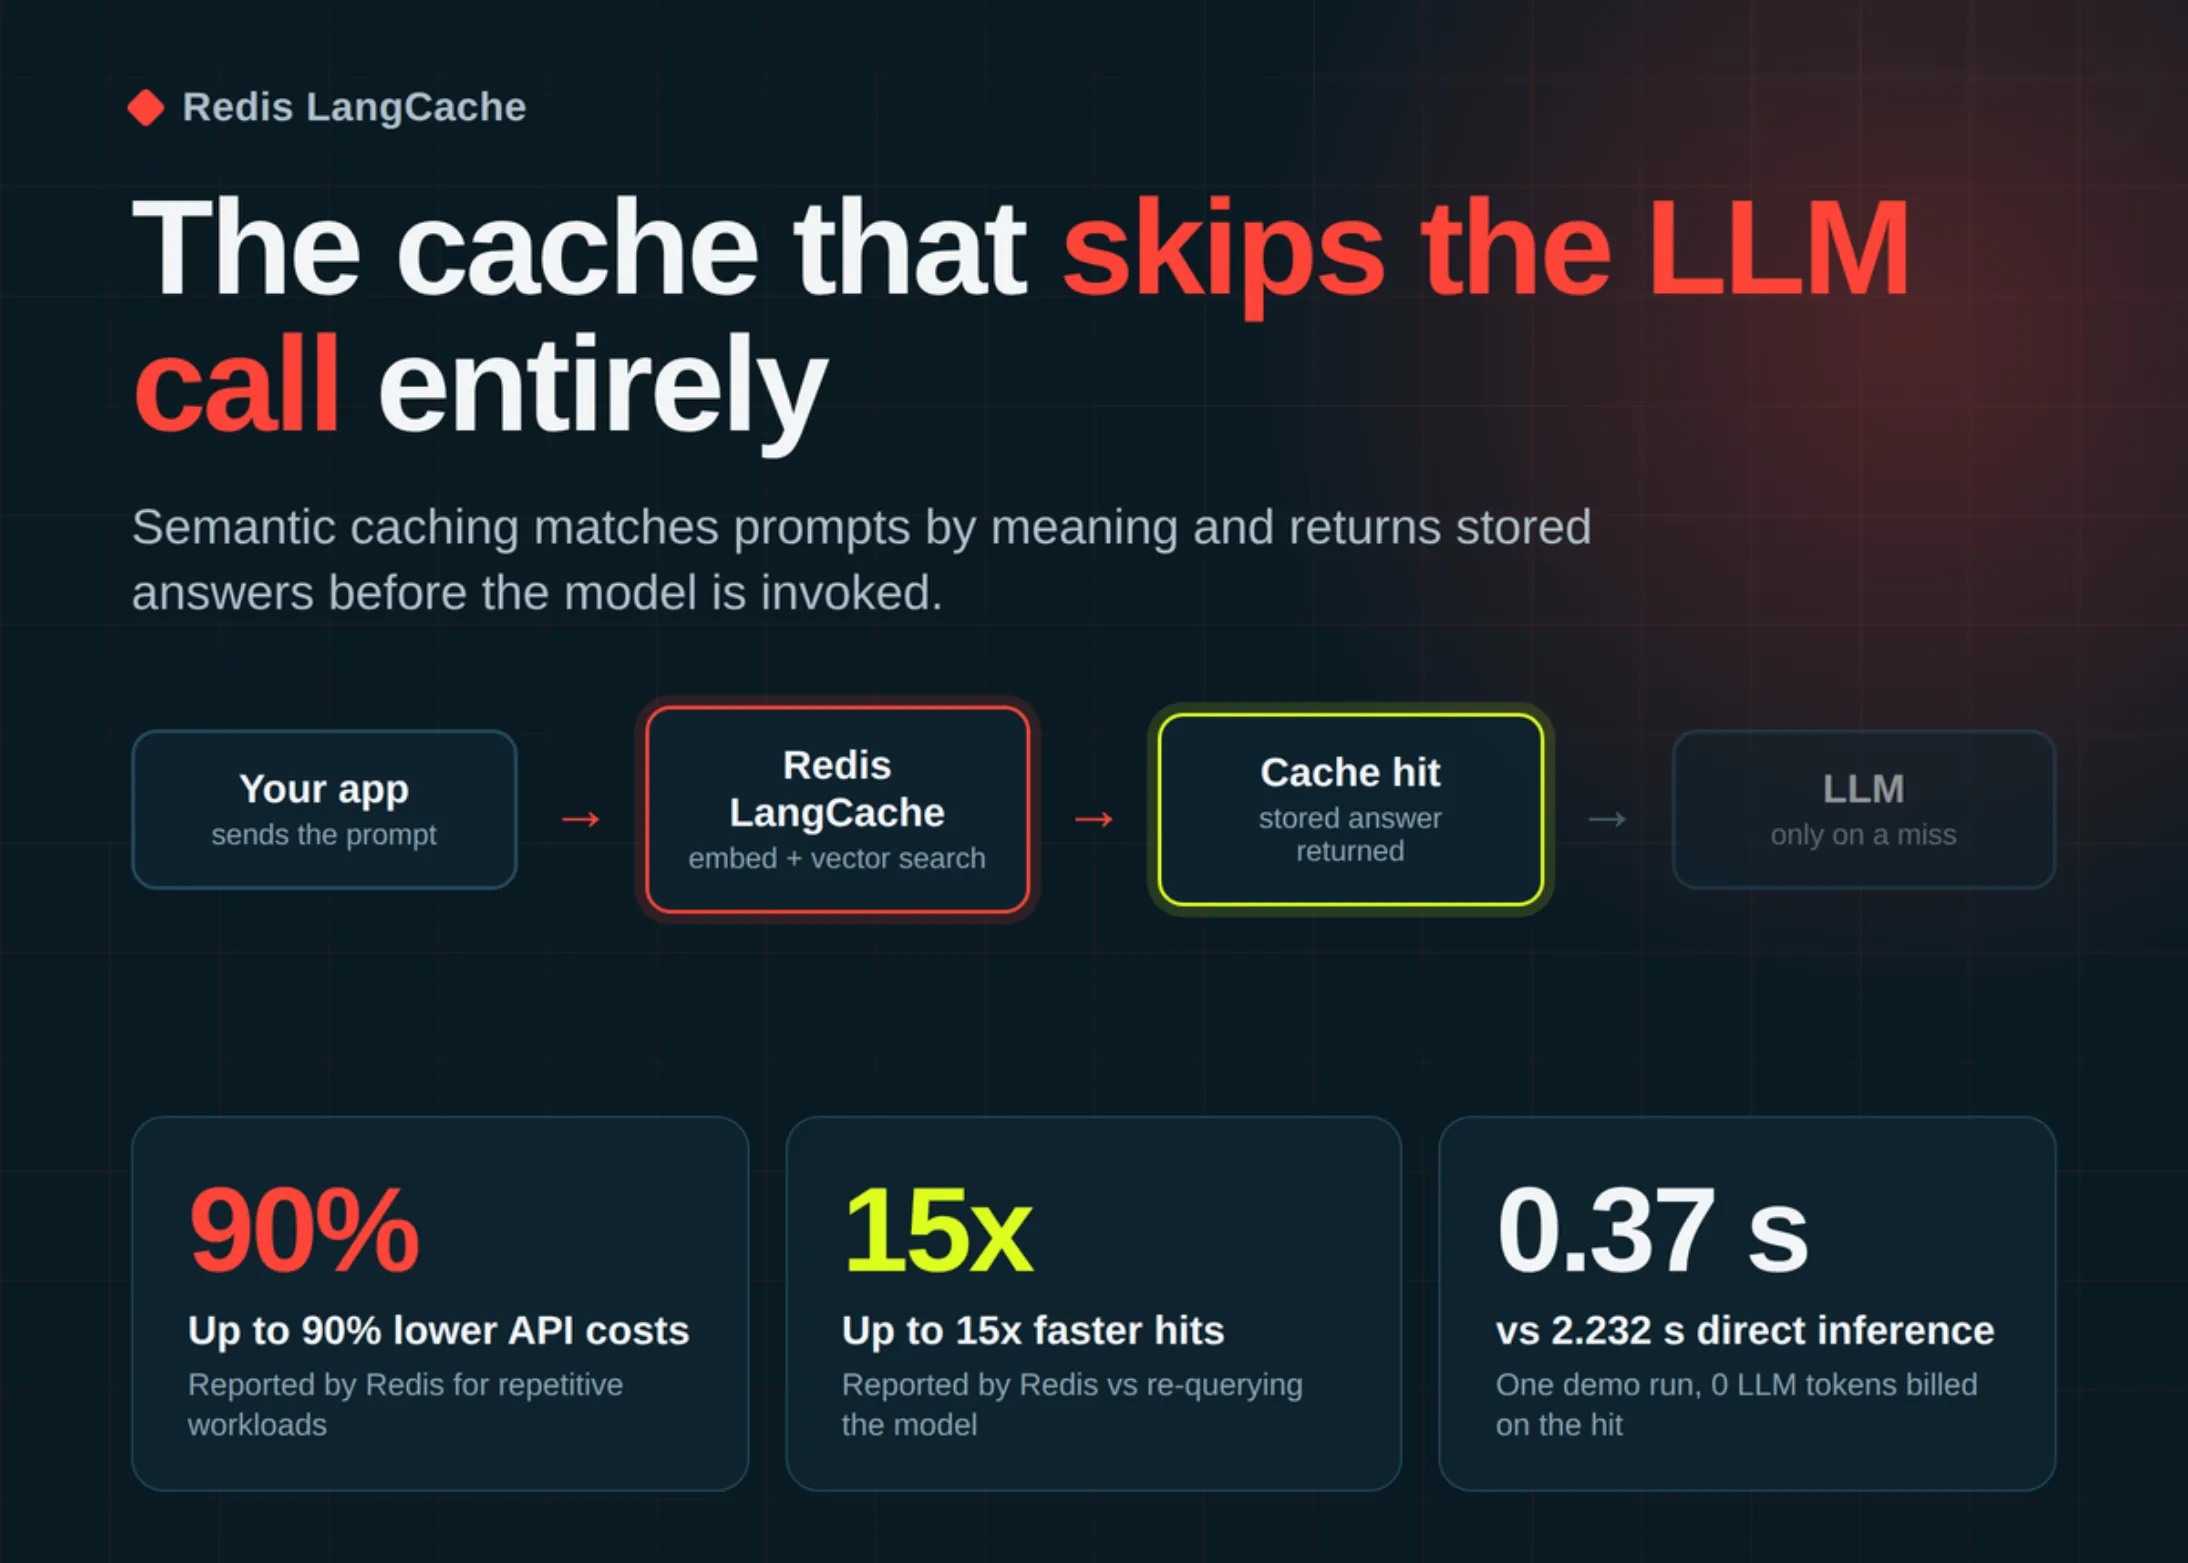
Redis LangCache: Cache-ul semantic care taie până la 90% din factura la API-urile LLM și răspunde de 15 ori mai repede
Redis a lansat LangCache, un serviciu gestionat de caching semantic care promite să reducă factura la API-urile LLM cu până la 90% și să livreze răspunsuri de până la 15 ori mai rapide. Iată cum funcționează, ce înseamnă pentru dezvoltatori și care sunt compromisurile de care trebuie să ții cont.

Fireworks AI lansează Nexus: stratul de rutare și control al costurilor care mută munca de codare de rutină către modele cu greutăți deschise
Fireworks AI a lansat Nexus, un strat de rutare și control al costurilor care direcționează sarcinile simple de codare către modele open-weight, reducând costurile cu până la 90% și făcând AI mai accesibil pentru enterprise și dezvoltatori individuali.
ScaleOps atrage 130 de milioane de dolari pentru a revoluționa eficiența computațională în era cererii masive pentru AI
Startup-ul ScaleOps a ridicat 130 de milioane de dolari într-o rundă Series C, evaluând compania la 800 de milioane de dolari, pentru a aborda ineficiența critică din infrastructura AI. Fondat de un fost inginer Run:ai, ScaleOps oferă o soluție software autonomă care promite reducerea costurilor cloud cu până la 80%, gestionând în timp real resursele precum GPU-urile, memoria și rețelele pentru giganți precum Adobe și Salesforce.
Google Cloud C4 și Intel Xeon 6: O revoluție în eficiența costurilor pentru modelele AI de tip MoE
Noile instanțe Google Cloud C4, echipate cu procesoare Intel Xeon 6, demonstrează o reducere de 70% a Costului Total de Proprietate (TCO) pentru inferența modelelor AI MoE, grație optimizărilor hardware și software realizate în colaborare cu Hugging Face.