Să lămurim întâi ce înseamnă „cache semantic”, pentru că aici stă toată magia. Cache-ul clasic, cel pe care îl știm cu toții din spatele bazelor de date, funcționează pe principiul potrivirii exacte. Dacă ceri „care e vremea în București?” și apoi „care e vremea în București ?” cu un spațiu în plus, cache-ul tradițional nu recunoaște cele două întrebări ca fiind identice și trimite ambele cereri mai departe. Este o abordare rigidă, care nu se potrivește deloc cu felul în care oamenii vorbesc cu AI-ul.
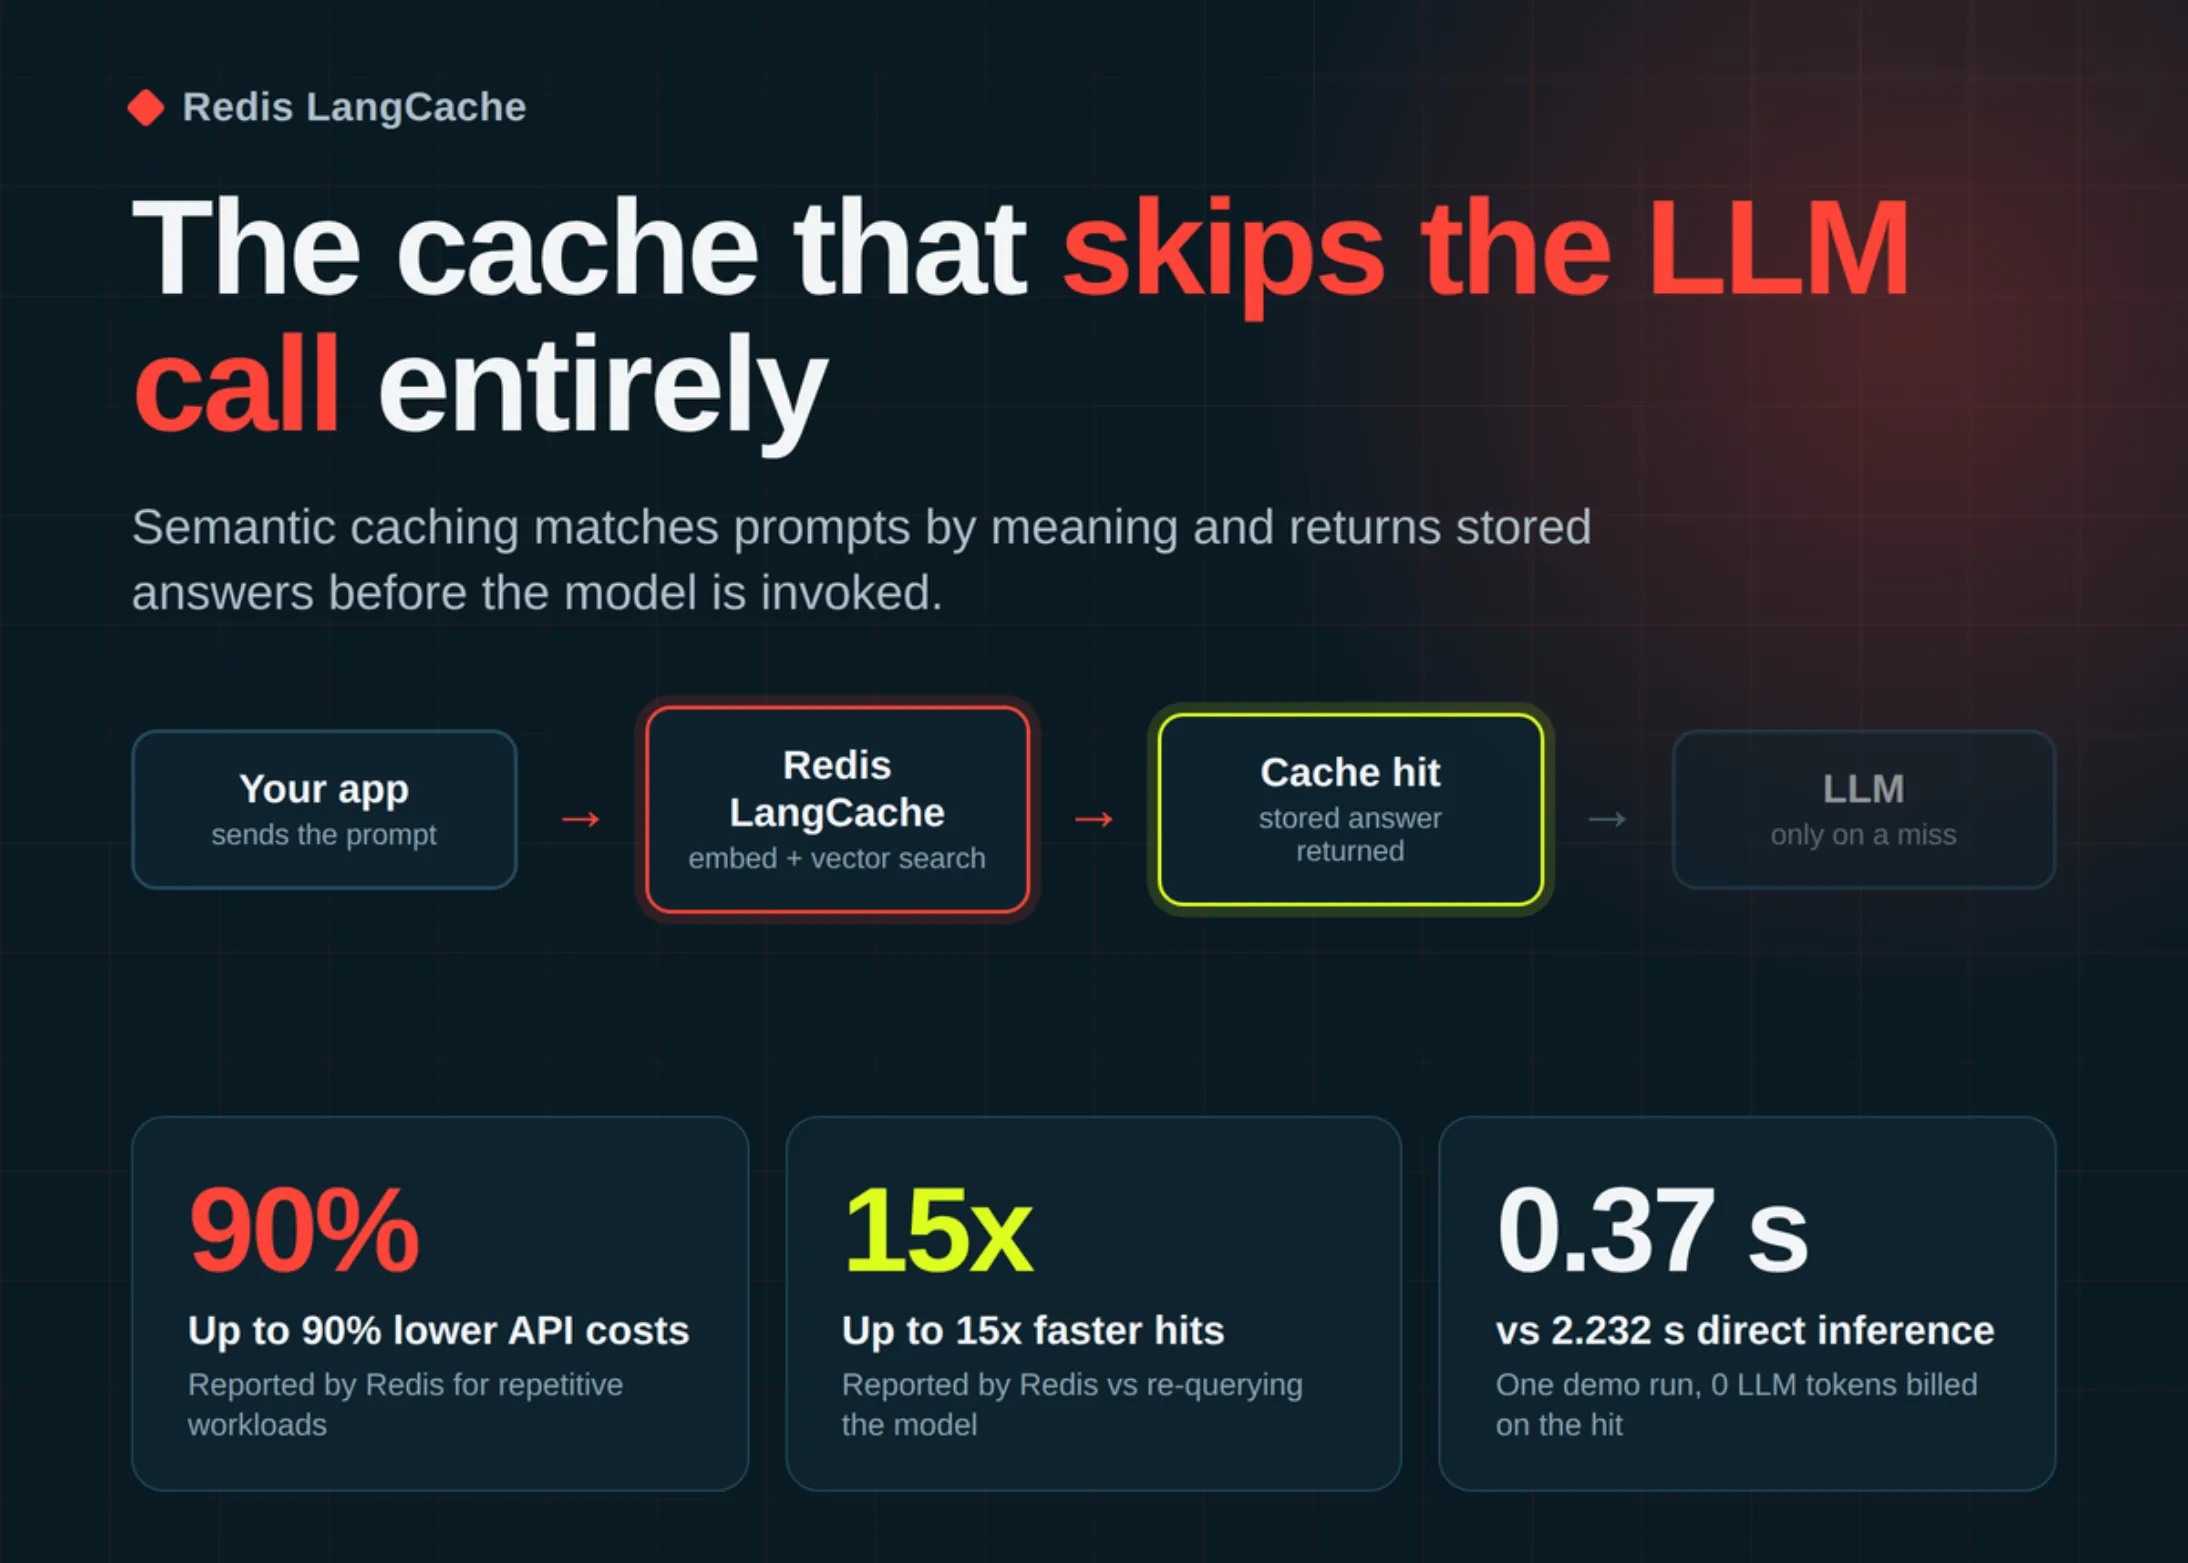
Cache-ul semantic, în schimb, transformă fiecare întrebare într-un vector — o reprezentare numerică a sensului — și compară vectorii între ei. Dacă două întrebări sunt suficient de apropiate din punct de vedere semantic, sistemul consideră că e vorba de aceeași intenție și returnează răspunsul deja stocat, fără să mai deranjeze modelul. „Cum ajung la gară?” și „Care e cel mai bun mod de a ajunge la gară?” devin, pentru LangCache, practic aceeași întrebare. Iar asta schimbă complet economia unei aplicații AI.
Redis nu este un nume nou în lumea infrastructurii. Compania și-a construit reputația pe un motor de stocare în memorie folosit de milioane de dezvoltatori pentru caching, cozi de mesaje și sesiuni. În ultimii ani, însă, Redis a făcut o mutare strategică clară spre zona AI, lansând suport pentru căutare vectorială și integrându-se cu framework-uri populare precum LangChain și LlamaIndex. LangCache este următorul pas logic: un produs complet gestionat, care nu-ți mai cere să construiești singur infrastructura de caching semantic, cu toate bătăile de cap legate de embeddings, indexare și scalare.
Cifrele pe care le promite Redis sunt, pe hârtie, spectaculoase. Reduceri de cost de până la 90% la apelurile API către furnizorii de LLM și timpi de răspuns de până la 15 ori mai rapizi pentru cererile care lovesc cache-ul. Să traducem asta în viața reală. Dacă ai un chatbot de suport clienți care primește mii de întrebări pe zi, o bună parte dintre ele sunt variațiuni ale acelorași câteva zeci de probleme. „Cum îmi resetez parola?”, „Nu-mi mai merge contul”, „Am uitat parola, ce fac?” — toate acestea sunt, semantic, aproape identice. Fără cache, plătești de fiecare dată. Cu LangCache, plătești o singură dată, iar restul cererilor primesc instant răspunsul deja generat.
Diferența de viteză este la fel de importantă. Un apel către un LLM de top durează, în medie, între una și câteva secunde, în funcție de model și de lungimea răspunsului. Un cache hit, în schimb, se rezolvă în milisecunde. Pentru utilizatorul final, asta înseamnă o experiență mult mai fluidă, aproape instantanee. Pentru tine, dezvoltatorul, înseamnă mai puține timeout-uri, mai puține retry-uri și o arhitectură mai rezistentă la vârfuri de trafic.
Un aspect interesant este că LangCache nu este doar pentru companiile mari cu bugete uriașe de cloud. Tocmai pentru că este un serviciu gestionat, bariera de intrare este mult mai mică decât dacă ai încerca să construiești singur un sistem de caching semantic. Nu trebuie să antrenezi modele de embeddings, să gestionezi un cluster de baze de date vectoriale sau să te lupți cu tuning-ul pragurilor de similaritate. Redis se ocupă de toate acestea în spate, iar tu primești un API curat pe care îl integrezi în câteva linii de cod.
Desigur, există și nuanțe pe care orice dezvoltator serios ar trebui să le ia în calcul. Primul lucru este pragul de similaritate. Setat prea jos, cache-ul va returna răspunsuri pentru întrebări care, de fapt, sunt diferite, iar utilizatorii vor primi informații greșite. Setat prea sus, vei rata oportunități de economisire. Găsirea echilibrului potrivit pentru fiecare aplicație în parte este o artă, nu o știință exactă, și necesită monitorizare atentă și ajustări periodice.
Al doilea aspect ține de natura conținutului. Cache-ul semantic strălucește în scenarii cu întrebări repetitive: suport clienți, FAQ-uri, asistenți interni, documentație tehnică. Dar dacă aplicația ta generează răspunsuri foarte personalizate, bazate pe context unic pentru fiecare utilizator, beneficiile se reduc dramatic. Nu poți cache-ui un răspuns care depinde de istoricul complet al conversației fiecărei persoane în parte.
Există și întrebarea legată de prospețimea informației. Dacă sursa de adevăr se schimbă — prețuri, politici, date care expiră — trebuie să te asiguri că cache-ul nu servește răspunsuri vechi. Redis oferă mecanisme de expirare și invalidare, dar responsabilitatea de a le configura corect rămâne la dezvoltator.
În ciuda acestor nuanțe, direcția este clară. Pe măsură ce tot mai multe companii trec de la prototipuri AI la produse reale, în producție, cu mii sau milioane de utilizatori, optimizarea costurilor și a latenței devine o prioritate de business, nu doar o preferință tehnică. Iar caching-ul semantic este una dintre cele mai eficiente pârghii disponibile. Nu întâmplător, jucători precum Redis, dar și concurenți din zona bazelor de date vectoriale, investesc masiv în această direcție.
Pentru echipa Redis, LangCache este și un pariu strategic. Compania vrea să se poziționeze nu doar ca furnizor de infrastructură pentru AI, ci ca partener complet pentru întregul ciclu de viață al unei aplicații bazate pe modele lingvistice: stocare, căutare vectorială, memorie pentru agenți și, acum, caching semantic. Este o viziune ambițioasă, care transformă Redis dintr-un simplu instrument într-o platformă.
Rămâne de văzut cum va fi primit LangCache de comunitatea de dezvoltatori. Promisiunile sunt mari, iar așteptările, pe măsură. Dacă cifrele se confirmă în producție, nu doar în benchmark-uri de laborator, am putea asista la o schimbare reală în felul în care se construiesc aplicațiile AI: mai ieftine, mai rapide și, în final, mai accesibile pentru toată lumea.
De ce este important:
Redis LangCache atacă una dintre cele mai dureroase probleme ale economiei AI actuale: costul. Fiecare apel către un model lingvistic mare costă bani reali, iar majoritatea aplicațiilor trimit aceleași întrebări, reformulate, de mii de ori pe zi. Un cache semantic gestionat reduce această risipă cu până la 90% și accelerează răspunsurile de până la 15 ori, ceea ce înseamnă aplicații mai ieftine de operat și mai plăcute de folosit. Pentru dezvoltatori, contează și că nu mai trebuie să construiască singuri infrastructura de embeddings și căutare vectorială — Redis o face pentru ei. Pe termen lung, astfel de optimizări pot decide cine supraviețuiește pe piața AI: companiile care reușesc să ofere servicii de calitate la costuri sustenabile, nu doar cele care au cele mai impresionante demo-uri. LangCache nu este o soluție magică și vine cu propriile compromisuri legate de praguri de similaritate și prospețimea datelor, dar semnalează o maturizare a industriei: trecem de la „ce poate face AI-ul?” la „cât ne costă și cât de repede răspunde?”.