Subiect: #Optimizare Hardware
AI
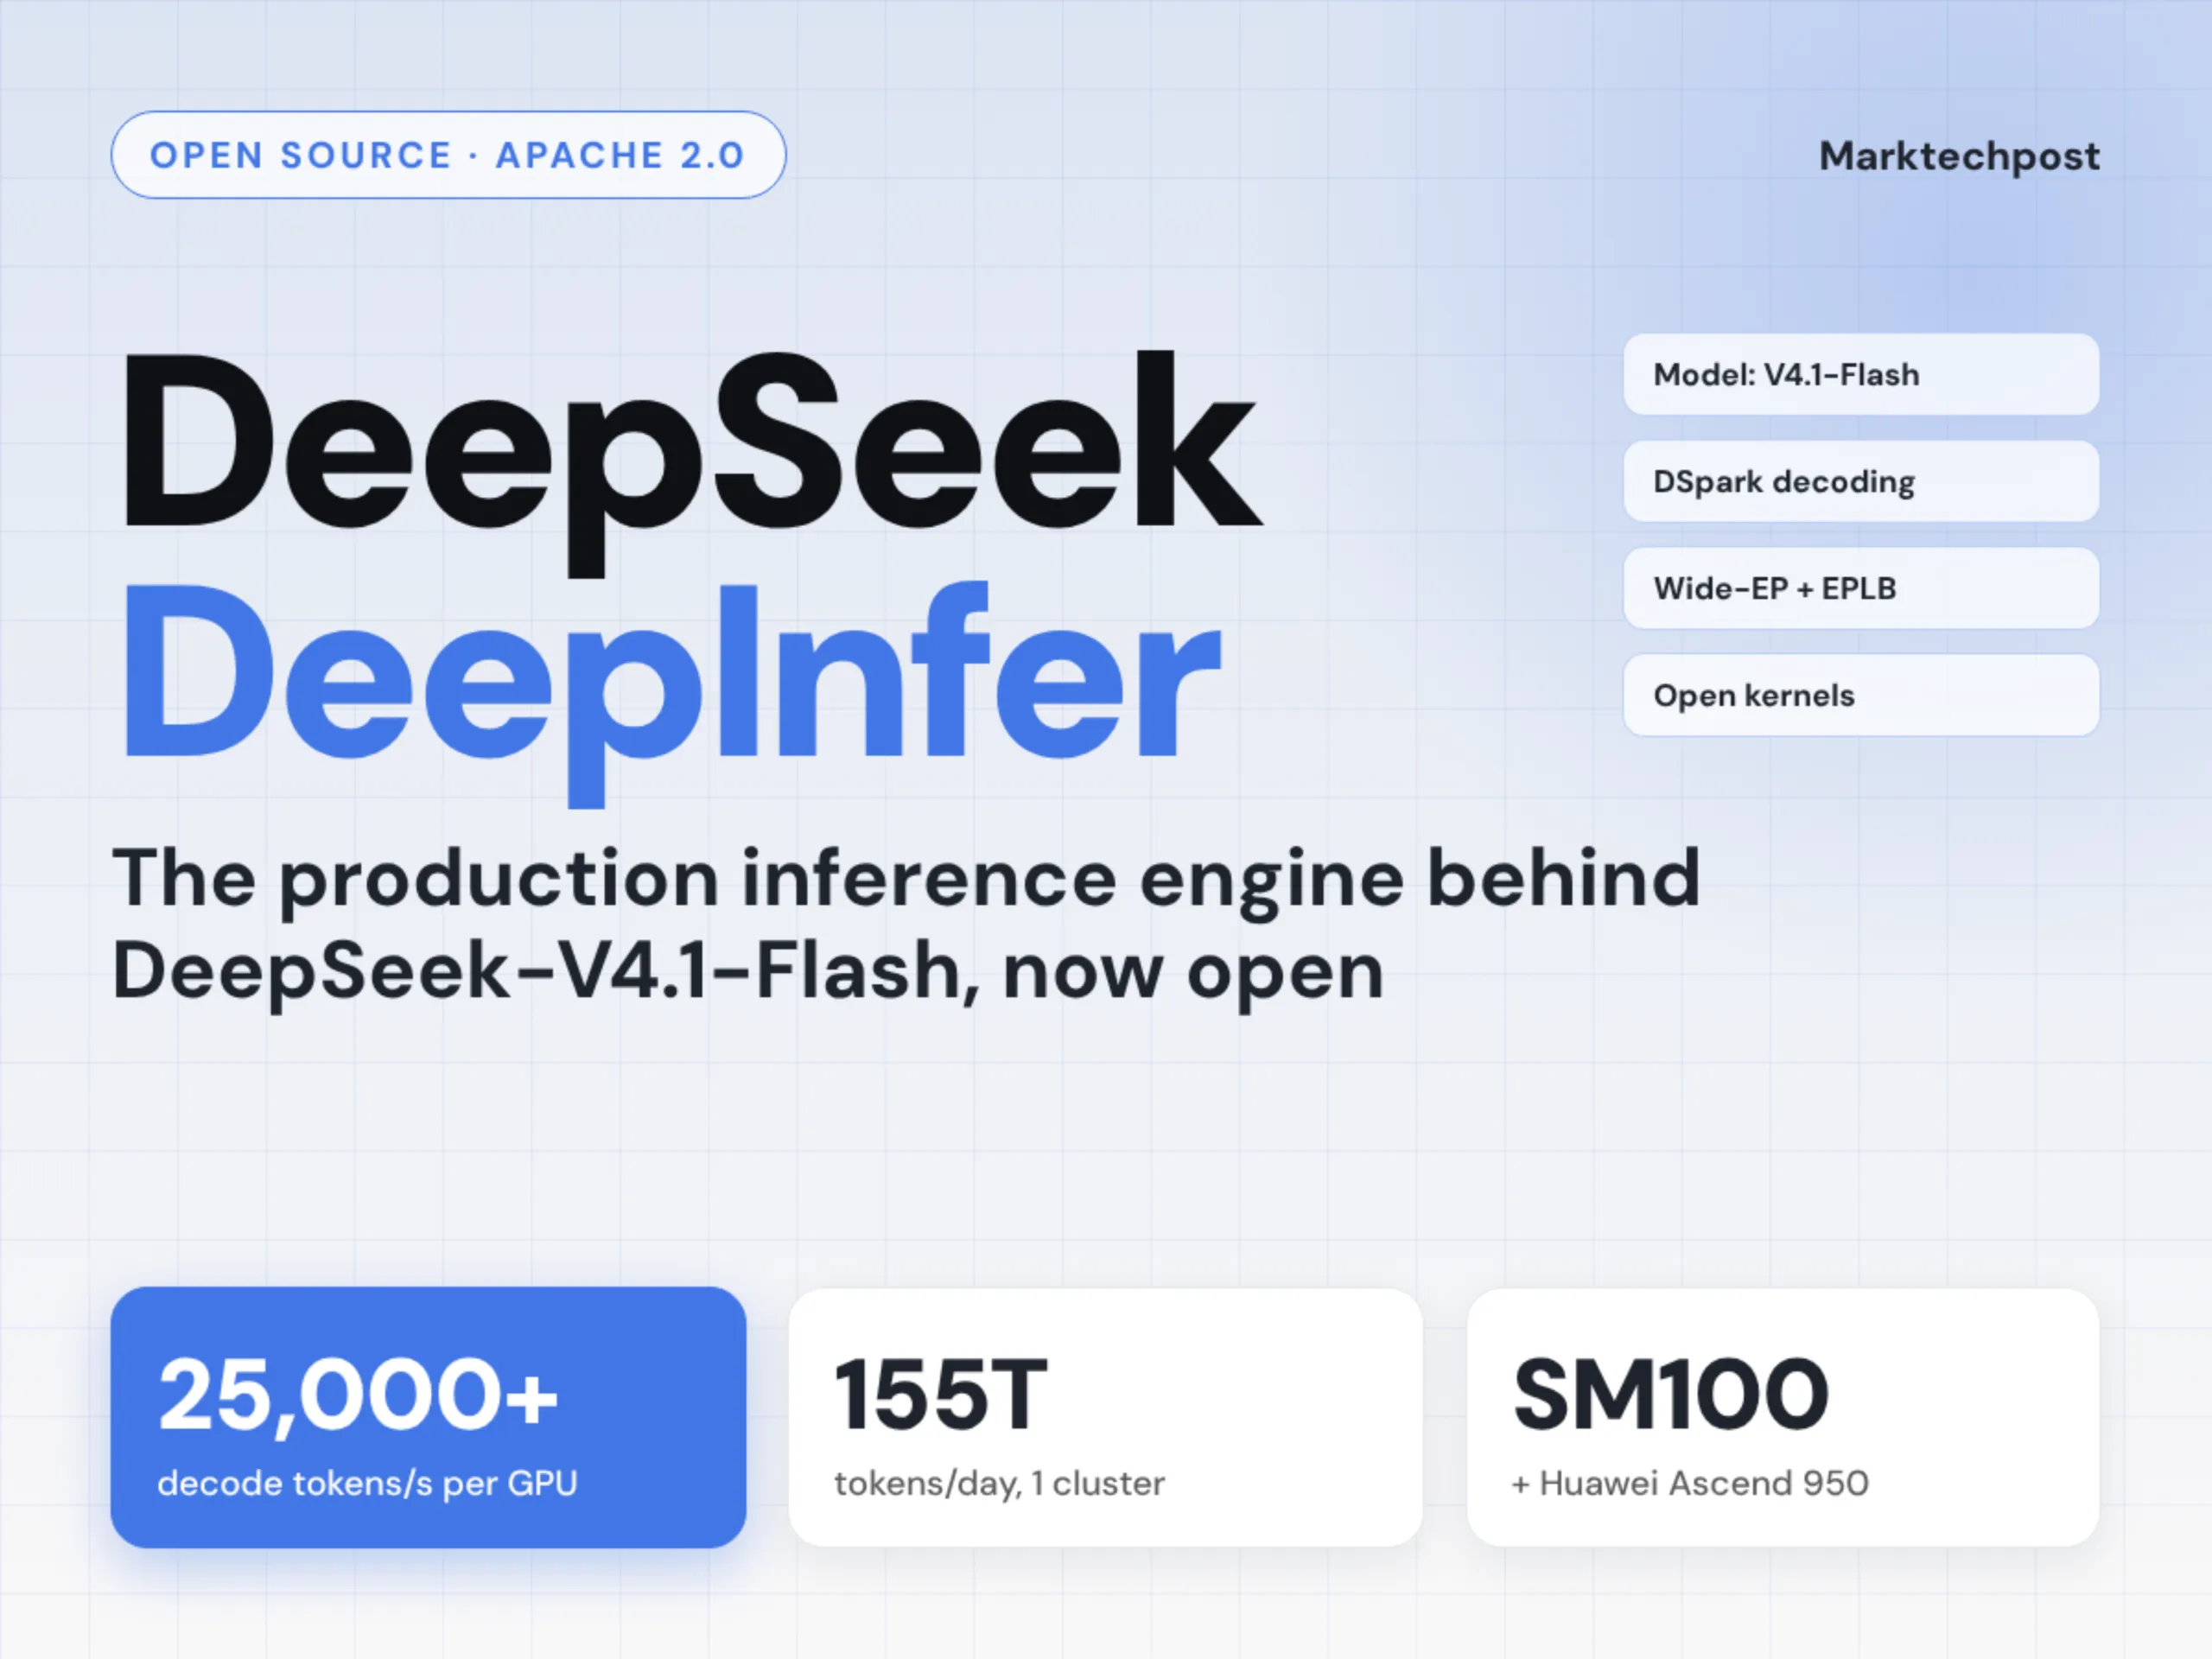
DeepSeek deschide codul sursă al framework-ului DeepInfer: motorul invizibil care alimentează V4.1-Flash și schimbă regulile jocului în inferența AI
DeepSeek lansează DeepInfer open-source: framework-ul de inferență care alimentează V4.1-Flash și reduce costurile de 3-5x pe hardware commoditizat. O analiză profundă a arhitecturii, a implicațiilor geopolitice și a oportunităților pentru dezvoltatorii europeni.
AI
Implementarea Inteligenței Artificiale în Robotică pe Platforme Embedded: Înregistrarea Seturilor de Date, Fine-Tuning VLA și Optimizări On-Device
Aducerea modelelor VLA (Vision-Language-Action) pe platforme robotice embedded necesită mai mult decât compresie de model; este o problemă de inginerie a sistemelor. Acest articol detaliază bunele practici NXP pentru înregistrarea seturilor de date, fine-tuning-ul politicilor și optimizările în timp real pe procesorul i.MX 95, demonstrând cum inferența asincronă și cuantizarea selectivă pot reduce latența de la 2.86s la 0.32s.