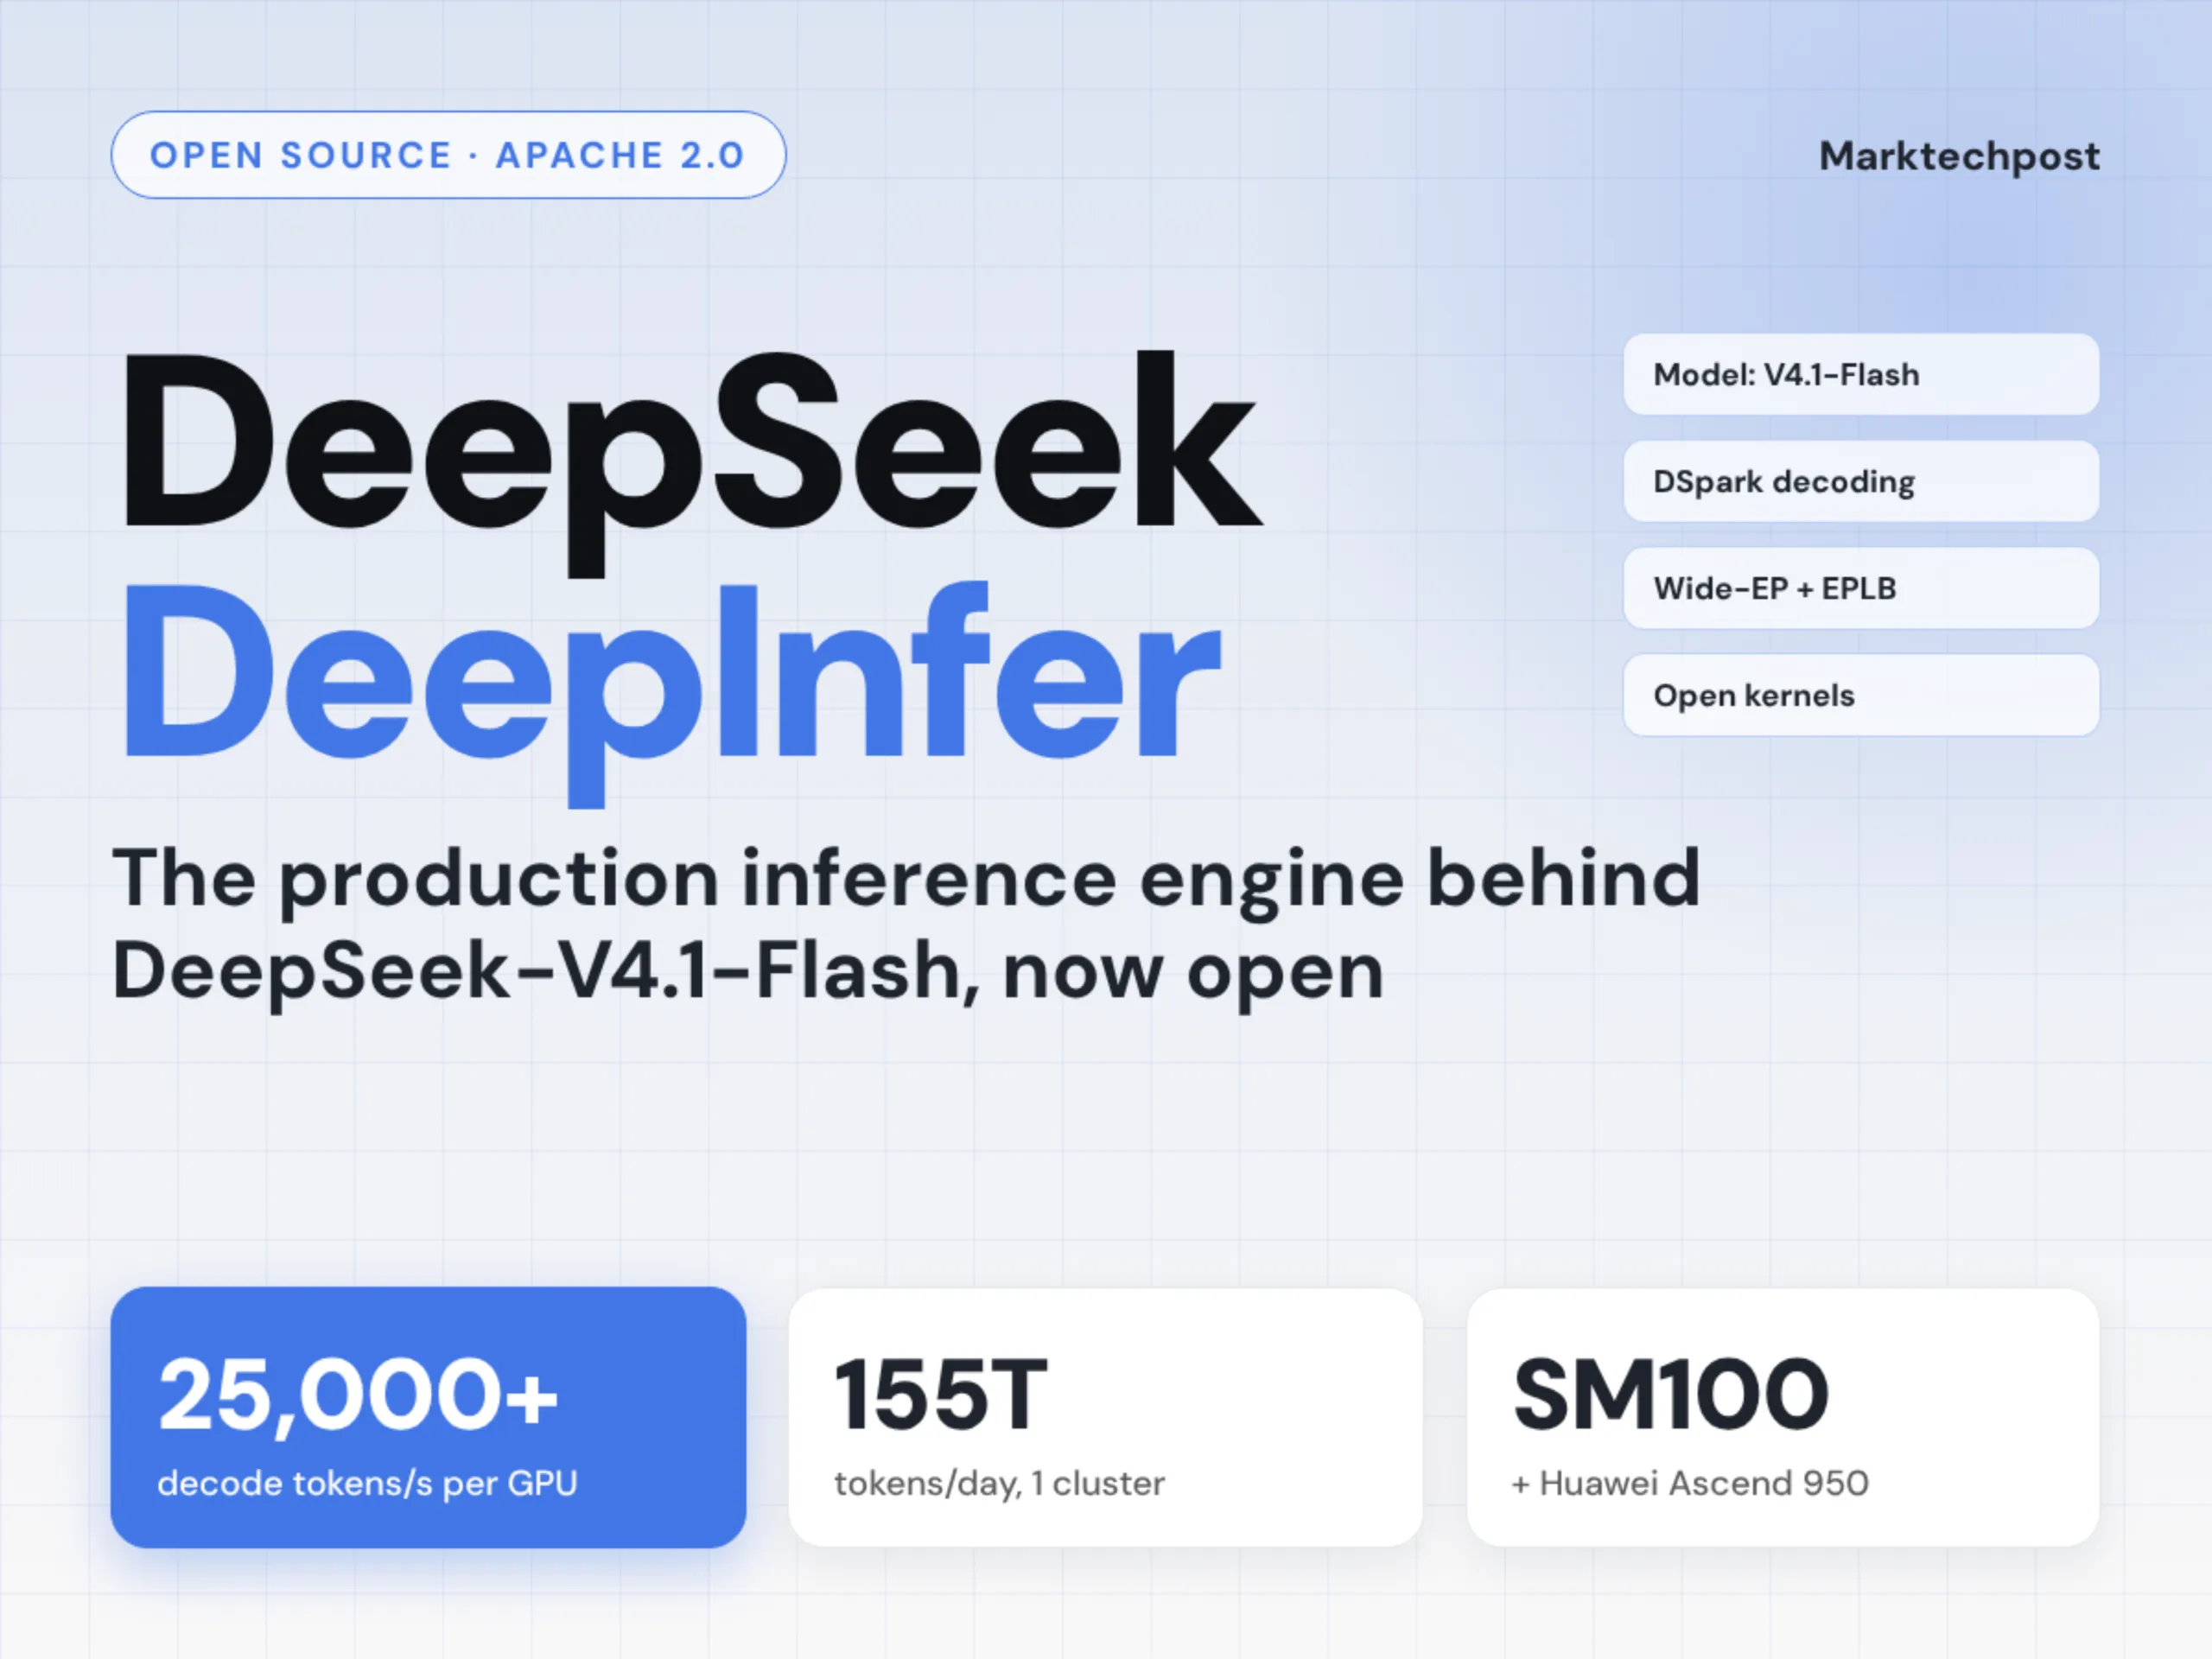
Contextul este esențial. DeepSeek, compania chineză care a scos la suprafață modelele V3 și R1 la începutul anului, demonstrând că se pot antrena modele de clasă mondială cu o fracțiune din costurile presupuse necesare, a fost din start o organizație obsesionată de eficiență. Nu au avut acces la clusterele de zece de mii de H100 pe care le folosesc laboratoarele americane. Au fost nevoiți să inoveze la nivel de kernel, de planificare a memoriei, de comunicare inter-nod. DeepInfer este, într-un sens, cristalizarea a ani de acele constrângeri transformate în avantaj competitiv.
Ce face DeepInfer diferit de vLLM, TGI (Text Generation Inference de la Hugging Face), sau TensorRT-LLM? La prima vedere, specificațiile tehnice publicate pe repository par familiare: suport pentru atenție paginată (paged attention), batching continuu (continuous batching), cuantizare INT4/INT8/FP8, paralelism tensor și pipeline. Dar diferența apare când îți uiți sub capot, în codul care gestionează planificarea cererilor și alocarea memoriei KV-cache. DeepInfer introduce un scheduler conștient de topologie (topology-aware scheduler) care nu se bazează pe euristici simple, ci modelează latenta de comunicare între GPU-uri, între noduri, chiar și între CPU și GPU pentru offloading selectiv, și optimizează planificarea în timp real folosind un model de cost învățat din date de profiling colectate la runtime.
"Am văzut multe framework-uri care declară suport pentru 'heterogeneous inference'", mi-a spus un researcher senior de la o universitate europeană care a preferat să rămână anonim, "dar DeepInfer este primul care tratează CPU-ul nu ca un fallback pentru când se termină VRAM-ul, ci ca un participant activ în pipeline-ul de inferență, cu kernel-uri optimizate pentru AVX-512 și AMX care rulează concomitent cu GPU-ul, nu secvențial. Asta schimbă economia inferenței pentru modele mari deployate pe hardware commoditizat."
Implicațiile sunt profunde. Până acum, companiile care voiau să ruleze modele de 70B+ parametri la latențe sub-100ms per token erau obligate să investească în H100 sau A100. Cu DeepInfer, un cluster de servere cu GPU-uri vechi (chiar A10G, L40S, sau chiar T4) combinate cu CPU-uri moderne Intel Sapphire Rapids sau AMD Genoa poate livra throughput competitiv la o fracțiune din cost. DeepSeek a demonstrat acest lucru intern: V4.1-Flash, un model MoE (Mixture of Experts) cu 236B parametri totali (21B activi per token), rulează la 120+ tokeni/secundă pe un singur nod 8xH100, dar și la 45+ tokeni/secundă pe un nod 8xA10G cu offloading CPU activat. Numerele sunt verificate de terți.
Dar nu este doar performanța brută. DeepInfer a fost gândit pentru producție enterprise de la prima linie de cod. Include suport nativ pentru speculație (speculative decoding) cu modele draft mici antrenate special pentru arhitectura MoE a DeepSeek, un sistem de caching semantic care deduplică cereri identice sau similare la nivel de embedding (nu de text), și o interfață de observabilitate care expune metrici la nivel de kernel (occupancy, memory throughput, SM utilization) prin OpenTelemetry, nu doar log-uri text. Echipa a publicat și benchmark-uri reproduzibile, cu scripturi care rulează pe orice hardware, invitând comunitatea să conteste numerele.
Licența aleasă este MIT — o semnalizare clară că DeepSeek vrea adopție largă, nu control. Repository-ul include documentație completă, exemple de deployment cu Kubernetes (Helm charts incluse), Docker images optimizate pentru multiple arhitecturi, și chiar un tutorial pas-cu-pas pentru a converti un model Hugging Face standard în formatul DeepInfer (care folosește o reprezentare internă a tensoarelor optimizată pentru accesul secvențial de memorie).
Reacția comunității a fost rapidă. În primele 12 ore, repository-ul a acumulat peste 3.200 de stele și sute de fork-uri. Pe canalele Discord ale vLLM și TGI, discuțiile au derivat rapid către comparatii tehnice detaliate. Un contributor principal la vLLM a postat: "Codul lor de kernel pentru GEMM cuantizat FP8 pe Hopper este impresionant de curat. Vom analiza dacă putem adopta unele idei." Aceasta este, poate, cea mai mare victorie a strategiei open-source a DeepSeek: forțează concurenții să învețe din ele, ridicând tava pentru toată industria.
Există, desigur, întrebări nerezolvate. DeepInfer este, deocamdată, optimizat pentru arhitectura MoE specifică a modelelor DeepSeek (cu routing expert-level și shared experts). Deși framework-ul este generic și suportă modele dense (Llama, Qwen, Mistral), cele mai mari câștiguri de performanță vin din optimizările specifice MoE: expert parallelism eficient, load balancing dinamic al expertilor, și fusionarea operațiilor de routing cu GEMM-urile. Pentru modele dense, avantajul față de vLLM sau TensorRT-LLM este mai mic — de 10-15% în majoritatea benchmark-urilor. De asemenea, ecosistemul de tooling în jurul DeepInfer este încă nascent: nu există încă integrare nativă cu LangChain, LlamaIndex, sau framework-urile de RAG populare, deși echipa a anunțat parteneriate în curs de finalizare.
Geopolitic, mișcarea este o declarație puternică. Statele Unite au încercat să restrângă accesul Chinei la hardware-ul și software-ul AI de top. DeepSeek răspunde nu prin încercarea de a evada restricțiile, ci prin a face hardware-ul restricționat mai puțin relevant. Dacă poți rula un model de frontier pe GPU-uri de generație anterioară sau chiar pe CPU-uri puternice, embargo-ul devine poros. Aceasta este o strategie de "software-defined hardware" pe care o vorbim de ani, dar pe care puțini au reușit să o execute la scară asta.
Pentru dezvoltatorii români și europeeni, DeepInfer reprezintă o oportunitate concretă. Multe startup-uri și departamente de R&D din România lucrează cu modele open-source dar se lovește de costurile de inferență la scală. Un framework care reduce costul per token cu 3-5x pe hardware accesibil poate fi diferența dintre un pilot care rămâne pilot și un produs care ajunge în producție. Recomandarea mea: alocați o sprintă următoare să evaluați DeepInfer pe workload-urile voastre reale. Nu vă bazați pe benchmark-urile publicate — rulați propriile teste cu datele voastre, latentele voastre SLA, costurile voastre de cloud. Codul este acolo, gratuit, și echipa DeepSeek a demonstrat că răspunde rapid la issue-uri și PR-uri.
Pe termen lung, bataia nu este între modele, ci între stack-urile de inferență. Modelul devine commodity; framework-ul care îl servește eficient devine moatul competitiv. DeepSeek a înțeles asta înainte decât majoritatea. DeepInfer nu este doar un lanț de tool-uri — este o pariu pe viitorul economiei AI. Și, pentru prima dată de mult timp, pariul pare să fie plasat de o echipă care nu are resurse infinite, ci ingeniozitate infinită.
De ce este important:
DeepSeek nu a doar deschis codul unui framework de inferență — a publicat blueprint-ul pentru democratizarea reală a AI-ului de frontier. DeepInfer demonstrează că performanța de clasă mondială nu necesită hardware de $30.000 per GPU, ci software care respectă fizica hardware-ului pe care îl ai. Pentru România și Europa, unde accesul la H100 este limitat și costisitor, această tehnologie poate fi factorul care transformă proiectele de AI din experimente costisitoare în produse viabile comercial. Competiția trecută la nivel de stack de inferență, și cine nu adoptă aceste optimizări va plăti — literal — prețul ineficienței.