Subiect: #Sinteză Vocală
Gradium lansează Voice Design: scrie un prompt și obține o voce sintetică nouă în câteva secunde
Gradium lansează Voice Design, o funcție care permite generarea de voci sintetice personalizate pe baza unui simplu prompt textual. Tehnologia promite să democratizeze crearea de conținut audio, oferind voci realiste în câteva secunde, cu aplicații variate de la podcasturi la jocuri video.
Gradium AI revoluționează sinteza vocală: noul model TTS atinge 81% succes pe cazuri dificile în doar 216 milisecunde
Gradium AI lansează un nou model TTS cu o rată de succes de 81% pe cazuri dificile și o latență de doar 216 ms până la primul audio. Descoperă cum această inovație redefinește standardele sintezei vocale și ce înseamnă pentru dezvoltatori și utilizatori.

Alibaba lansează Qwen-Audio-3.0-TTS: modelul text-to-speech care vorbește 16 limbi, în variante Flash și Plus
Alibaba, prin laboratorul Tongyi, a lansat Qwen-Audio-3.0-TTS, un model text-to-speech găzduit, disponibil în variantele Flash (rapid) și Plus (calitate superioară), care suportă 16 limbi. Articolul analizează caracteristicile, impactul pe piață, beneficiile și limitările acestui sistem avansat de sinteză vocală.
Miso Labs lansează MisoTTS: Un model de sinteză vocală emoțională de 8 miliarde de parametri, cu greutăți deschise
Miso Labs a lansat MisoTTS, un model text-to-speech de 8 miliarde de parametri, capabil să redea emoții autentice, cu greutăți open-source. Articolul analizează tehnologia, aplicațiile și impactul asupra industriei AI.
OmniVoice Studio: Alternativa locală și open-source la ElevenLabs
OmniVoice Studio este o alternativă open-source și locală la ElevenLabs, care permite generarea și clonarea vocală de înaltă calitate, fără a depinde de servere externe. Articolul explorează caracteristicile, avantajele, limitările și impactul acestui proiect asupra comunității tech, inclusiv suportul pentru limba română.
Supertone lansează Supertonic v3: model de sinteză vocală pe dispozitiv cu suport pentru 31 de limbi, mai puține erori de citire și etichete de expresie
Supertone lansează Supertonic v3, un model TTS pe dispozitiv care suportă 31 de limbi, reduce erorile de citire și introduce etichete de expresie pentru control emoțional. Articolul analizează caracteristicile, impactul și potențialul acestei inovații în domeniul sintezei vocale.
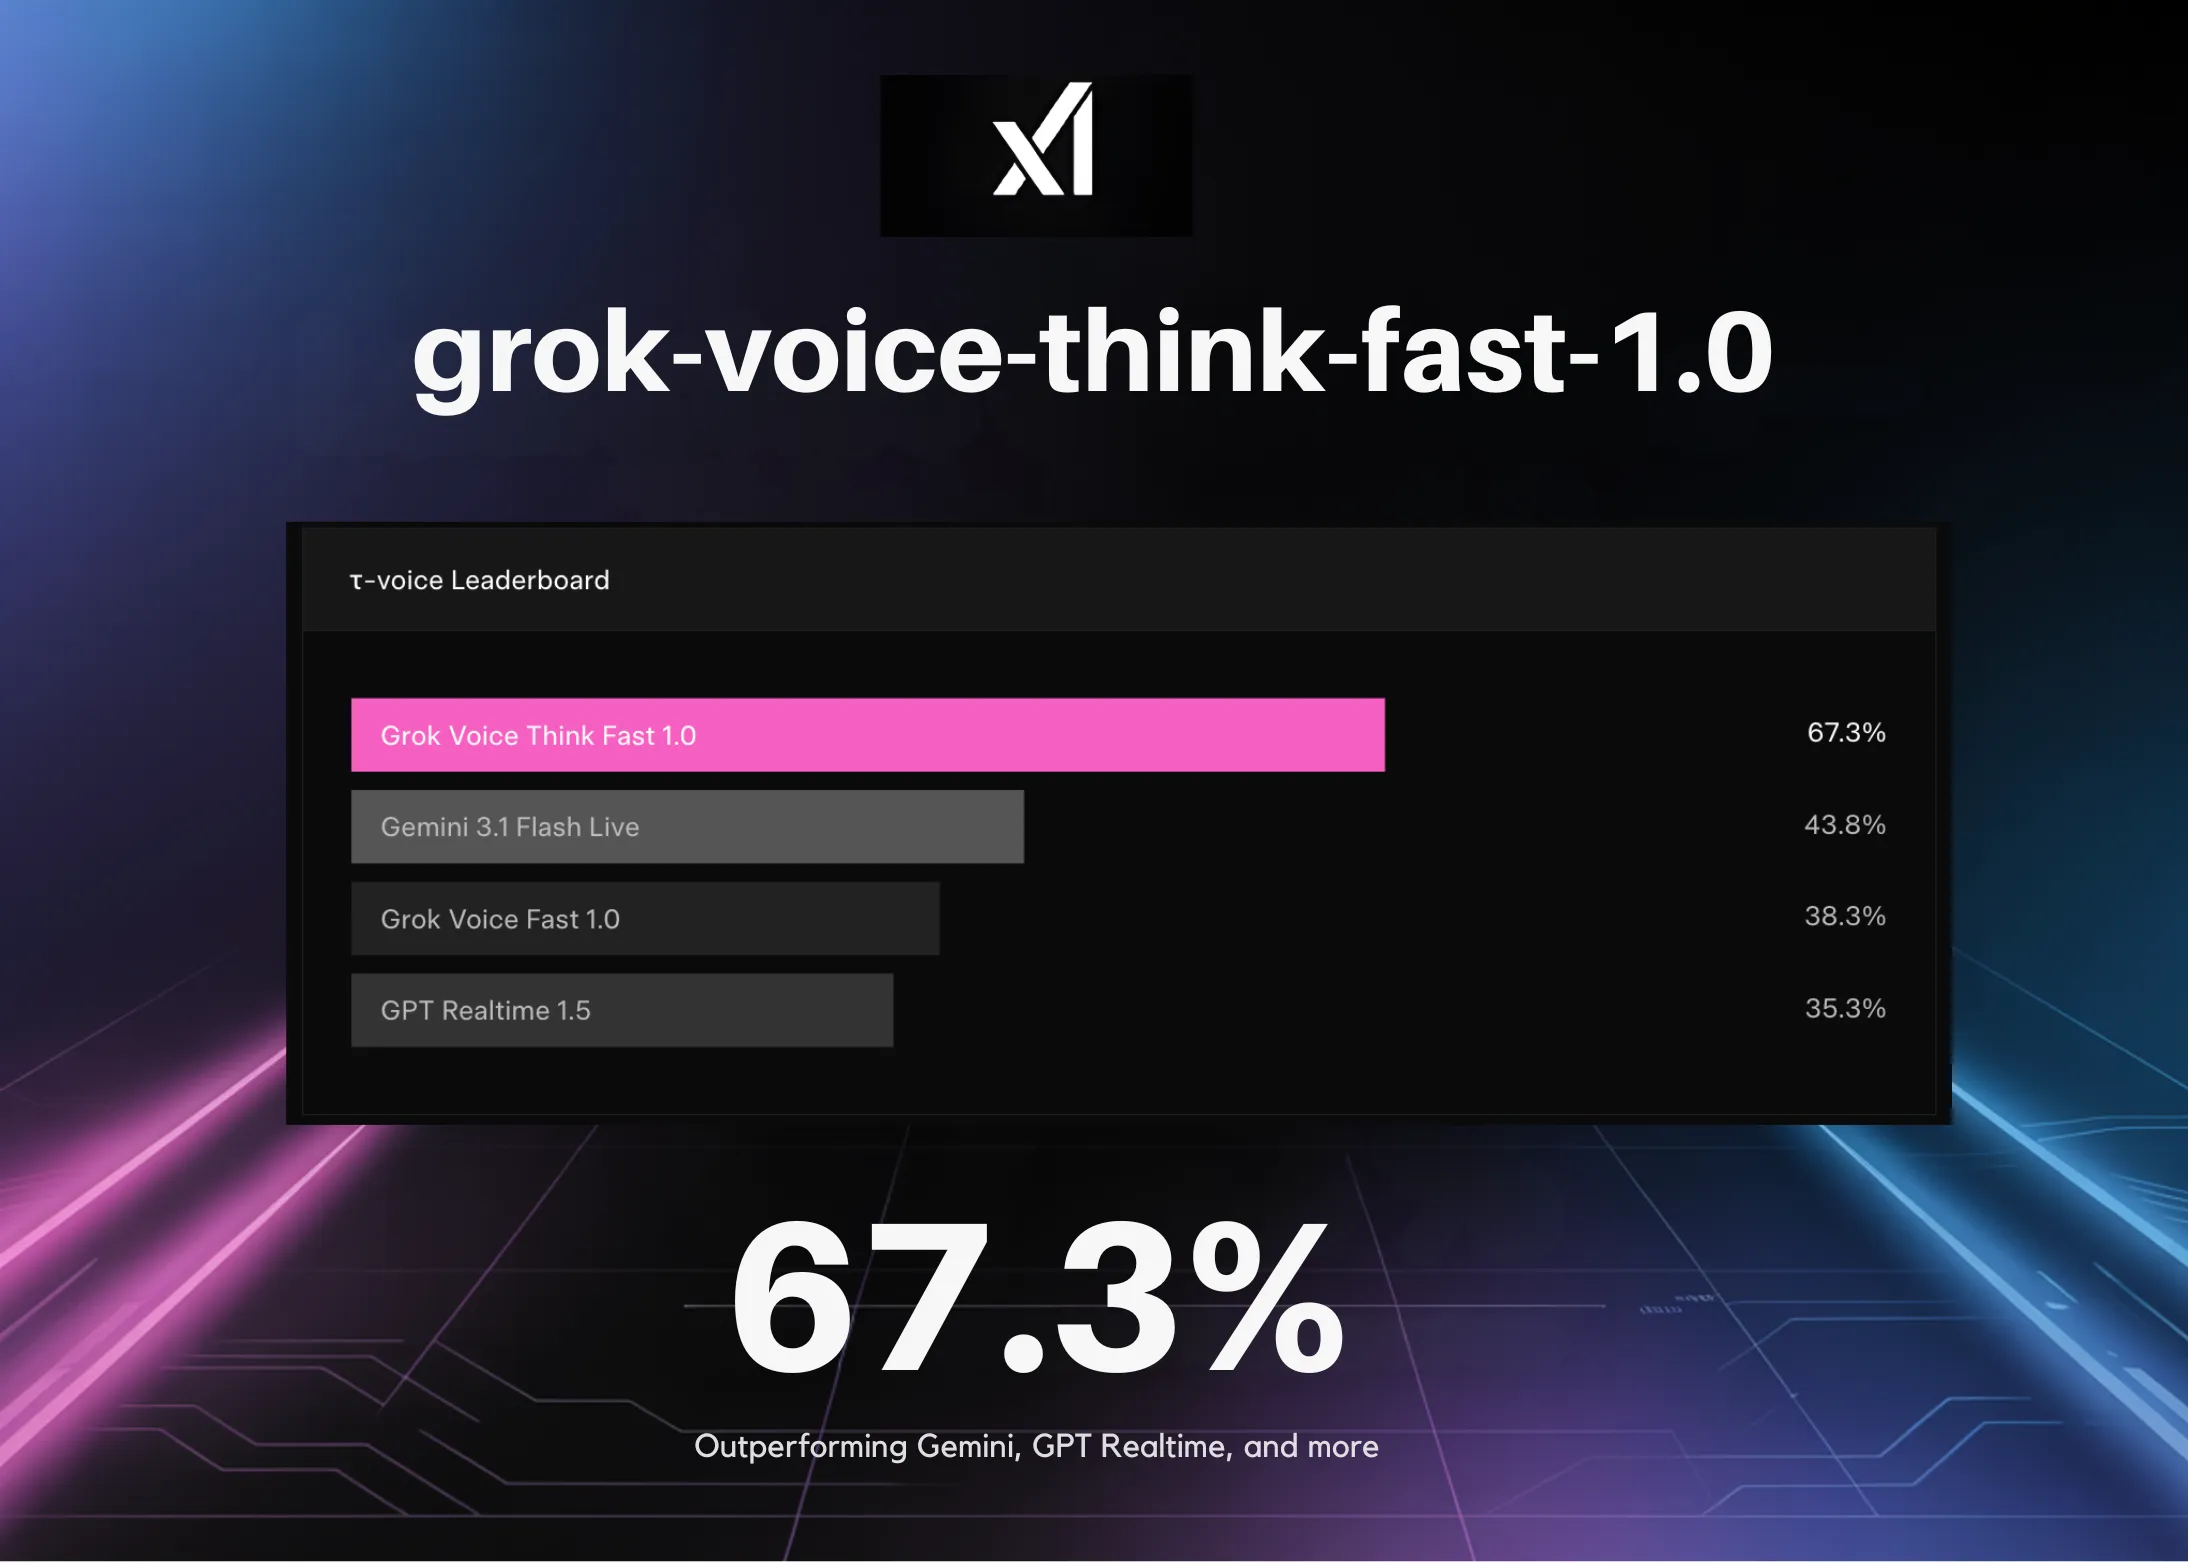
xAI lansează grok-voice-think-fast-1.0: Depășește τ-voice Bench cu 67,3%, surclasând Gemini, GPT Realtime și altele
xAI a lansat grok-voice-think-fast-1.0, un model vocal care a obținut 67,3% pe benchmark-ul τ-voice, depășind Gemini, GPT Realtime și altele. Articolul analizează tehnologia, performanța, aplicațiile și impactul asupra industriei AI.
Tutorial Practic de Programare pentru Microsoft VibeVoice: ASR cu Detectare a Vorbitorului, TTS în Timp Real și Pipeline-uri Speech-to-Speech
Un ghid complet și practic pentru dezvoltatori care doresc să implementeze Microsoft VibeVoice, acoperind recunoașterea vocală cu identificarea vorbitorului, sinteza vocală în timp real și construirea pipeline-urilor speech-to-speech complete.