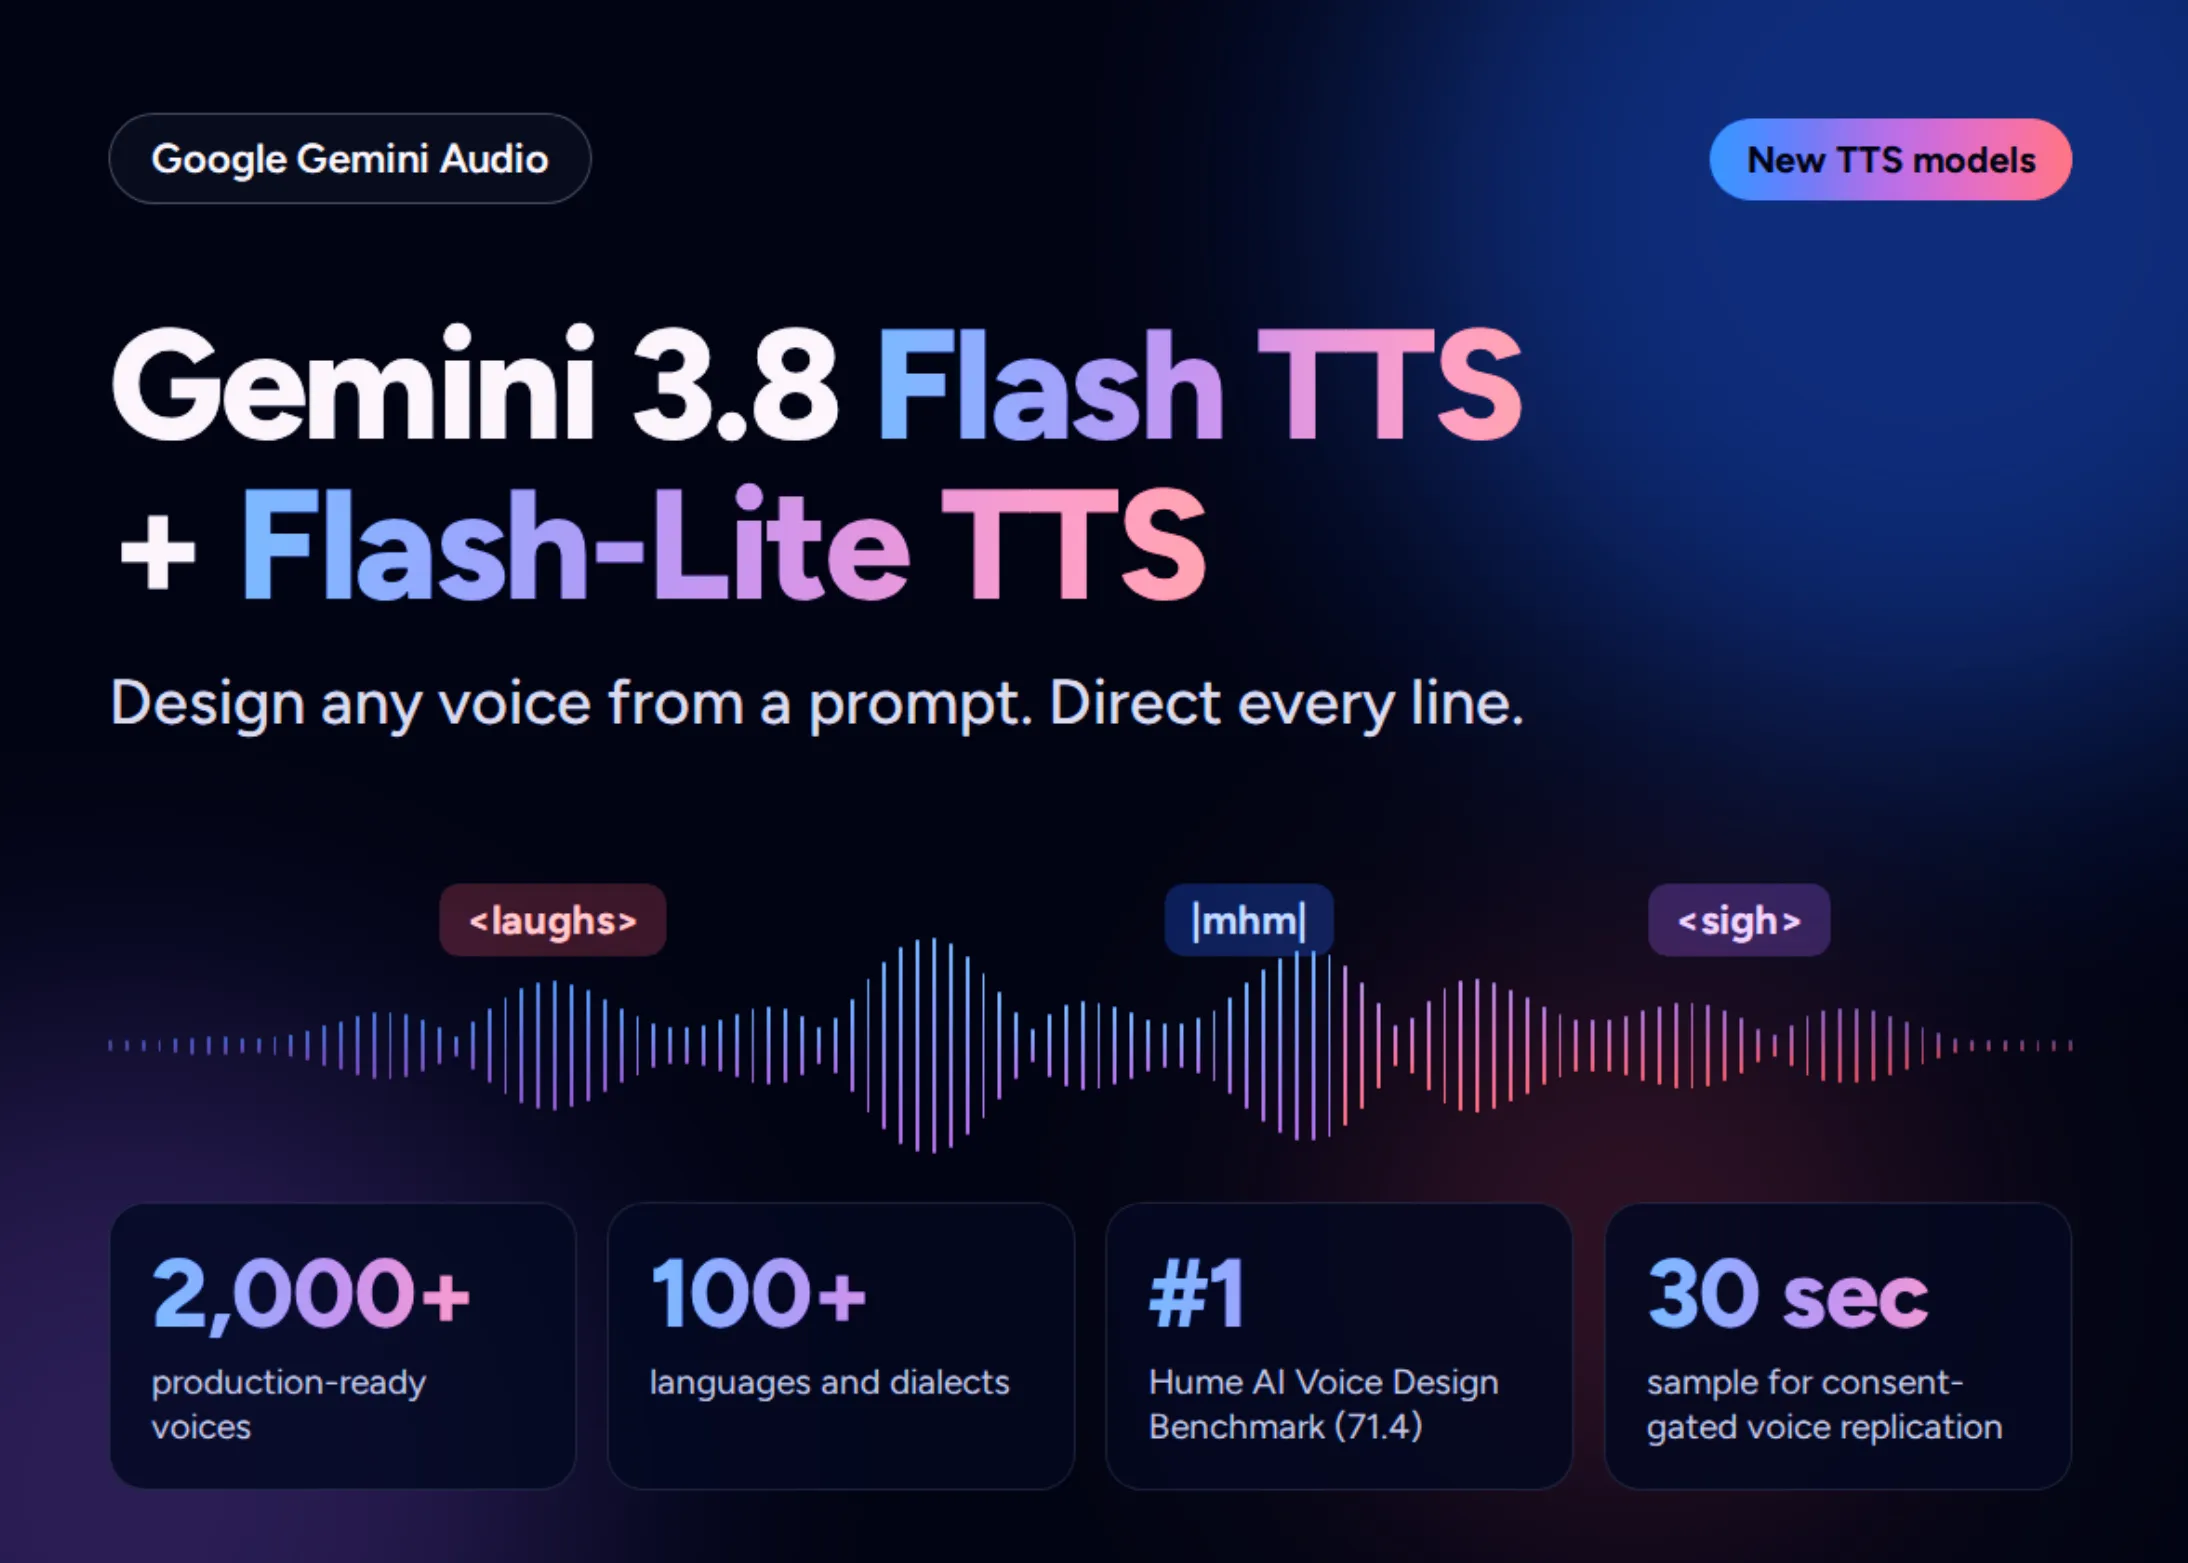
Este genul de anunț care, la prima citire, pare o simplă actualizare de versiune. Dar dacă te uiți mai atent, vezi că Google nu doar îmbunătățește un produs — rescrie felul în care gândim despre vocea sintetică. Până acum, TTS-ul (text-to-speech) era o chestiune de selecție: alege o voce din listă, poate ajustează viteza, poate adaugă o pauză. Acum devine o chestiune de descriere. Vrei o voce de narator de documentare, cu rezonanță joasă și ritm lent? Scrii asta. Vrei o voce veselă de prezentator de podcast, cu accente ușor ironice? Scrii și asta. Vrei o voce de bunic care povestește la gura sobei, cu o urmă de răgușeală? La fel.
Aici intervine diferența dintre cele două modele. Gemini 3.8 Flash TTS este varianta „greie”, cea care își permite să proceseze prompturi complexe, să mențină consistența vocii pe texte lungi și să redea nuanțe fine — emoție, intonație, pauze dramatice. Flash-Lite TTS, în schimb, este versiunea rapidă și ieftină, gândită pentru aplicații care au nevoie de volum: roboți de asistență, citirea notificărilor, generarea de conținut audio la scară mare, unde viteza și costul contează mai mult decât perfecțiunea artistică. Este o împărțire inteligentă, pentru că Google nu încearcă să vândă un singur produs tuturor, ci recunoaște că piața are nevoi diferite.
Ce înseamnă asta, concret, pentru oamenii care lucrează cu vocea? Pentru creatorii de conținut, este o ușurare uriașă. Un podcaster independent care voia să adauge o introducere narată nu mai plătește un actor vocal pentru 30 de secunde. Un dezvoltator de jocuri indie poate genera sute de replici pentru personaje secundare fără să angajeze o echipă întreagă. Un profesor care vrea să transforme cursurile în audiobook-uri poate face asta singur, într-o după-amiază. Bariera de intrare tocmai a scăzut dramatic.
Dar, ca orice tehnologie care democratizează ceva puternic, vine și cu întrebări incomode. Prima este cea a consimțământului. Dacă poți descrie o voce prin prompt, poți descrie și vocea cuiva anume? Google spune că modelele sunt construite cu filtre care blochează imitarea vocilor reale fără permisiune, dar linia dintre „inspirat de” și „copiat după” este, în practică, mult mai fină decât în teorie. A doua întrebare este despre muncă: actorii vocali, care deja trăiesc vremuri grele din cauza clonării vocale, se uită la acest anunț cu îngrijorare justificată. A treia este despre încredere: când orice voce poate fi fabricată din câteva cuvinte, cum mai știi că vorbești cu un om?
Partea fascinantă este că Google pare să fi învățat din greșelile altora. Nu a lansat doar un model mai bun, ci a construit un întreg sistem de control. Promptul devine interfața, iar interfața devine politica de utilizare. Este o mutare tipică pentru companie: în loc să impună reguli rigide, îți dă unelte atât de flexibile încât responsabilitatea cade pe tine. Practic, Google îți spune: „Poți face aproape orice voce. Te rugăm să faci lucruri bune.”
Din punct de vedere tehnic, saltul de la versiunile anterioare este vizibil. Modelele Flash sunt cunoscute pentru latența scăzută, iar faptul că TTS-ul a fost integrat în aceeași familie înseamnă că vocea poate fi generată aproape în timp real, în flux, fără să aștepți randarea unui fișier separat. Asta deschide ușa către aplicații care până acum erau doar teorie: agenți vocali care răspund instant, traducere live cu vocea ta, asistenți care își schimbă tonul în funcție de context. Nu mai vorbim despre voce ca despre un fișier audio, ci despre voce ca despre un comportament.
Și aici este, de fapt, miza reală. Google nu vinde doar un TTS mai bun. Vinde o viziune în care vocea este un strat de interacțiune, la fel de natural ca textul sau imaginea. Gemini 3.8 Flash TTS și Flash-Lite TTS sunt pași concreți spre acea lume în care vorbești cu software-ul, iar software-ul îți răspunde cu o voce pe care ai descris-o în câteva cuvinte. Pentru unii, sună a science-fiction. Pentru alții, sună a luni de muncă economisită. Pentru Google, sună a următorul miliard de utilizatori.
Rămâne de văzut cum vor reacționa concurenții. OpenAI are propriile modele vocale, Amazon are Polly, Microsoft are Azure Speech, iar startup-uri precum ElevenLabs au construit imperii pe vocea sintetică. Dar avantajul Google nu este doar tehnologic — este ecosistemic. Când TTS-ul este integrat direct în Gemini, în Android, în Workspace și în Cloud, nu mai concurezi doar pe calitatea vocii, ci pe cât de ușor este să ajungi la ea. Iar acolo, Google joacă pe teren propriu.
Până una alta, utilizatorii primesc ceva simplu și concret: o unealtă care transformă descrierea în sunet. Iar dacă istoria ultimilor doi ani ne-a învățat ceva, este că atunci când barierele dintre intenție și rezultat dispar, creativitatea explodează. Poate că următorul mare podcast, următorul joc indie sau următorul asistent util nu va fi făcut de o echipă mare, ci de o singură persoană cu o idee bună și un prompt bine scris.
De ce este important:
Anunțul Google despre Gemini 3.8 Flash TTS și Flash-Lite TTS nu este doar o actualizare tehnică, ci un moment de cotitură în felul în care oamenii creează și consumă voce. Designul vocal bazat pe prompt elimină barierele tehnice și financiare care țineau vocea sintetică de calitate în mâinile câtorva specialiști. Acum, oricine poate descrie o voce și o poate obține în câteva secunde, ceea ce democratizează producția audio, dar ridică simultan întrebări serioase despre consimțământ, identitate și viitorul muncii actorilor vocali. Împărțirea între Flash TTS (calitate, nuanță) și Flash-Lite TTS (viteză, cost redus) arată că Google vizează atât creatorii de conținut, cât și aplicațiile la scară industrială. Pe termen lung, această mișcare consolidează poziția Gemini ca platformă completă de interacțiune — text, imagine, video și acum voce — și forțează întreaga industrie să regândească modul în care vocea devine o interfață, nu doar un fișier. Cine controlează vocea sintetică controlează, într-o măsură tot mai mare, modul în care oamenii comunică cu tehnologia. Iar Google tocmai a făcut un pas mare ca să fie în fruntea acestei curse.